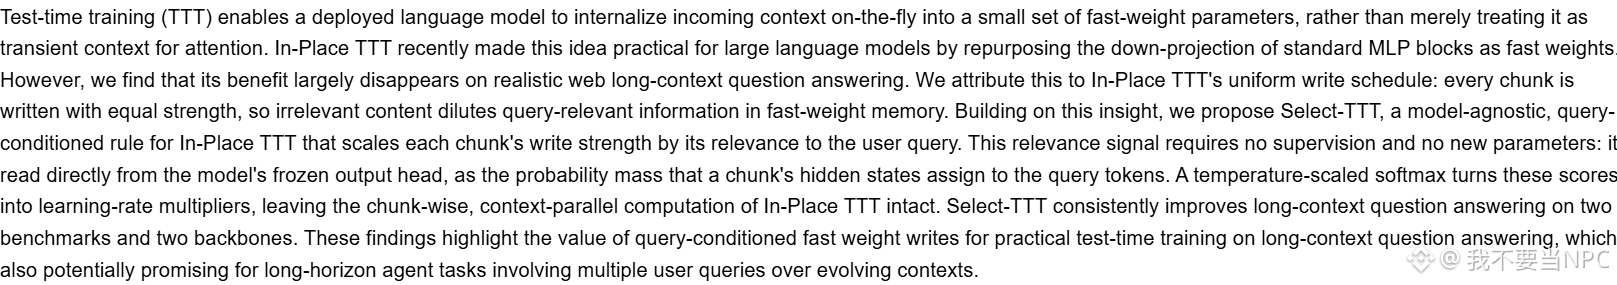
arXiv上这篇 Select-TTT 盯的是长上下文问答里一个很具体的问题:In-Place TTT 把所有文本块用同样的强度写进快参数,结果无关内容把和问题相关的信息冲淡了,作者说在真实的网页长上下文问答上,它原本的好处基本消失。
Select-TTT 的做法是不加参数、不要监督,直接从模型冻结的输出头读信号——看每个块的隐藏状态把多少概率分给了问题里的词,再用带温度的 softmax 换算成学习率倍率,只调写入强度,块并行那套计算不动。在两个基准、两个骨干模型上,长上下文问答都有稳定提升。
预印本,未见同行评审,提升幅度原文摘要没给。做长上下文 RAG 或长任务代理的人,这个思路值得看一眼:问题决定写什么,而不是照单全收。
$BTC
Select-TTT 的做法是不加参数、不要监督,直接从模型冻结的输出头读信号——看每个块的隐藏状态把多少概率分给了问题里的词,再用带温度的 softmax 换算成学习率倍率,只调写入强度,块并行那套计算不动。在两个基准、两个骨干模型上,长上下文问答都有稳定提升。
预印本,未见同行评审,提升幅度原文摘要没给。做长上下文 RAG 或长任务代理的人,这个思路值得看一眼:问题决定写什么,而不是照单全收。
$BTC