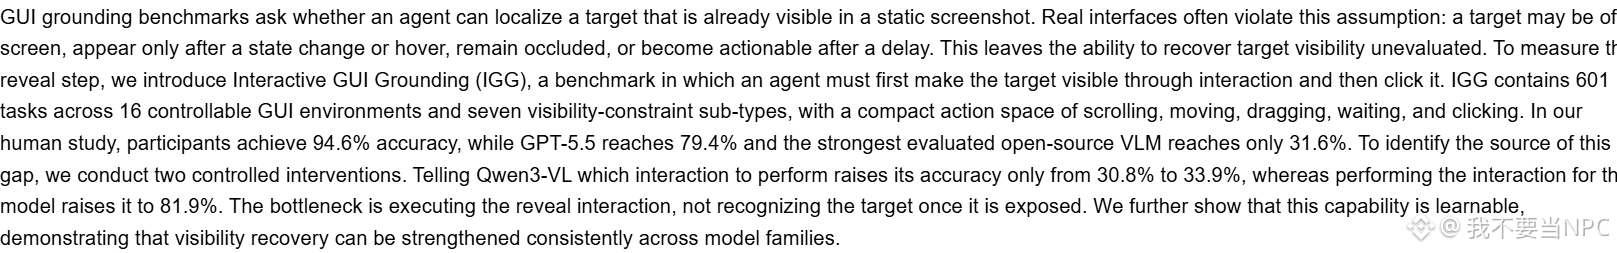
IGG 这个新基准把 GUI 操作里一个常被跳过的步骤单独拎出来了:目标不在当前画面里,得先滚动、悬停、拖动或等待,让它出现,再点。601 个任务,分布在 16 个可交互环境,visibility 约束分七类。
结果挺扎眼。人类参与者准确率 94.6%,GPT-5.5 到 79.4%,被评测的最强开源 VLM 只有 31.6%。
更有意思的是两组对照:告诉 Qwen3-VL 该做哪个交互动作,准确率从 30.8% 只抬到 33.9%;替它把交互做完,直接到 81.9%。卡住的不是“看到目标后认不认得出”,而是“自己把目标弄出来”这一步。
这是 arXiv 预印本,还没经过同行评审,数字先当参考。
$BTC
结果挺扎眼。人类参与者准确率 94.6%,GPT-5.5 到 79.4%,被评测的最强开源 VLM 只有 31.6%。
更有意思的是两组对照:告诉 Qwen3-VL 该做哪个交互动作,准确率从 30.8% 只抬到 33.9%;替它把交互做完,直接到 81.9%。卡住的不是“看到目标后认不认得出”,而是“自己把目标弄出来”这一步。
这是 arXiv 预印本,还没经过同行评审,数字先当参考。
$BTC