

في المقال السابق، اختبرتُ المدة اللازمة لإنشاء إثبات لمعاملة واحدة. وأشار أحدهم إلى أنني اختبرتُ حالة معالجة معاملة واحدة فقط، ولم أختبر ما يحدث عند ورود عدد كبير من المعاملات في الوقت نفسه. فخوادم المؤسسات الحقيقية لا ترتب المعاملات في طابور وتعالجها واحدة تلو الأخرى. لذلك شغّلتُ هذه المرة خدمة إنشاء الإثباتات من Rayls، وجعلتُها تستقبل باستمرار طلبات تتراوح بين طلب واحد و16 طلبًا في الوقت نفسه، على مدى عدة دقائق.
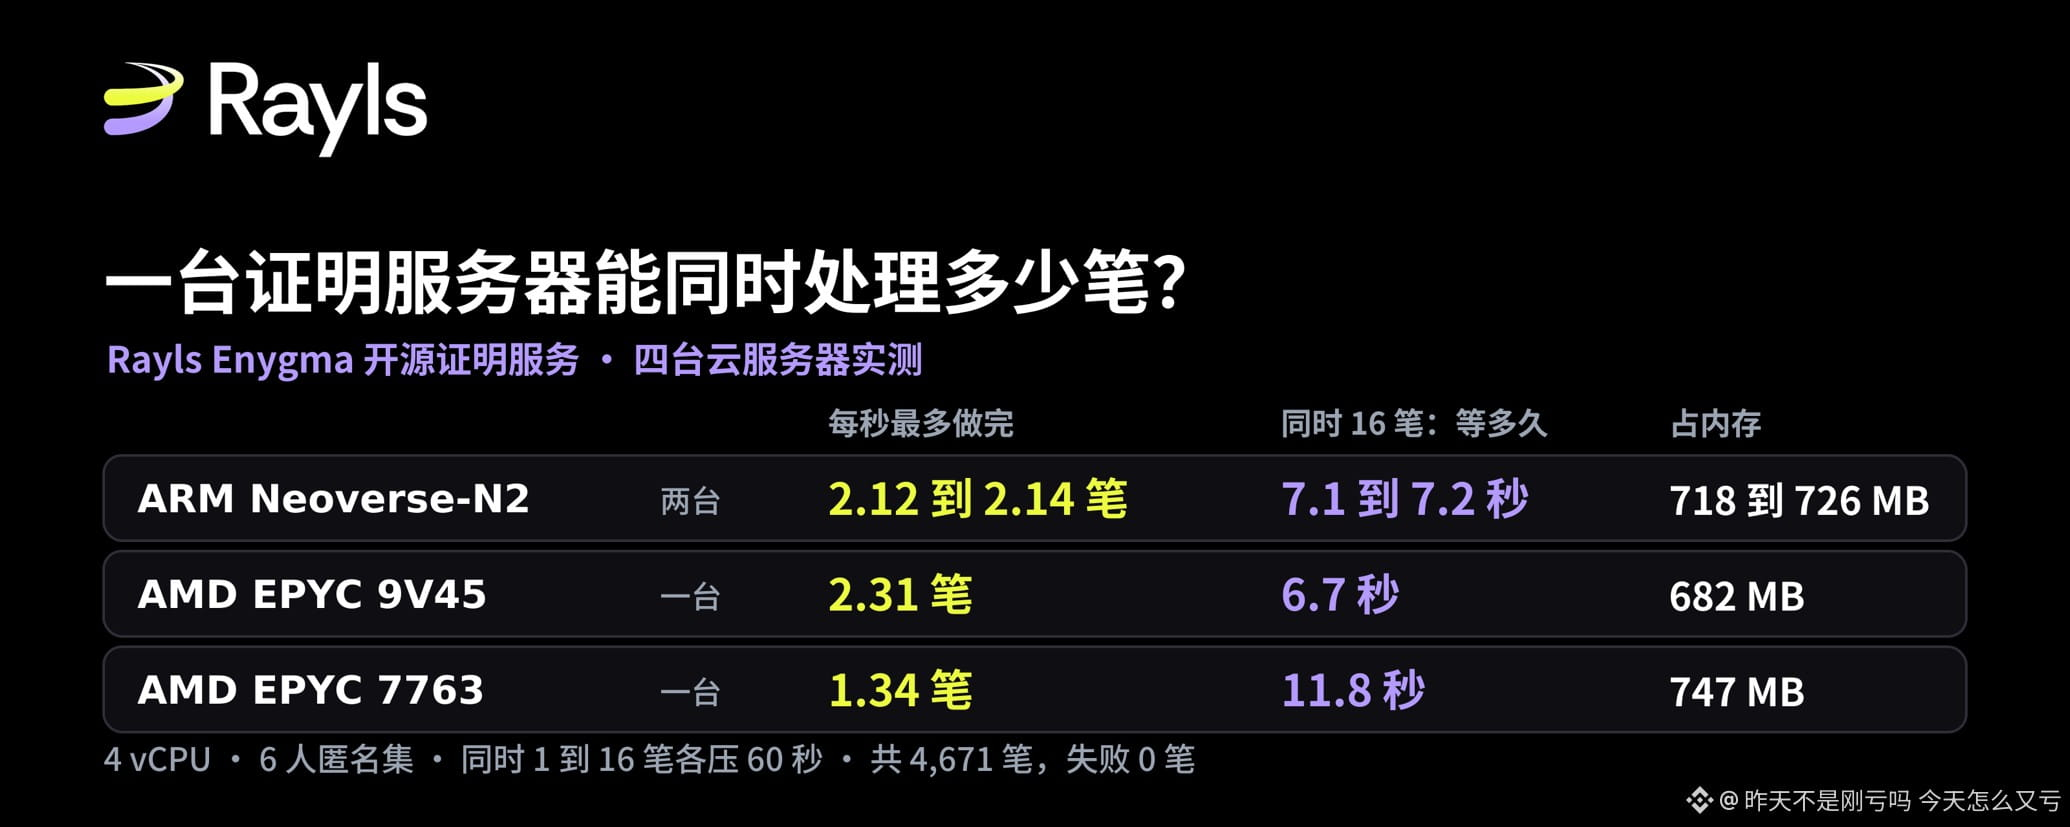
إليكم الإجابة المختصرة أولًا. باستخدام مجموعة إخفاء هوية تضم 6 أشخاص في دائرة تحويلات الخصوصية Enygma من Rayls مثالًا، يستطيع خادم سحابي مزود بـ 4 وحدات vCPU استقبال 16 طلبًا في الوقت نفسه ومعالجتها جميعًا من دون فشل أيٍّ منها، لكنه لا يستطيع إنجاز سوى 1.3 إلى 2.3 معاملة في الثانية. وبعد أن يتجاوز عدد الطلبات قيد المعالجة في الوقت نفسه 2 إلى 4 طلبات، لا تؤدي إضافة مزيد من الطلبات إلى إنجازها بسرعة أكبر، بل تجعل كل معاملة تنتظر مدة أطول وتستهلك ذاكرة أكثر: فعندما تُعالج 16 معاملة في الوقت نفسه، يرتفع زمن الانتظار الوسيط لمعاملة واحدة من 0.5 إلى 0.9 ثانية إلى 6.7 إلى 11.8 ثانية، وترتفع الذاكرة من نحو 260 MB إلى 680–750 MB.
فيما يلي شرح لمصدر هذه الأرقام، وسبب ظهورها بهذا الشكل، وما تعنيه لمؤسسة تستعد لتشغيل إنشاء البراهين بنفسها.
لماذا يهم عدد المعاملات المتزامنة أكثر من سرعة معاملة واحدة
يمكن فهم برهان عديم المعرفة على أنه شهادة رياضية: يستطيع الدافع إثبات صحة المعاملة للشبكة من دون الكشف عن المبلغ أو الطرف المقابل. ويتطلب إنشاء هذه الشهادة قدرًا كبيرًا من عمليات المنحنيات الإهليلجية، وتعتمد هذه العمليات تقريبًا بالكامل على وحدة المعالجة المركزية.
أجابت المقالة السابقة عن المدة اللازمة لحساب برهان واحد. لكن خوادم المؤسسات تتعامل مع دفعات من الطلبات التي تصل في الوقت نفسه. وبالنسبة إلى خدمة تستهلك كامل قدرة وحدة المعالجة المركزية، فإن عدد المعاملات التي تعالجها بالتزامن هو ما يحدد معدل الإنجاز ووقت الانتظار واستهلاك الذاكرة؛ وهذه هي الأمور الثلاثة التي ينبغي احتسابها عند شراء الأجهزة ونشرها.
لا تقتصر هذه المسألة على Rayls. فكل نظام يولّد براهين عديمة المعرفة على خوادمه الخاصة يواجه المفاضلة نفسها؛ والاختلاف يكمن فقط في حجم الدائرة والأجهزة المستخدمة.
كيف أُجري الاختبار، وكيف يمكن لأي شخص إعادة إنتاجه
ما زالت الخدمة الخاضعة للاختبار هي خدمة البراهين مفتوحة المصدر من Rayls، rayls-sovereign-gnark-api، عند الالتزام 67c4c26؛ ولم أغيّر أي سطر من الشيفرة. يوجد كود الاختبار في المستودع العام hansonhan0520-lang/enygma-bench. وهذه المرة أضفت أداة لاختبار الضغط باسم loadgen مكتوبة باستخدام مكتبة Go القياسية فقط، وسكربت run_load.sh. وتشغّلها GitHub Actions تلقائيًا، كما تُحفَظ السجلات تلقائيًا في مجلد results بالمستودع.
كانت طريقة اختبار الضغط كالتالي: شغّلت خدمة HTTP الخاصة ببراهين Rayls كما هي، وجعلت 1 و2 و4 و8 و16 طلبًا تُحسب بالتزامن، مع ضغط متواصل لمدة 60 ثانية لكل مستوى، من دون احتساب أول 5 ثوانٍ المخصصة للإحماء. وسجّلت مدة كل طلب، وقرأت ذاكرة عملية الخدمة مرة كل 0.1 ثانية. ثم جعلت 4 طلبات تُحسب بالتزامن تحت ضغط متواصل لمدة 5 دقائق، وأحصيت النتائج على فترات من 30 ثانية.
تأتي جميع أرقام هذه المرة من تشغيل Actions رقم 39977915567 (23 أكتوبر 2026)، الذي نفّذ الاختبار مرة على كل واحدة من أربع آلات سحابية مستقلة جرى تخصيصها: اثنتان بمعالجات ARM Neoverse-N2، وواحدة بمعالج AMD EPYC 9V45، وواحدة بمعالج AMD EPYC 7763. ضمت كل آلة 4 وحدات vCPU، وبلغ مجموع الطلبات 4,671، ولم يفشل أي منها.
ما الجديد في هذا الاختبار؟ إليك التوضيح. استخدمنا مولّد بيانات الاختبار وقياس زمن المعاملة الواحدة من المقالة السابقة. أما الإضافات في هذه المقالة فهي قياس معدل الإنجاز وزمن الاستجابة عند الذيل واستهلاك الذاكرة للخدمة الفعلية تحت التزامن، والحمل المتواصل لمدة 5 دقائق، وتجربة مقارنة تثبّت استخدام وحدة المعالجة المركزية.
كلما زاد عدد العمليات المتزامنة، انخفضت السرعة؛ لا ترتفع
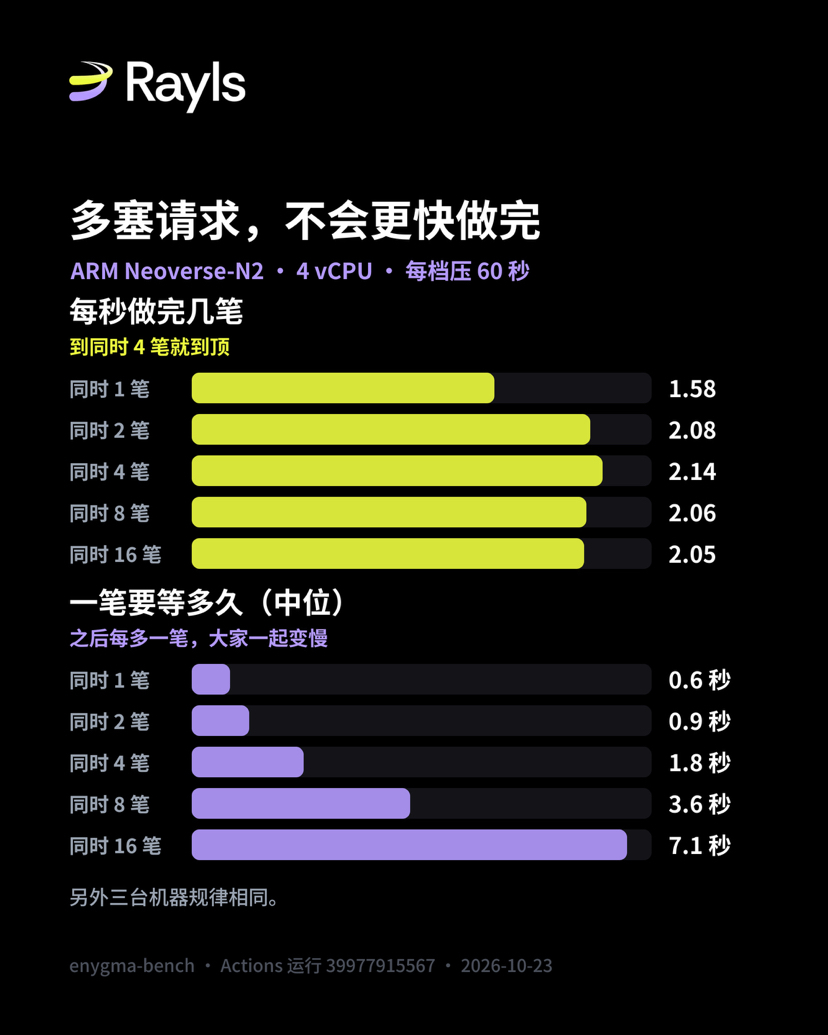
كان النمط متطابقًا تمامًا على الآلات الأربع. عند الانتقال من معاملة واحدة إلى معاملتين قيد المعالجة بالتزامن، يرتفع عدد المعاملات المنجزة في الثانية: بنحو الثلث على N2، وبنحو 18% على 9V45، وبنحو 14% على 7763. ويصل الأداء إلى ذروته عند معالجة 4 معاملات بالتزامن: من 2.12 إلى 2.14 معاملة في الثانية على N2، و2.31 على 9V45، و1.34 على 7763. وعند رفع العدد إلى 16 معاملة، لا يرتفع معدل الإنجاز بل ينخفض، ليصبح أقل من الذروة بنسبة تتراوح بين 4% و10%.
أما وقت الانتظار فيواصل الارتفاع. عند معالجة معاملة واحدة بالتزامن، يتراوح وسيط زمن الطلب بين 0.52 و0.86 ثانية؛ وعند معالجة 16 معاملة بالتزامن، يرتفع إلى ما بين 6.70 و11.81 ثانية، أي ما يعادل 11 إلى 14 ضعفًا. وتنتظر أبطأ 1% من الطلبات ما بين 10.00 و13.91 ثانية.
توضح سجلات الخدمة نفسها أين يذهب وقت الانتظار. تطبع خدمة البراهين لدى Rayls زمن إنشاء البرهان داخليًا لكل طلب. وعند معالجة 16 طلبًا بالتزامن، يقل الفرق بين وسيط هذا الزمن والزمن الإجمالي المقاس من الخارج عن 3%. وهذا يعني أن الطلبات لا تنتظر في طابور عند المدخل، بل يبدأ حسابها فور وصولها؛ إذ تتنافس الطلبات الستة عشر معًا على 4 وحدات vCPU، فيتباطأ الجميع. وتؤكد قراءة الشيفرة ذلك: فالخدمة لا تضع حدًا أقصى للتزامن، بل تُدخل كل طلب مباشرة في مسار إنشاء البرهان.
وراء ذلك قاعدة عامة: في آلة تعمل بكامل طاقتها، يساوي عدد العمليات الجاري حسابها بالتزامن معدل الإنجاز في الثانية مضروبًا في زمن إنجاز كل عملية. وبعد بلوغ الحد الأقصى لمعدل الإنجاز، لا تؤدي إضافة مزيد من الطلبات إلا إلى إطالة زمن إنجازها.
كل طلب إضافي قيد المعالجة يستهلك نحو 30 MB من الذاكرة
بعد تشغيل الخدمة وتحميل مفتاح البراهين لإعداد 6 أشخاص، تراوح استهلاكها في وضع الخمول بين 210 و217 MB. وكلما زاد عدد الطلبات قيد المعالجة بالتزامن، ارتفع استهلاك الذاكرة: فقد بلغ الحد الأقصى 682 إلى 747 MB عند معالجة 16 طلبًا بالتزامن، أي إن كل طلب إضافي قيد المعالجة يستهلك نحو 28 إلى 32 MB. لا يشكل هذا مشكلة لآلة مزودة بـ 4 vCPU وذاكرة 16 GB، لكن إذا قفز عدد الطلبات فجأة من دون وجود حد أقصى، فستزداد الذاكرة خطيًا مع عددها.
لم يتباطأ الأداء خلال 5 دقائق متواصلة
أبقيت 4 طلبات قيد المعالجة بالتزامن تحت ضغط متواصل لمدة 5 دقائق، وأحصيت النتائج كل 30 ثانية. بقي معدل الإنجاز في كل فترة على الآلات الأربع ضمن 7% زيادة أو نقصانًا من متوسط كل آلة: بين 2.03 و2.23 معاملة في الثانية على جهازي N2، وبين 2.13 و2.37 على 9V45، وبين 1.30 و1.43 على 7763. واستقر الحد الأقصى لاستهلاك الذاكرة بين 421 و505 MB، من دون أي مؤشر على ارتفاع مستمر، ولم يفشل أي طلب خلال الاختبار.
حوّلت استنتاج المقالة السابقة هذه المرة إلى تجربة مقارنة
في المقالة السابقة، لاحظت أن زيادة عدد وحدات vCPU في آلة Intel من 2 إلى 4 لم تجعلها أسرع إلا بمقدار 1.17 مرة، وعزوت ذلك إلى ما عرضه lscpu من أن «نواةً واحدة تشغّل خيطين». وأشار أحد المراجعين إلى أن الخوادم السحابية آلات افتراضية، وأن عدد الأنوية الظاهر لا يثبت كيفية تخصيص الأجهزة الأساسية؛ لذا لم يكن ذلك التفسير سوى استنتاج.
استخدمت هذه المرة taskset لتثبيت برنامج البراهين على وحدات CPU محددة، وقارنت على الآلة نفسها بين تشكيلتين لوحدتي CPU: إما وحدتا CPU تمثلان خيطين على النواة نفسها، أو وحدتا CPU موزعتان على نواتين مختلفتين. ونفّذت ثلاث جولات بترتيب متناوب لتجنب الانحياز الناتج عن تغير حالة الآلة بمرور الوقت. وكانت النتائج متطابقة في كل جولة على جهازي AMD: لم يكن الخيطان على النواة نفسها أسرع من وحدة CPU واحدة إلا بمقدار 1.10 إلى 1.18 مرة، بينما كان استخدام نواتين مختلفتين أسرع بمقدار 1.53 إلى 1.57 مرة. وعلى N2، الذي لا يدعم تعدد الخيوط المتزامن، كانت وحدتا CPU أسرع بمقدار 1.49 إلى 1.58 مرة.
لذلك أصبح تفسير أن «تعدد الخيوط يجعل وحدتي vCPU الثالثة والرابعة أقل فائدة» مدعومًا الآن بنتائج مقارنة على الآلة نفسها. لكن ينبغي توضيح حدود ذلك: ما زلنا نرى طوبولوجيا الآلة الافتراضية فقط، ولا يمكنني معرفة كيفية تخصيص المضيف للأنوية الفعلية.
وثمة نقطة أخرى تستحق التوضيح. كانت الزيادة بنحو 1.5 مرة عند التثبيت على وحدتي CPU أقل من الزيادة بنحو 1.9 مرة في المقالة السابقة، حين لم أثبّت وحدات CPU واكتفيت بتقييد Go باستخدام خيطين. ومن التفسيرات المحتملة أن الخيوط الأخرى التي تعمل في الخلفية للبرنامج استطاعت استخدام وحدتي CPU الإضافيتين عند عدم تثبيته؛ لكنني لم أختبر ذلك على نحو مستقل. لذا تصلح أرقام تثبيت وحدات CPU لمقارنة الظروف المختلفة، ولا ينبغي اعتبارها مقياسًا للقدرة الإنتاجية.
ما الذي يعنيه هذا لمؤسسة تستعد لتشغيل إنشاء البراهين بنفسها؟
هذا القسم استنتاج، وليس قياسًا.
أولًا، ضع حدًا أقصى للتزامن في خدمة البراهين، على أن يكون قريبًا من عدد وحدات CPU، واجعل الطلبات الزائدة تنتظر في طابور. يبلغ معدل الإنجاز ذروته أصلًا عند وجود 2 إلى 4 معاملات قيد المعالجة، والطلبات التي تتجاوز هذا الحد لن تؤدي إلا إلى إبطاء كل معاملة قيد الحساب وزيادة استهلاك الذاكرة. لم أختبر في هذه المرة نسخةً تضيف هذا الحد؛ لذا يظل مقدار التحسن الذي قد يحققه تنظيم الطلبات في الطابور لزمن الاستجابة عند الذيل سؤالًا يحتاج إلى التحقق.
ثانيًا، قِس معدل الإنجاز على الأجهزة الفعلية بدلًا من الاعتماد على اسم طراز الآلة. في هذا الاختبار، كان كلا المشغّلين من GitHub بمعمارية x64 و4 وحدات vCPU، لكن الآلة المخصصة بمعالج AMD EPYC 9V45 أنجزت 2.31 معاملة في الثانية، مقابل 1.34 فقط للآلة المخصصة بمعالج AMD EPYC 7763؛ أي بفارق يزيد على 40%.
ثالثًا، قدّر عدد الآلات بناءً على معدل الإنجاز، لا زمن المعاملة الواحدة. استخدمت المقالة السابقة زمن المعاملة الواحدة لتقدير أن آلة واحدة مزودة بـ 4 vCPU تنجز نحو 1.41 إلى 1.58 معاملة في الثانية. أما في هذا الاختبار، فبلغ معدل الإنجاز المقاس على مدى 5 دقائق مع 4 معاملات قيد المعالجة بالتزامن 2.15 إلى 2.29 معاملة في الثانية على N2 و9V45، و1.35 على 7763. وبالنسبة إلى N2 مثلًا، فهذا أعلى بنحو 36% من تقدير المقالة السابقة، البالغ 1.58 معاملة في الثانية.
باستخدام هذا الرقم لإعادة الحساب لبريطانيا CHAPS: بلغ المتوسط اليومي في السنة المالية 2025 نحو 210,483 معاملة. وعند توزيعها على نافذة التسوية اليومية في أيام العمل، من 06:00 إلى 18:00، يصبح المعدل نحو 4.87 معاملة في الثانية، ما يتطلب 2.1 إلى 3.6 من هذه الآلات. أما نظام Fedwire الأمريكي، فبلغ متوسطه اليومي في 2025 نحو 869,187 معاملة؛ وباحتساب 22 ساعة تشغيل يوميًا، يصبح المعدل نحو 10.97 معاملة في الثانية، ما يتطلب 4.8 إلى 8.1 آلة. هذا مجرد تقدير من الدرجة الأولى لقدرة توليد البراهين، وليس معدل إنجاز التسويات لدى Rayls. كما أنه لا يأخذ في الحسبان ذروة النشاط خلال اليوم، أو أعباء دفتر الأستاذ والمرحّلات. فضلًا عن ذلك، تتولى كل مؤسسة مُبادِرة للتحويل توليد البراهين بنفسها، لذا فإن الحمل موزع أصلًا بين المؤسسات.
ما لم يُحسم بعد
اختبر هذا العمل دائرة تحويلات لمجموعة مجهولة من 6 أشخاص فقط؛ ولم يختبر دوائر الإيداع والسحب وDvP. كما اختبر خدمة البراهين لدى Rayls بحد ذاتها، لا عملية التسوية الكاملة لدى Rayls، التي تشمل أيضًا دفاتر الأستاذ والمرحّلات ومراكز الشبكات الخاصة لدى المؤسسات؛ وهذه العناصر لا تدخل ضمن نطاق ما يمكن تشغيله باستخدام الشيفرة المتاحة للعامة. كانت الآلات الأربع خوادم سحابية افتراضية مشتركة، لا خوادم فعلية ولا بيئة إنتاج Rayls. واستخدمت إدارة الذاكرة في Go الإعدادات الافتراضية، وقد يختلف منحنى الذاكرة بعد ضبطها. لم أجد في المواد المنشورة معلومات عن إعدادات الأجهزة والتزامن في بيئة إنتاج Rayls.
رأيي
يمكن لخادم سحابي عادي مزود بـ 4 vCPU استقبال أكثر من عشرة طلبات براهين عديمة المعرفة في الوقت نفسه من دون أخطاء، كما يمكنه مواصلة العمل بإنتاج مستقر لدقائق عدة. لكن قدرته لها حد أقصى واضح، يقارب معاملة واحدة إلى أكثر قليلًا من معاملتين في الثانية. وبعد تجاوز هذا الحد، لا تؤدي الطلبات الإضافية إلا إلى زيادة مدة الانتظار واستهلاك الذاكرة.
معيار التحقق بسيط: يمكن لأي شخص تشغيل enygma-load من صفحة Actions في مستودع enygma-bench، والتحقق مما إذا كان معدل الإنجاز على الآلة المخصصة له يبلغ الحد الأقصى أيضًا عندما تكون 2 إلى 4 معاملات قيد المعالجة بالتزامن. وإذا أعلنت Rayls مستقبلًا عن إعدادات خدمة البراهين في بيئة الإنتاج، مثل تحديدها حدًا أقصى للتزامن أو نوع الأجهزة المستخدمة، فيمكن مقارنة النتائج مباشرة بهذا الاختبار.
المصادر المرجعية:
الشيفرة المصدرية لخدمة البراهين لدى Rayls، raylsnetwork/rayls-sovereign-gnark-api، الالتزام 67c4c26 (20 أغسطس 2026): https://github.com/raylsnetwork/rayls-sovereign-gnark-api/commit/67c4c26696016b48e70950e284ae1a51b7d0cf0e
شيفرة اختبار الضغط لهذه المقالة وسجلاته الكاملة، تشغيل Actions رقم 39977915567 (23 أكتوبر 2026): https://github.com/hansonhan0520-lang/enygma-bench
اختبار المعاملة الواحدة في المقالة السابقة وسجلاته، تشغيل Actions رقم 37741247183 (8 أكتوبر 2026): https://github.com/hansonhan0520-lang/enygma-bench
مواصفات مشغّلات GitHub المستضافة (اطّلعت عليها في 8 أكتوبر 2026): https://docs.github.com/en/actions/reference/runners/github-hosted-runners
إحصاءات Fedwire Funds لعام 2025 (حُدّثت الصفحة في 26 يناير 2026): https://www.frbservices.org/resources/financial-services/wires/volume-value-stats/annual-stats.html
إحصاءات المدفوعات والتسويات لدى بنك إنجلترا، متوسط معاملات CHAPS اليومي للسنة المالية 2025: https://www.bankofengland.co.uk/payment-and-settlement/payment-and-settlement-statistics
#Rayls $RLS #براهين_عديمة_المعرفة