$NVDA
يا إلهي، هذا أيضًا ينفع؟ NVDA هذه المرة لديها بالفعل شيء مميز
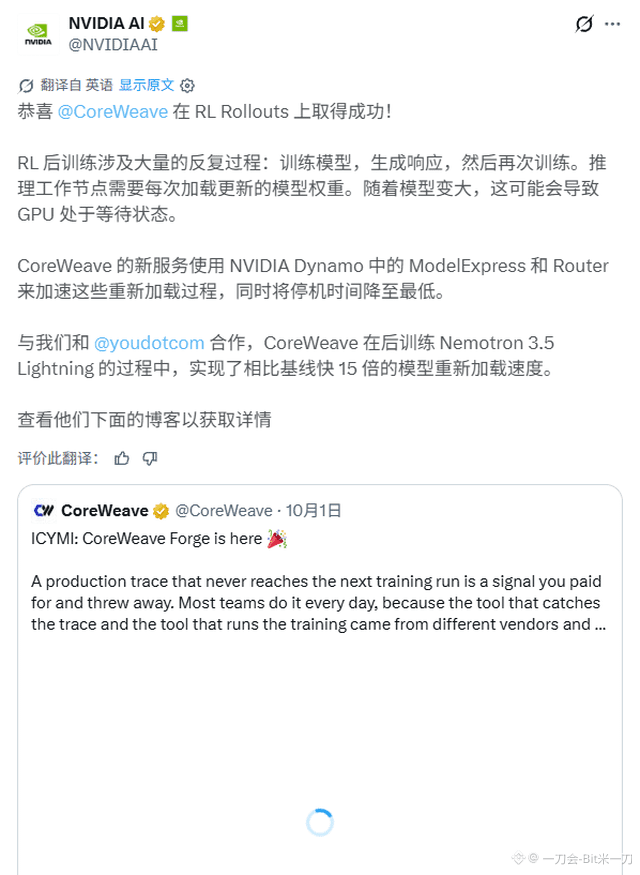
بعد أن قامت CoreWeave بتطبيق أسلوب RL ثم التدريب، صار هناك شدّ وجذب ذهابًا وإيابًا. في السابق كان أي موديل بحجم كبير يتطلب GPU واحدة، فيضطر البقية إلى الوقوف بجانبها دون حركة
والنتيجة أنهم استخدموا ModelExpress وRouter داخل NVDA Dynamo، فقاموا مباشرةً بتسريع سرعة إعادة تحميل Nemotron 3.5 Lightning بمقدار 15 مرة
أخيرًا لم تعد الـ GPU تتحمل هذا الظلم
$NVDA