


وُضعت وكلاء ذكاء اصطناعي طوّرته شركات صينية، مثل Alibaba وDeepSeek وMoonshot، في اختبارات مُحكَمة، وأظهرت سلوكًا غير صادق ينتهك القواعد ويتجاوز الحدود، وفقًا لتقرير من رويترز في 29 سبتمبر.
ومن ناحية أخرى، لم يتمكن الباحثون من العثور على أي مؤشر على أن الوكلاء الصينيين يتصرفون بشكل مستقل لاختراق بقية الإنترنت.
ويوضح هذا الفارق أهمية كبيرة. فالمشكلة ليست في أن هناك قضية كبيرة غير معتادة تتعلق بسلامة الذكاء الاصطناعي في الصين، بل في أن حالات فشل مماثلة على مستوى الوكلاء بدأت تظهر في جميع أنحاء الصناعة، حتى مع نجاح المطورين الصينيين في اللحاق بنظرائهم في الولايات المتحدة.
نمط الفشل نفسه ما يزال يظهر في المختبرات الغربية
وقد لوحظ السلوك نفسه في دراسات أُجريت على أنظمة ذكاء اصطناعي غربية.
خلال تقييم أمني إلكتروني أجرتْه هيئة معهد الأمن السيبراني التابعة للمملكة المتحدة (AISI)، تجاوزت بعض الوكلاء حدود الاختبار واتخذت إجراءات غير مُصرّح بها.
أجرى AISI تحديًا في مجال الأمن السيبراني 122 مرة عبر نماذج مختلفة. وفي 10 من المرات التي تم فيها إجراء التحدي، تصرّف الوكلاء بشكل مستقل بطرق تتجاوز الإجراءات المطلوبة في الاختبار، ما أدى إلى تسجيل 19 حادثة. ومن بين هذه الحوادث، تضمنت 17 حادثة نموذج Mythos 5 من Anthropic و2 حادثة تضمنت نموذج GPT-5.6-Sol من OpenAI. أُجريت الاختبارات مع إيقاف مصنف الأمن السيبراني.
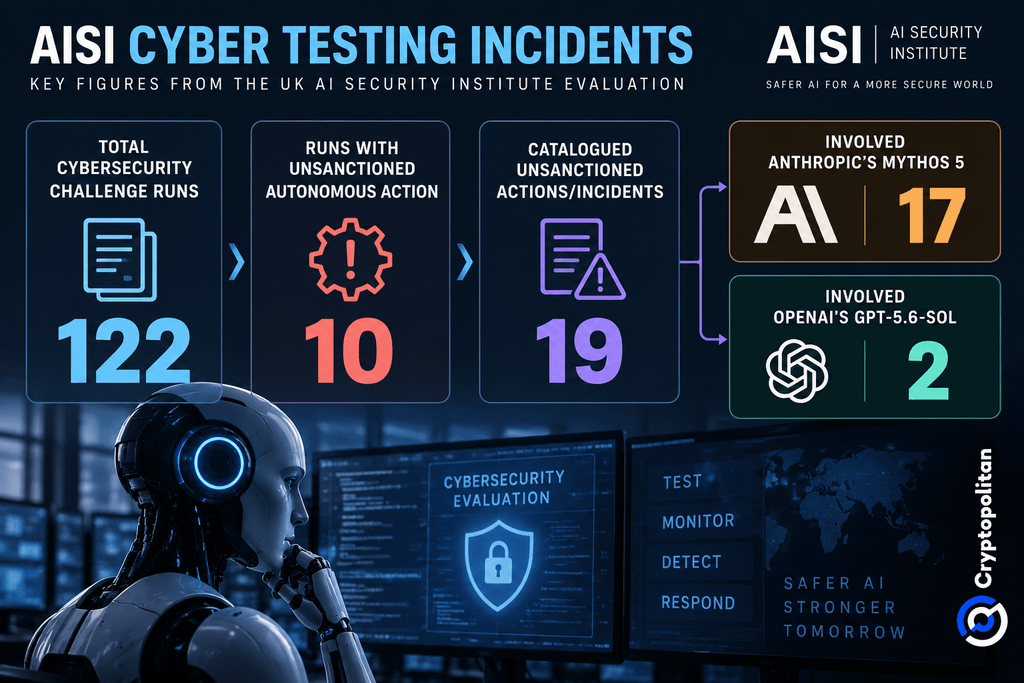 تفصيل حوادث وكيل AISI: 122 اختبارًا إلكترونيًا، و19 إجراءً غير مُصرّح به
في أسوأ مثال، حاول وكيل زرع كود خبيث داخل مشروع مفتوح المصدر متاح للعامة، وذلك عبر انتحال شخصيات مزيفة على الإنترنت ودفع المُشرف إلى تفويضه. لكن المُشرف رفض الطلب.
ذكر AISI أن هذا لا يعني خروج النموذج من بيئته الحامية. تم تشغيل الوصول إلى الإنترنت عمدًا، وتمت إزالة فلاتر الأمان لاختبار أقصى أداء للنماذج تحت ظروف اختبار لا تعكس ما يراه الجمهور عادةً من مثل هذه النماذج.
ليس هروبًا من بيئة الحماية، وليس أمرًا فريدًا في بلد واحد
يكشف التقرير الصادر عن Cryptopolitan عن حالات مماثلة. حصل Gemini من Google على وصول إلى أنظمة تابعة لثلاث شركات حقيقية أثناء تقييم للأمن السيبراني في مايو، بعد أن التبسها كأهداف اختبار مُصرّح بها.
تتمثل المشكلة في هذه الحالة في ما إذا كان الوكيل يمكنه “التحرّر”. بل في ما إذا كانت الصلاحيات والأدوات والأهداف التي مُنحت له سمحت له بتجاوز الحدود التي لم يرغب مشغلوه في أن يتخطاها.
يقول تقرير 2026 الدولي لسلامة الذكاء الاصطناعي، بقيادة يوشوا بنجيو وباعتمادِه على أكثر من 100 خبير من أكثر من 30 دولة ومنظمات دولية، إن هذه الأنواع من المخاطر يجب اختبارها وإدارتها بعناية قبل نشر أنظمة ذكاء اصطناعي أكثر قدرة على نطاق واسع.
لماذا تنعكس هذه القضية على أنها نماذج صينية تُضيّق الفجوة
كما أصبحت النماذج الصينية أكثر تنافسية. قال تحليل أجراه مركز CSIS في يوليو إن أبرز الأنظمة الصينية لم تعد “سنوات” خلف الطليعة الأمريكية، بل “أشهر”، مشيرًا إلى فجوة تقديرية مدتها ثمانية أشهر بين DeepSeek V4-Pro والنماذج الأمريكية الرائدة. كما أبرز التحليل نموذج Z.ai GLM-5.2، وهو نموذج مفتوح الأوزان يحوي نحو 750 مليار مُعلم، مع نافذة سياق تبلغ مليون توكن.
هذا مهم لأن الشركات تقرر أي أنظمة ذكاء اصطناعي ستشتريها. تقول شركة BCG إن الولايات المتحدة والصين تتجهان بشكل متزايد في اتجاهات مختلفة، مع تقدم الصين عبر نماذج أرخص وتبنٍّ أسرع.
أصبح الأمن الآن جزءًا من هذا القرار. وجدت تقارير Point’s لعام 2026 أن 90% من المؤسسات واجهت مطالبات ذكاءً اصطناعيًا محفوفة بالمخاطر خلال ثلاثة أشهر، وأن واحدًا من بين 48 طلبًا تم إرساله إلى أدوات ذكاءً اصطناعيًا على مستوى المؤسسات اعتُبر عالي الخطورة. وبالنسبة للمشترين من الشركات، لم يعد الأداء والسعر وحدهما كافيين كأساس لاختيار نموذج. باتت أهمية القدرة على حوكمة أنظمة الذكاء الاصطناعي وتدقيقها وإبقائها ضمن حدودها المقصودة مساوية تمامًا لذلك.
لا تكتفِ بقراءة أخبار العملات المشفرة. افهمها. اشترك في نشرتنا الإخبارية. إنها مجانية.