
لا يزال معظم حديث المحادثة في Render يدور حول الطلب على الذكاء الاصطناعي ووحدات معالجة الرسومات، لكن أعتقد أن الجزء الأكثر إثارة للاهتمام يحدث داخل نموذج التوكن نفسه.
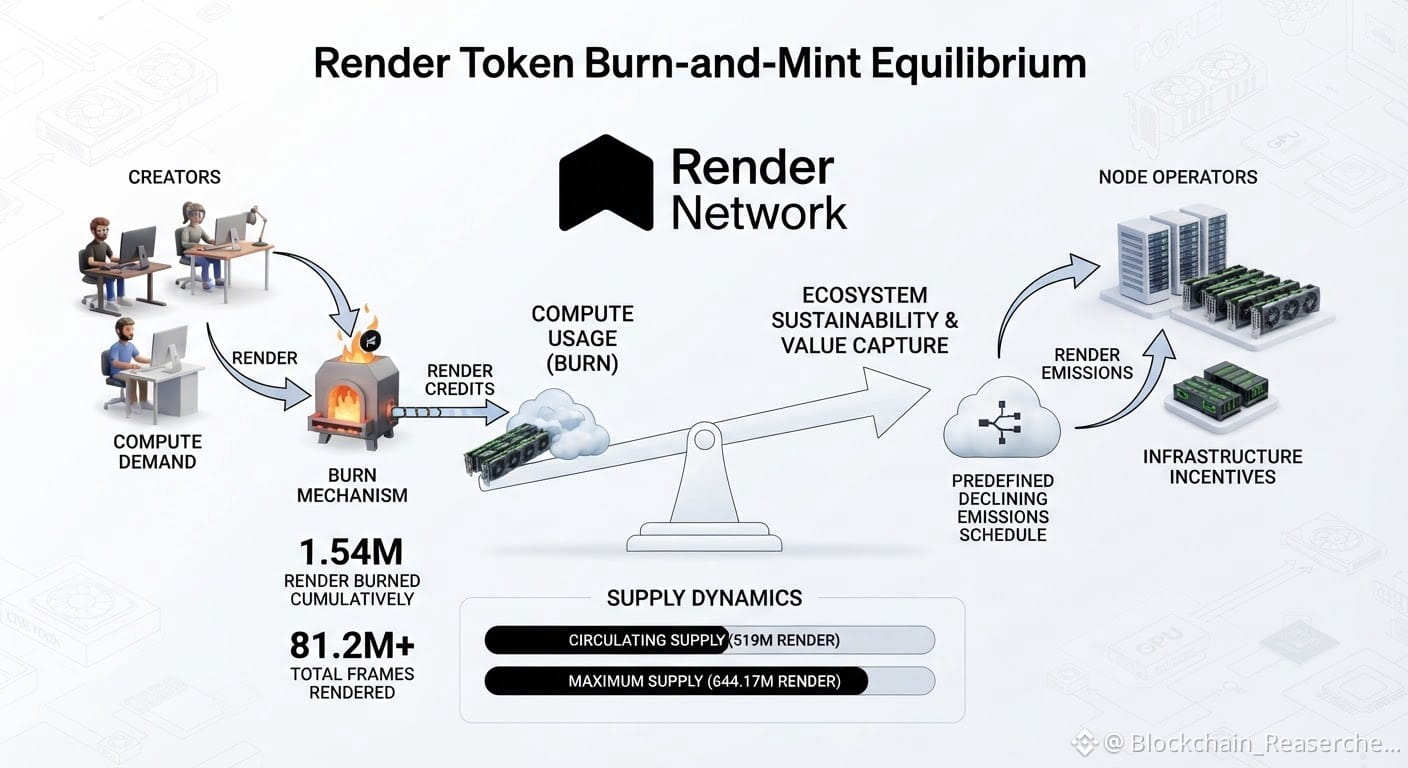
تستخدم RENDER توازنًا بين الحرق والـMint: يدفع منشئو المحتوى ثمن الحوسبة عبر حرق RENDER مقابل Render Credits، بينما يتلقى مشغلو العقد انبعاثات RENDER مقابل توفير طاقة GPU. بمعنى آخر، يتم ربط الطلب الفعلي على الشبكة والحوافز المتعلقة بالبنية التحتية عبر التوكن.
والحجم يستحق التدقيق.
حاليًا، يعرض لوح Render الرسمي 81.2 مليون+ إطار مُقدَّم إجمالًا و5,600 عقدة منذ البدء، مع حرق تراكمي بلغ 1.54 مليون RENDER.
وهذا يخلق تمييزًا مهمًا.
لا يعني وجود شبكة كبيرة من وحدات GPU تلقائيًا وجود طلب قوي على التوكن. السؤال الاقتصادي هو: كم مقدار الاستخدام الفعلي للحوسبة الذي يتم تحويله إلى عمليات حرق تَوكن مقارنةً بالانبعاثات المطلوبة لإبقاء مورّدي الـGPU مشارِكين.
وهذا أيضًا سبب عدم اعتباري العنوان الرئيسي «حوسبة الذكاء الاصطناعي آخذة في النمو» كطرح كامل لفكرة RENDER.
هناك بالفعل استخدام حقيقي للبنية التحتية، لكن قدرة التوكن على التقاط القيمة ما زالت تعتمد على التوازن بين طلب الحوسبة، وعمليات الحرق، والانبعاثات. يصف البروتوكول نفسه الانبعاثات كجدول محدد للتناقص مسبقًا، بينما تحدد استخدام الشبكة جانب الحرق في المعادلة.
تفصيلة أخرى لفتت انتباهي: تعرض متتبعات الأسواق العامة حاليًا حوالي 519 مليون RENDER متداولة مقابل 644.17 مليون كإجمالي المعروض الأقصى، بينما يستخدم لوح Render الرسمي طريقة مختلفة لحساب المعروض المتداول.
لذلك، ليس السؤال الذي سأراقبه هو فقط «هل Render ينمو؟»
بل هو: هل ينمو الطلب على الحوسبة الفعلية بسرعة كافية لجعل جانب الحرق في RENDER أكثر أهمية مقارنةً بجانب انبعاثاته؟
#Render $RENDER