قام أشخاص بإجراء اختبار مواجهة بالذكاء الاصطناعي لـ"ستار كرافت" (Brood War Bench)، حيث يتقاتل فيما بينهم النماذج اللغوية الكبيرة السائدة حاليًا في الوقت الحقيقي، والنتيجة أن مستوى جميع النماذج لم يتجاوز مستوى المبتدئ.
"ستار كرافت: معركة العش" هي لعبة إستراتيجية فورية كلاسيكية صدرت عام 1998، وصديقة قديمة لأبحاث الذكاء الاصطناعي. في 2019، تغلبت AlphaStar من DeepMind على لاعب محترف في هذه اللعبة. لكن ذلك كان ذكاءً اصطناعيًا مُدرَّبًا خصيصًا عبر التعلّم المعزز. أما هذه المرة فاختبار مختلف: إذ يترك الاختبار للنماذج اللغوية العامة أن تتعامل مباشرة كعملاء ذكاء اصطناعي، لمعرفة هل يمكنها أن تتقن بناء القواعد وإنتاج الوحدات والقتال.
كان المؤلف Ben Swerdlow في الأصل قد أنشأ نسخة من ستار كرافت لا تتيح التحكم إلا عبر"العميل الذكي" لاستخدامها مع أصدقائه في اللعب. ولم يتوقع أن بعض أصدقائه الذين لم يلعبوا اللعبة تقريبًا سيبدون أداءً جيدًا—قالوا إنهم فقط أعطوا أمرًا مثل"اذهب إلى الهجوم"، فقام العميل الذكي ببناء مجموعة صغيرة من الجنود واندفع بها تلقائيًا. وهذا أثار فضوله: إذا تركنا الذكاء الاصطناعي ليلعب بمفرده بالكامل، فإلى أي مستوى يمكنه أن يصل؟
الجواب: إنه ضعيف جدًا، لكنه ممتع للغاية.
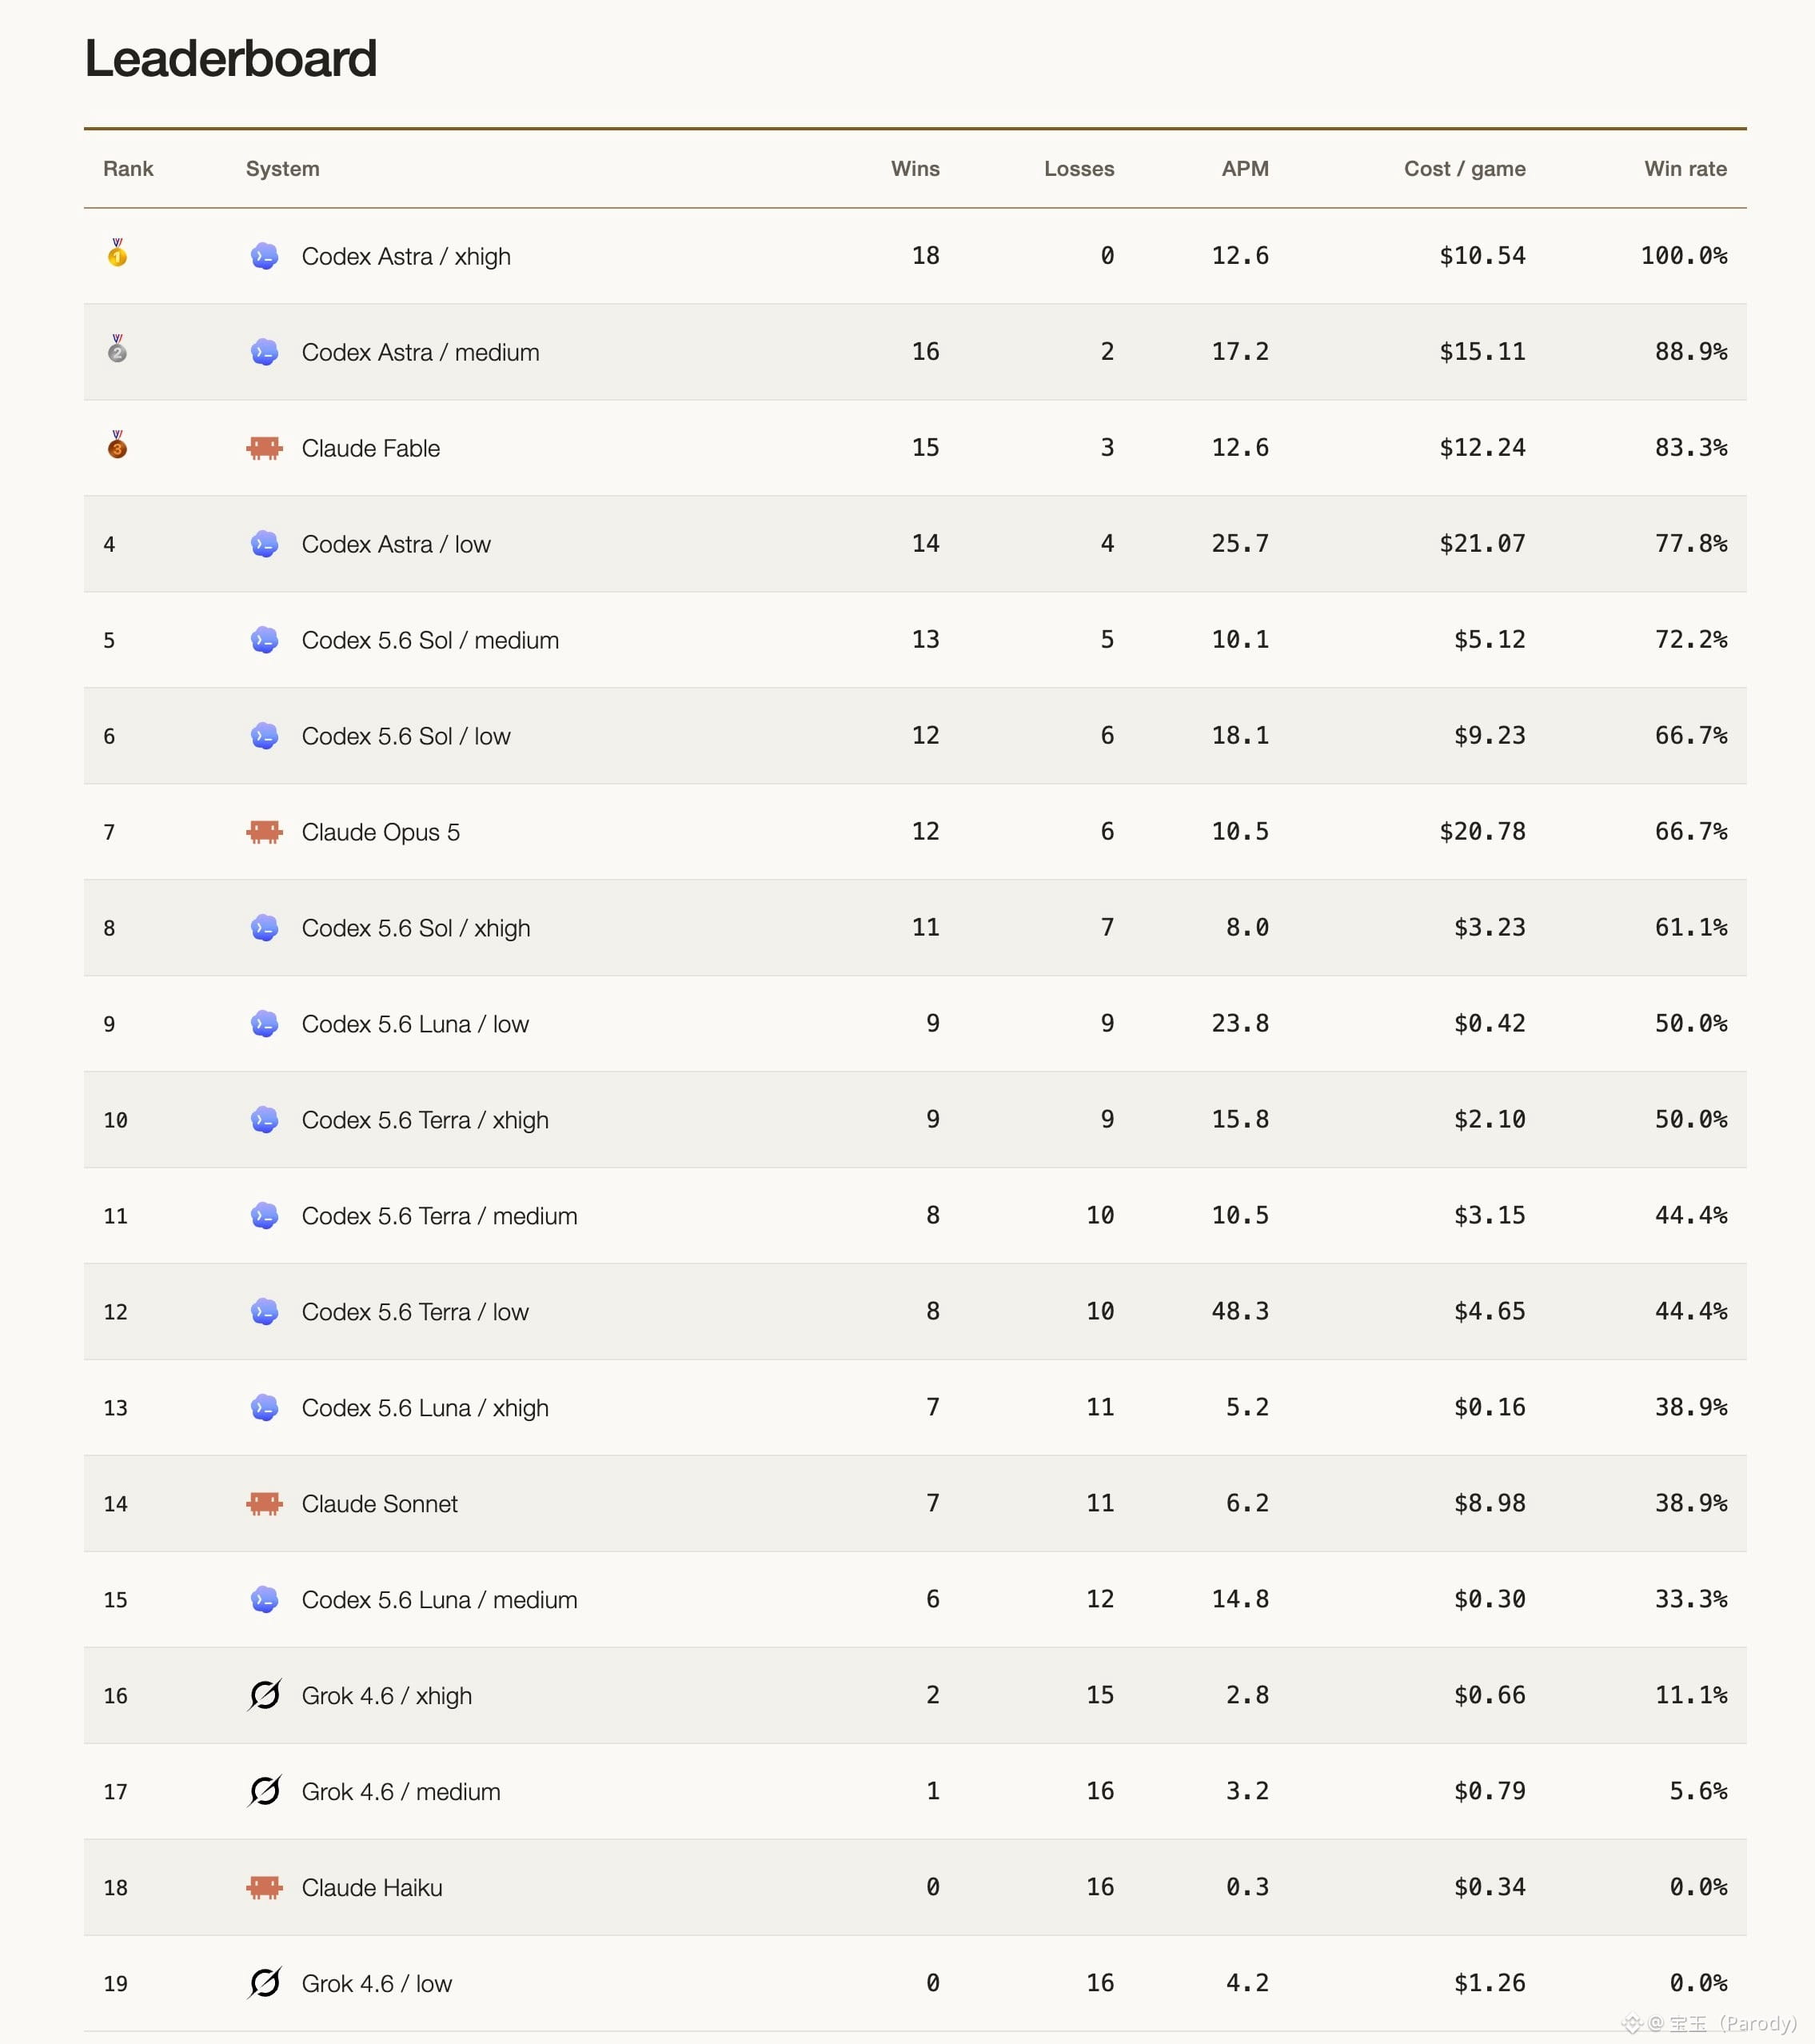
حقق Codex Astra المرتبة الأولى 18 فوزًا متتاليًا، لكن ما يجيده أكثر ليس القتال المباشر، بل"الإزعاج": إذ يرسل عاملاً للتعدين (Probe) للتسلل إلى قاعدة الخصم وإحداث فوضى. تعمل هذه الحيلة جيدًا جدًا ضد خصوم الذكاء الاصطناعي، لأن العميل الذي يرى عاملاً قادمًا يبدأ بالتفكير لعدة عشرات من الثواني فيما يجب فعله، وخلال تلك الفترة لا يقوم بأي شيء. أما في تطوير الاقتصاد بشكل جاد والقتال واسع النطاق، فإن Codex يكون أضعف نسبيًا: غالبًا ما يُنتج جنديًا أو اثنين ثم يرسلهم إلى الخصم بدل أن يجمع قوة كافية ثم ينطلق للهجوم.
حلّ Claude Fable في المركز الثالث بنسبة فوز بلغت 83.3%، وهو الأكثر"شبهًا باللعب بجدية" بين جميع النماذج المشاركة. فهو يتطور بهدوء ويصعد شجرة التكنولوجيا، وحتى إنه في مباراة واحدة أنشأ تنانين بحرية (Mutalisk)، وفي مباراة أخرى بحث تقنية فرسان المعبد (Sundry Templar). صحيح أنه أحيانًا يبذل جهدًا كبيرًا في البحث والتطوير دون أن يلحق ذلك بتجميع القوة القتالية، لكن على الأقل في محاولة فهم قواعد اللعبة، يكون Fable أكثر جدية من أي نموذج آخر.
كان أداء Grok هو الأسوأ. سجل Grok 4.6 أكثر من 11000 رمز استدلال (inference tokens) في مباراة مدتها 43 دقيقة، لكنه أصدر فقط 6 دفعات من أوامر التشغيل، ولم ينشئ طوال الوقت أي وحدة قتالية. جوهريًا، يتعامل مع الإستراتيجية الفورية وكأنها لعبة دورية: يفكر طوال الوقت، وينسى أن يتحرك.
يكشف هذا الاختبار عن المشكلة الأساسية التالية: لا تزال النماذج اللغوية الكبيرة الحالية غير كافية تمامًا للبيئات الزمنية الفعلية التي تتطلب مراقبة مستمرة واتخاذ قرارات سريعة وتنسيقًا متعدد الخيوط. حتى أفضل النماذج أداءً، يستطيع مبتدئ بشري يجيد سيناريو مثل"الاندفاع بسرعة صواريخ الفوتون" (أبسط تكتيك هجوم مبكر) الفوز في كل المباريات. لكن بالمقابل، فإن هذه النماذج أصبحت قادرة على فهم مفاهيم أساسية مثل البناء والتعدين والهجوم، غير أنها تتأخر كثيرًا في تنفيذ الإيقاع والتنسيق بين مهام متعددة.
تمت إتاحة كود الاختبار ومنصة المواجهة للعموم؛ يمكن لأي شخص إحضار عميل الذكاء الاصطناعي الخاص به واللعب في مباراة واحدة، عبر العنوان: http://bw.swerdlow.dev.
"ستار كرافت: معركة العش" هي لعبة إستراتيجية فورية كلاسيكية صدرت عام 1998، وصديقة قديمة لأبحاث الذكاء الاصطناعي. في 2019، تغلبت AlphaStar من DeepMind على لاعب محترف في هذه اللعبة. لكن ذلك كان ذكاءً اصطناعيًا مُدرَّبًا خصيصًا عبر التعلّم المعزز. أما هذه المرة فاختبار مختلف: إذ يترك الاختبار للنماذج اللغوية العامة أن تتعامل مباشرة كعملاء ذكاء اصطناعي، لمعرفة هل يمكنها أن تتقن بناء القواعد وإنتاج الوحدات والقتال.
كان المؤلف Ben Swerdlow في الأصل قد أنشأ نسخة من ستار كرافت لا تتيح التحكم إلا عبر"العميل الذكي" لاستخدامها مع أصدقائه في اللعب. ولم يتوقع أن بعض أصدقائه الذين لم يلعبوا اللعبة تقريبًا سيبدون أداءً جيدًا—قالوا إنهم فقط أعطوا أمرًا مثل"اذهب إلى الهجوم"، فقام العميل الذكي ببناء مجموعة صغيرة من الجنود واندفع بها تلقائيًا. وهذا أثار فضوله: إذا تركنا الذكاء الاصطناعي ليلعب بمفرده بالكامل، فإلى أي مستوى يمكنه أن يصل؟
الجواب: إنه ضعيف جدًا، لكنه ممتع للغاية.
حقق Codex Astra المرتبة الأولى 18 فوزًا متتاليًا، لكن ما يجيده أكثر ليس القتال المباشر، بل"الإزعاج": إذ يرسل عاملاً للتعدين (Probe) للتسلل إلى قاعدة الخصم وإحداث فوضى. تعمل هذه الحيلة جيدًا جدًا ضد خصوم الذكاء الاصطناعي، لأن العميل الذي يرى عاملاً قادمًا يبدأ بالتفكير لعدة عشرات من الثواني فيما يجب فعله، وخلال تلك الفترة لا يقوم بأي شيء. أما في تطوير الاقتصاد بشكل جاد والقتال واسع النطاق، فإن Codex يكون أضعف نسبيًا: غالبًا ما يُنتج جنديًا أو اثنين ثم يرسلهم إلى الخصم بدل أن يجمع قوة كافية ثم ينطلق للهجوم.
حلّ Claude Fable في المركز الثالث بنسبة فوز بلغت 83.3%، وهو الأكثر"شبهًا باللعب بجدية" بين جميع النماذج المشاركة. فهو يتطور بهدوء ويصعد شجرة التكنولوجيا، وحتى إنه في مباراة واحدة أنشأ تنانين بحرية (Mutalisk)، وفي مباراة أخرى بحث تقنية فرسان المعبد (Sundry Templar). صحيح أنه أحيانًا يبذل جهدًا كبيرًا في البحث والتطوير دون أن يلحق ذلك بتجميع القوة القتالية، لكن على الأقل في محاولة فهم قواعد اللعبة، يكون Fable أكثر جدية من أي نموذج آخر.
كان أداء Grok هو الأسوأ. سجل Grok 4.6 أكثر من 11000 رمز استدلال (inference tokens) في مباراة مدتها 43 دقيقة، لكنه أصدر فقط 6 دفعات من أوامر التشغيل، ولم ينشئ طوال الوقت أي وحدة قتالية. جوهريًا، يتعامل مع الإستراتيجية الفورية وكأنها لعبة دورية: يفكر طوال الوقت، وينسى أن يتحرك.
يكشف هذا الاختبار عن المشكلة الأساسية التالية: لا تزال النماذج اللغوية الكبيرة الحالية غير كافية تمامًا للبيئات الزمنية الفعلية التي تتطلب مراقبة مستمرة واتخاذ قرارات سريعة وتنسيقًا متعدد الخيوط. حتى أفضل النماذج أداءً، يستطيع مبتدئ بشري يجيد سيناريو مثل"الاندفاع بسرعة صواريخ الفوتون" (أبسط تكتيك هجوم مبكر) الفوز في كل المباريات. لكن بالمقابل، فإن هذه النماذج أصبحت قادرة على فهم مفاهيم أساسية مثل البناء والتعدين والهجوم، غير أنها تتأخر كثيرًا في تنفيذ الإيقاع والتنسيق بين مهام متعددة.
تمت إتاحة كود الاختبار ومنصة المواجهة للعموم؛ يمكن لأي شخص إحضار عميل الذكاء الاصطناعي الخاص به واللعب في مباراة واحدة، عبر العنوان: http://bw.swerdlow.dev.