

الآن إن الذكاء الاصطناعي، والذكاء الاصطناعي في المستقبل
إذا قسمنا سلسلة صناعة الذكاء الاصطناعي إلى معدات في المنبع، وشركات سحابية في الوسط، وشركات نماذج كبيرة في القمة، فإن الشركات التطبيقية في المصب هي التالية. حاليًا، تتركز معظم أرباح سلسلة الصناعة في المنبع؛ إذ إن شركة إنفيديا (NVDA.US) وحدها، إلى جانب أربع شركات تخزين رئيسية، تستحوذ على ما يقرب من 70% من أرباح القطاع.
تعكس طريقة توزيع الأرباح هذه سِمات نموذجية لمرحلة مبكرة من تطور ثورة تكنولوجية جديدة؛ لكن لنتأمل: إن نقاط التحصيل في مستقبل صناعة الذكاء الاصطناعي ستكون إما شركات السحابة أو التطبيقات في المصب، فهل سيكون توزيع الأرباح بهذه الطريقة أيضًا؟
على سبيل المثال، في مجال الإنترنت الناضج، فإن النِّسب التقريبية لتوزيع الأرباح الاقتصادية هي:
المنبع (الأجهزة/التقنيات): نحو 20%–30%
الطبقة الوسطى للشبكات/السحابة/مزودي الاتصالات: نحو 10%–20%
المنصات والتطبيقات في الأسفل: نحو 50%–70%
واضح أن كلما اقتربت من بوابة المستخدم (نقطة الدخول)، زادت حصة الأرباح.
إن الإنفاق الرأسمالي الكبير الذي قامت به شركات السحابة في السنوات القليلة الماضية، في جوهره، ينقل جزءًا من أرباح شركات السحابة المستقبلية إلى أرباح اليوم لدى شركات عدة من المنبع للعتاد. أما إيرادات صناعة الذكاء الاصطناعي في المستقبل، فستتدفق أساسًا إلى التطبيقات في الأسفل وإلى مزودي السحابة.
مع تباطؤ نمو الإنفاق الرأسمالي، ومع نمو إيرادات الذكاء الاصطناعي نفسها، ستتجه حصص الأرباح في السلسلة الصناعية بشكل متزايد نحو نمط الصناعات الرقمية الناضجة في الإنترنت، مع تركيز مستمر نحو مزودي السحابة في الطبقة الوسطى وشركات التطبيقات في الأسفل.
حاليًا يبلغ إجمالي القيمة السوقية لسلسلة صناعة الذكاء الاصطناعي في السوق الأمريكي نحو 25 تريليون دولار. منها: المنبع (بما في ذلك رقائق الحوسبة، ومعدات أشباه الموصلات، والتخزين، ومعدات الاتصالات) تمثل 47%، والطبقة الوسطى (مزودو السحابة) تمثل 50%، بينما تمثل الطبقة السفلية (التطبيقات) 3% فقط—وهناك مساحة كبيرة للنمو.
إذا كنت تستثمر في ذكاء اصطناعي هذا العام، فطبيعي أن تستمر بالاستثمار في قدرات الحوسبة. لكن إذا كنت تستثمر في مستقبل الذكاء الاصطناعي، فمن دون شك ينبغي أن تركز أكثر على التطبيقات في الأسفل. خلال السنوات الثلاث الماضية، ظهر عدد لا يحصى من الشركات في المنبع حقق أرباحًا بعشرات المرات، لكن مع انتهاء ذروة الإنفاق الرأسمالي، سيتم ترك المزيد من توزيع الأرباح للطبقة الوسطى والسفلية، ومن المرجح أن تزيد احتمالية ظهور “أسهم بعشرة أضعاف”.
في السابق، كنت أشعر أن عدم يقين تطبيقات الذكاء الاصطناعي قوي جدًا. لكن في الحقيقة، حجم الإيرادات الأصلية للذكاء الاصطناعي محليًا ما يزال صغيرًا. أما في الولايات المتحدة فالأمر مختلف: ظهرت بالفعل عدة مسارات واضحة لتطبيقات الذكاء الاصطناعي، وبرزت مجموعة من الشركات ذات قيمة استثمارية عالية. وما زال هذا المقال يستخدم شركات تطبيقات الذكاء الاصطناعي المدرجة في سوق الأسهم الأمريكي كمثال لفرز أهم الاتجاهات.
الحوسبة تُقاس بمدى تَفاؤُق/ازدهار السوق، أما التطبيقات فتُقاس بنموذج الأعمال
تطبيقات الذكاء الاصطناعي ليست كتلة واحدة متجانسة. في عام 2026 ستحدث فجوة تفرّق شديدة داخلية: ستتفوق بقوة البرمجيات من نوع البنية التحتية المُسحوبة بواسطة أحمال عمل الذكاء الاصطناعي (بما في ذلك منصات البيانات، والقدرة على الملاحظة/المراقبة، والأمن) على بقية القطاعات. وتحولت عبارة “تفضيل شراء برمجيات البنية التحتية وتقليص التعرض لـ SaaS” إلى استراتيجية إجماع بين المستثمرين في أسهم البرمجيات في السوق الأمريكي.
لكن ليس كل برنامج SaaS يمكنه أن يُقيَّم بأعلى من كل شيء (يُقتَل التقييم). وفقًا للتقرير النصفي، فإن كثيرًا من أسهم البرمجيات تشهد نموًا سريعًا في إيرادات الذكاء الاصطناعي، وفي الوقت نفسه توجد شركات بنية تحتية للبرمجيات تقييمها مرتفع جدًا أيضًا.
الحوسبة تُقاس بمدى تَفاؤُق/ازدهار السوق، والتطبيقات بنموذج الأعمال. ولتحديد أفضلية/ضعف المسار الفرعي، توجد ثلاثة متغيرات رئيسية:
1) نموذج التسعير: تسعير بالاعتماد على الاستخدام/الاستهلاك، ويتوافق طبيعيًا مع أحمال عمل الذكاء الاصطناعي، ما يتيح تعويض مخاطر تقليص عدد المقاعد. أما نموذج المقاعد الخالص فيتحمل ضغطًا أكبر؛
2) موقعها ضمن سلسلة تنفيذ الذكاء الاصطناعي في المؤسسة: امتلاك بيانات جوهرية وصلاحيات ومداخل لسير العمل، ما يتيح إعادة تقييمها من “برمجيات تطبيقات” إلى “بنية تحتية للذكاء الاصطناعي في المؤسسة”.
3) هل إيرادات الذكاء الاصطناعي تمثل زيادة فعلية (incremental)؟ السوق يدفع فقط مقابل مؤشرات AI ARR/ACV/أحمال العمل التي يمكن تتبعها، وليس مقابل “استراتيجية” ذكاء اصطناعي.
انطلاقًا من هذه المعايير الثلاثة، يمكن تقسيم تطبيقات الذكاء الاصطناعي إلى سبع قطاعات ضمن ثلاث طبقات.
الفئة الأولى: منصات البيانات
افترض أن هناك شركة تجارة إلكترونية كبيرة قررت “AII in AI”: أي إدخال الذكاء الاصطناعي في الذكاء الاصطناعي. بعد ذلك، تقلل قدر الإمكان من التوظيف، وتترك AI Agent يدير الشركة بنفسه.
هذا لا يمكن حله بمجرد توفير مدخلات/بوابة لبضعة Agent. الخطوة الأولى—التي على كل شركة القيام بها—هي إنشاء منصة بيانات للذكاء الاصطناعي. لكي يتخذ الذكاء الاصطناعي قرارات وينفذ، يجب أولًا أن يعرف ماذا حدث في الماضي داخل الشركة وماذا يحدث الآن.
في الماضي، كان منفذو أعمال الشركة هم الموظفون، لذا يمكن أن تتفرق البيانات في أماكن مختلفة: بيانات المستخدم في CRM، والطلبات في قواعد بيانات التجارة الإلكترونية، والبيانات المخزنية والمالية في ERP، وسجلات خدمة العملاء في نظام خدمة العملاء، ومعلومات المنتجات في PIM، وبيانات الإعلانات في Meta وGoogle، وبيانات الموظفين في أنظمة الموارد البشرية، ومحاضر الاجتماعات في أجهزة كل موظف وبريده الإلكتروني، بل وأكثر البيانات في عقول الموظفين وسجلات الدردشة (إذا كانت الشركة صينية)…
عند التنفيذ، يَجمع الموظفون هذه البيانات ويبحثون عنها من قنوات مختلفة ثم يدمجونها. مثلًا: عندما يسأل المدير “لماذا انخفضت أرباح منطقة شنغهاي خلال الأشهر الثلاثة الماضية؟” يمكنك تسجيل الدخول إلى أنظمة مختلفة لرؤية الإجابات. إن لم تعرف فاسأل زملاءك، ثم يمكنك التحليل.
وبالمثل، لكي يكون الـAgent قادرًا على العمل فعليًا، يجب أن يعرف في الوقت نفسه كل البيانات المذكورة أعلاه. دون بيانات، يصبح الذكاء الاصطناعي مجرد موظف خارجي ذكي جدًا لكنه لا يعرف ما الذي يجري في الشركة.
لذلك، تتمثل أول خطوة في التحول بالذكاء الاصطناعي في تحويل مختلف معلومات الشركة إلى بيانات يمكن للذكاء الاصطناعي فهمها والاستعلام عنها واستدعاؤها، قدر الإمكان—أي إجراء انتقال البيانات.
في المستقبل، ستكون كل جلسة اجتماع للمشروع، وكل تواصل بين الزملاء، وحتى كل محادثة بين الموظفين، مسجلة ومُرقمنة بشكل متزامن، لتصبح بيانات تحليل ومواد نصية للذكاء الاصطناعي. عندها فقط يمكن ضمان أن قرارات الذكاء الاصطناعي تستند إلى معلومات آنية عن تشغيل الشركة.
أفضل ما تم تنفيذه في السوق الأمريكي هو $Snowflake (SNOW.US)$ و $MongoDB (MDB.US)$. وبالطبع هناك شركة أخرى ليست نمطية لكنها أكثر شهرة هي $Palantir (PLTR.US)$.
$Snowflake (SNOW.US)$ التي كانت في الأصل مجرد مزود خدمة مستودعات بيانات واحدة، تحولت لتصبح منصة سحاب بيانات شاملة للذكاء الاصطناعي. أطلقت منتجات أصلية مثل Cortex Code وSnowflake Intelligence وغيرها، ما يبسط عمليات ترحيل بيانات العملاء ويُحفز استهلاك الأعمال الأساسية للبيانات، مكوِّنًا حلقة نمو قوية.
تُفوتر شركات هذا النوع عادةً على أساس الاستخدام/الاستهلاك. وبما أن عبء عمل الذكاء الاصطناعي مرتبط طبيعيًا بذلك، تظهر في التقرير النصفي مؤشرات: تسارع نمو إيرادات المنتج لثلاثة أرباع متتالية وصولًا إلى 37% في الربع الثاني. كما رفعت الشركة توجيه إيرادات المنتج للعام بأكمله إلى 6.07 مليار دولار (+36%)، ما يثبت أن “حلقة استهلاك المنصة الأساسية التي يقودها الذكاء الاصطناعي” دخلت مرحلة تحقيق النتائج.
ومع ذلك، فإن تقييم الشركات من هذا النوع يكون أيضًا مرتفعًا جدًا. فـSNOW تصل إلى قرابة 20 ضعف PS، وقيمتها السوقية تقارب 120 مليار دولار أمريكي، وتشمل توقعات مستقبلية أعلى. الشك لدى السوق يتمثل في أنها تتنافس وتتعاون في الوقت نفسه مع عمالقة السحابة مثل AWS وMicrosoft وGoogle.
الفئة الثانية: قابلية الملاحظة/Observability
عندما يصبح جزء أكبر من أعمال هذه الشركة يتم إنجازه بواسطة الذكاء الاصطناعي، اكتشفت الشركة مشكلة خطيرة: لا تعرف ماذا فعل الذكاء الاصطناعي بالضبط. وهل الـtoken الذي تم استهلاكه يستحق القيمة؟ وما الأعمال التي يمكن تحسينها؟
في السابق، كانت لدى الشركات منظومة كاملة لتسجيل أعمال الموظفين وتقييمهم. الأوضح هو إدارة KPI. صحيح أن التقييمات السلبية كثيرة، لكنها تضمن أن شركة بعدة عشرات الآلاف من الموظفين تعمل تلقائيًا وفقًا للخطوات/العمليات. لكن عمل الذكاء الاصطناعي “صندوق أسود”، ويمكنه أن يتكاسل ويفعل “عملاً غير مفيد”. ومع ذلك، فإن سير عمله قد يكون مختلفًا تمامًا عن سير عمل البشر. عندها ستفشل مؤشرات KPI التقليدية، ويحتاج الموظفون إلى رؤية باستمرار ما الذي فعله الذكاء الاصطناعي بالضبط.
هذه هي مشكلة تطبيقات قابلية الملاحظة/Observability التي تحلها. كأنها الـHR للذكاء الاصطناعي: هل يمكن للإنسان أن يرى ما هي الأدوات التي يستدعيها AI Agent؟ أي API تم استدعاؤه؟ كم token تم إنفاقه؟ لماذا اتخذ هذا القرار؟ في أي خطوة حدث خطأ؟ أي Agent أداءه أعلى؟ وأي Agent تسبب في خسارة؟
شركة $Datadog (DDOG.US)$ هي مثال على الشركة الرائدة في هذا الجزء. يمكنها مراقبة مؤشرات الأداء التقليدية لـ APM مثل السحابة أو الخوادم الهجينة أو المحلية لدى العملاء، وأجهزة الحاويات والشبكات وغيرها بشكل فوري. كما يمكنها تقديم تتبع موزع على مستوى الشيفرة لمساعدة العملاء على فهم عماق عنق الزجاجة في أداء التطبيقات والميكروسيرفس. كذلك تجمع تحلل وتقدم سجلات ضخمة قادمة من الأنظمة والتطبيقات لإجراء تحليل الأعطال واستكشاف المشكلات والأداء.
نمط تسعير هذا النوع من التطبيقات أيضًا قائِم على الاستهلاك. فقد ارتفعت إيرادات DDOG في الربع الثاني بنسبة +36%، وحققت نموًا متسارعًا خلال أربعة أرباع متتالية، كما تم رفع توجيه الأداء السنوي بشكل كبير. ومع ذلك، فإن تقييم هذا القطاع أيضًا مرتفع جدًا، ما يجعل السهم عرضة جدًا لتأثره بسرديات سلبية تخص قطاع البرمجيات.
الفئة الثالثة: الأمن السيبراني
يمثل الأمن السيبراني فئة موجودة أصلًا في عصر البرمجيات التقليدية، لكن أهميتها ارتفعت بشكل حاد في عصر الذكاء الاصطناعي. وذلك لأن هجمات الذكاء الاصطناعي لا تستهدف نظامك فقط، بل يمكن أن تعمل أيضًا كإغراء/محفز للمتسللين نفسها.
الذكاء الاصطناعي بطبيعته يُعوِّض الموظفين. صلاحياته أكبر من معظم الموظفين. لا يمكنه فقط الوصول إلى قواعد البيانات وتعديل البيانات وإرسال البريد الإلكتروني، بل يمكنه تنفيذ إجراءات عالية الخطورة مثل تحويل الأموال. وحتى كتابة الأكواد ونشر البرامج—كأنه يخترق مباشرة “دماغ” موظفيك، أي “يتمرد/يُغرِي” الموظفين.
يمتلك Agent القدرة على الاستدلال والوصول للبيانات وإجراء الأفعال، لذلك ستصبح الصلاحيات وهوية المستخدم والتدقيق وسُبل التحكم في استدعاء الأدوات مشكلات أمنية جديدة.
هناك بالفعل العديد من الشركات في هذا النوع من مفهوم الأمن السيبراني (LIST2570.US)، لذلك لن أذكر أمثلة.
الأمن هو الأعلى ضمن الأجزاء الثلاثة، إذ يتمتع بوضوح أكبر وقابلية للتنبؤ، ومع وجود فجوة زمنية بين الإنفاق على الذكاء الاصطناعي والإنفاق على الأمن الموجه للذكاء الاصطناعي، تكون توقعات نمو الإيرادات المستقبلية قوية جدًا.
هذه الأنواع الثلاثة—خدمات البيانات وقابلية التنبؤ والأمن السيبراني—يمكن تسميتها مجتمعة “بنية رقمية” لتطبيقات الذكاء الاصطناعي. إنها طقم الثلاثة التي لا بد منها لأي شركة تريد تنفيذ استراتيجية ذكاء اصطناعي في المستقبل. الإنفاق فيها له طبيعة تمهيدية (مقدمات) وأيضًا استمرارية، لذلك تنفجر مبكرًا داخل التطبيقات.
المبني على هذه البنى الرقمية الثلاث هو تطبيق “طبقة التنفيذ”، أي واجهات العمل المختلفة داخل المؤسسة. أميز هنا بين نوعين: أحدهما منصات Workflow / Agent المختلفة، والآخر هو برمجة الذكاء الاصطناعي.
الفئة الرابعة: منصة Workflow/Agent
بعد توفر البيانات والصلاحيات، كيف يعمل Agent لهذه الشركة التجارية الإلكترونية تحديدًا؟
حاليًا هناك حلّان من نوعين. النوع الأول: الاستفادة من AI Agent بالاعتماد على سير العمل الموجود أصلًا، مع استخدام مختلف البرمجيات الصناعية لتقديم العمل—ويُسمى “منصة Workflow / Agent”.
مثلًا، في شركة تجارة إلكترونية هذه حين تتعامل مع إرجاع المنتجات من العملاء، تكون العملية التقليدية أن يراجع فريق خدمة العملاء الطلب، ثم يستعلم عن الطلب، ويحدد السبب، ويتحقق من المخزون، ويقوم برد المبلغ، ويعالج الشحن/اللوجستيات، ويبلغ المستودع... وكل خطوة يتم فيها تشغيل برنامج بواسطة البشر.
وفي نموذج “Workflow / Agent platform”، تبقى العملية كما هي، لكن يتم التعامل معها تلقائيًا بواسطة Customer Agent متخصص.
في هذا النمط، إضافةً إلى النموذج الكبير نفسه، الأهم هو كيفية تضمين استدعاءات الأدوات والصلاحيات والموافقات اليدوية بشكل منطقي داخل سير العمل الأصلي. وتكمن الصعوبة في التعاون بين الموظفين وAgent.
لذلك، شركات التطبيقات من هذا النوع هي في الأساس شركات برمجيات قائمة تتحول. مثل $赛富时 (CRM.US)$ و $ServiceNow (NOW.US)$ و $微软 (MSFT.US)$ وغيرها. كذلك نموذج التسعير يعتمد نمطًا مزدوجًا: “مقاعد + تسعير بالـ Token”.
لكن لهذا النوع من الشركات غير الأصلية لتطبيقات الذكاء الاصطناعي تبعًا لذلك يتعرض لاتهامات/شكوك مضاعفة. هناك نقطتان رئيسيتان: أولًا، هل نمو أعمالها فعلًا مدفوع بالذكاء الاصطناعي أم بغير الذكاء الاصطناعي؟ ثانيًا، نموذج التسعير: هل يمكن للتسعير على التدفق/الحركة الجديدة أن يعوض الانخفاض في رسوم المقاعد التقليدية؟
الشركات الأكثر جرأة في التحول، مثل $ServiceNow (NOW.US)$، حتى إنها صارت تحدد منصتها على أنها بنية تحتية للذكاء الاصطناعي على مستوى المؤسسة تربط البيانات وسير العمل وAI Agent. ويمكن لمنصتها ربط $SAP SE (SAP.US)$ و $赛富时 (CRM.US)$ إضافة إلى $Snowflake (SNOW.US)$ وDatabricks وغيرها من البيانات الخارجية.
إذا كان “منصة Workflow / Agent” هي نمط تشغيل البرمجيات التقليدية المدفوع بالذكاء الاصطناعي، فإن “برمجة الذكاء الاصطناعي” تعني ببساطة كتابة برنامج لإنجاز العمل الآن.
الفئة الخامسة: برمجة الذكاء الاصطناعي
وهذا عمليًا هو أول سيناريو B2B استطاع نموذج اللغة الكبير أن يمرّ به بسلاسة، وهو ما تسبب في طفرة مجنونة في ARR خلال النصف الأول من العام.
في تصور AI Agent، سيكون دوره استدعاء البرامج الموجودة. لكن في الممارسة، كثير من البرمجيات لا تملك واجهات. وفي المقابل، فإن النماذج الكبيرة للذكاء الاصطناعي تتقن بشكل ممتاز كتابة البرامج. لذلك بدلًا من مواجهة هذه المشكلة، من الأفضل كتابة برنامج لحلها. وهكذا تطور النموذج الكبير من إكمال الكود إلى البرمجة بأسلوب الحوار، ثم إلى “وكلاء البرمجة”.
يتضمن هذا النوع كلًّا من GitHub Copilot وCursor، وكذلك أيضًا Claude Code وCodex وغيرها التي أطلقتها معامل النماذج الكبيرة.
أميل أكثر إلى فصل برمجة الذكاء الاصطناعي عن البرمجيات التقليدية ووظائف النماذج الكبيرة للذكاء الاصطناعي. إذا كنت فعلًا تريد استخدام الذكاء الاصطناعي لإعادة تشكيل المؤسسة، فعليك الخروج تمامًا من سير العمل الأصلي، وأن تنتج “أداة إنتاج” بنفسك، وأن تكسر الحدود بين العامل وأداة الإنتاج. عندها فقط يمكن رفع كفاءة العمل حقًا، ويمكن أن تظهر شركات بحجم تريليون دولار مثل Anthropic.
وقد تحولت هذه الفئة من البرمجيات بالكامل من رسوم المقاعد إلى التسعير بالـ Token، لتدخل مباشرة طبقة التطبيقات، وتنافس بشكل مباشر بشكل إيجابي ما سبقها “Workflow / Agent platform”. ومن الممكن أن يولد من بين هذا النوع “الأنماط السائدة” للعمل بالذكاء الاصطناعي وأسهم بعشرة أضعاف.
الفئة السادسة: الصناعات العمودية وإعلانات الذكاء الاصطناعي
أما الفئات الخمس الأولى من تطبيقات الذكاء الاصطناعي، فهي بنية تحتية وأدوات إنتاج ضمن سيناريوهات عمل عامة. بينما الفئة السادسة تستهدف بعض سيناريوهات أعمال محددة. والنماذج العامة الكبيرة غالبًا لا تلبي متطلبات الامتثال والدقة لهذه الصناعات بعينها؛ لذلك تمنح البرمجيات العمودية “خندقًا” أعمق.
تطبيقات هذا النوع، هي في الواقع مبنية على الطبقات الخمس الأولى السابقة. والأكثر نضجًا حاليًا هي إعلانات الذكاء الاصطناعي لـ $Meta Platforms (META.US)$ و $谷歌-A (GOOGL.US)$ و $Applovin (APP.US)$.
تُعد الإعلانات أول سيناريو تجاري تم تطبيقه فعليًا للذكاء الاصطناعي. إذ يدفع الذكاء الاصطناعي نمو eCPM/ROAS عبر زيادة مدة استخدام المستخدم، ورفع معدلات التحويل المستهدفة، وتحسين CTR الإبداعي.
ارتفعت إيرادات إعلانات Meta في FY26Q1 بنسبة 33%. وتدعي زيادة مرات العرض بنسبة +19% وتحسن متوسط السعر للوحدة بنسبة +12%، وتنسب ذلك إلى الذكاء الاصطناعي. والأقنع أكثر هو جوجل: ارتفعت إيرادات البحث في FY26Q1 بنسبة +19%، مع وصول حجم الاستعلامات إلى مستوى قياسي جديد، مما يكسر تصور أن البحث المدفوع بالذكاء الاصطناعي يضعف متانة الإعلانات.
عند الاستثمار في شركات هذا النوع من التطبيقات، أصعب شيء هو التمييز بين مدى “حقيقة” أن الذكاء الاصطناعي يقود الأعمال. فالكثير من شركات تطبيقات الذكاء الاصطناعي المعتمدة أساسًا على إيرادات الإعلانات تكون حصة الإيرادات المدفوعة بالذكاء الاصطناعي فيها صغيرة جدًا، بل إنها تواجه خطر التعرض للانقلاب بفعل الذكاء الاصطناعي. بالمقابل، شركات تطبيقات الإعلانات الأصلية المدفوعة بالذكاء الاصطناعي مثل AppLovin: تكاد كل دولار من الإيرادات تأتي من إعلانات يقودها الذكاء الاصطناعي. حتى لو كانت التقييمات مرتفعة، فقد لا تزال الإمكانات الفعلية أعلى مما يتم تسعيره بأقل مما ينبغي.
بالإضافة إلى الإعلانات، تتحرك تطبيقات الذكاء الاصطناعي في قطاعات عمودية مثل الأدوية والضرائب والتعليم والتصميم بسرعة نسبيًا. غالبًا تكون قابلية قياس ROI فيها أسهل، ورغبة العملاء في الدفع على صلة قوية بالذكاء الاصطناعي. لكن الاستثمار غالبًا الأنسب أن يتم من منظور تحليل القطاعات العمودية ذات الصلة.
المقوَّضون/المُستبدَلون: SaaS وخدمات تقنية المعلومات
في شركة التجارة الإلكترونية التي تكون “All in AI”، كانت تنفق في السابق عدة ملايين سنويًا على شراء برامج عملاقة؛ لأن كل موظف يحتاج إلى مقاعد/تراخيص للبرمجيات التي يستخدمها باستمرار. لكن بعد مجيء الذكاء الاصطناعي، عندما صار كل موظف لديه مجموعة من الـAgent، اكتشفت الشركة أنه لم يعد هناك حاجة إلى الكثير.
إنها “ابتلاع النموذج للبرمجيات”. ليست مجرد سردية، بل واقع يحدث فعلًا في صناعة البرمجيات. يمكن للنماذج الكبيرة نسخ وظائف SaaS بشكل أسرع وبكلفة أقل، وتقلل عدد المقاعد عبر استبدال الموظفين. تتوقع Gartner أنه بحلول 2030 ستتحول ما لا يقل عن 40% من إنفاق شركات SaaS إلى التسعير بالاعتماد على الاستخدام/Agent/النتائج، وينخفض سهم إيرادات نظام المقاعد إلى أقل من خمس. وهذه إعادة التسعير المسبقة تضغط على التقييمات أولًا حتى قبل أن تتدهور أرباح أسهم البرمجيات. وكانت Intuit وAdobe وWorkday ضمن أسوأ ثلاث أسهم من حيث أداء مؤشر Nasdaq 100 خلال النصف الأول من 2026؛ وكلها شركات برمجيات.
ومع ذلك، في النصف الثاني من 2026، لم يعد الواقع مجرد “SaaS يموت حتمًا”، بل أصبح التمييز بين متبني التحول بالذكاء الاصطناعي والمتخلفين عنه:
مثل $赛富时 (CRM.US)$ وغيرها من الشركات تقوم بتحويل AI Agent إلى طريقة جديدة للفوترة على أساس الاستهلاك/الاستخدام. مؤقتًا لذلك تُدرج ضمن الفئة الرابعة السابقة “منصة Workflow / Agent”. بينما شركات مثل Intuit وAdobe وWorkday: فإن مبادراتها في مجال الذكاء الاصطناعي لا تستطيع على المدى القصير دفع نمو متسارع، لذا يتم إدراجها مؤقتًا خارج فئات التطبيقات الست، لتصبح ضمن قائمة مرشحي “المُقوَّضة/المعترضة”.
الأخطر من SaaS هو قطاع خدمات تقنية المعلومات. إنه مجال يحدث فيه تقويض/اضطراب بالفعل.
في السابق، كانت شركة التجارة الإلكترونية هذه تنفق كل عام عدة ملايين على شركات خدمات تقنية مثل Accenture وIBM وInfosys لشراء خدمات مثل تنفيذ الأنظمة وتطوير البرمجيات وترحيل البيانات وصيانة ERP والاستشارات التقنية و غيرها.
من الواضح أن هناك مخاوف أيضًا حول استبدال الذكاء الاصطناعي للموظفين. لكن استبدال خدمات تقنية المعلومات الخارجية (IT outsourcing) لا يواجه أي عائق تقريبًا.
تراجعت إيرادات Accenture في الربع الثالث من السنة المالية 2026 عن التوقعات، مع خفض توجيهات نموها السنوي. وهبط السهم في يوم واحد بنحو 18%. والسبب العميق هو أن الشركات خفضت بشكل كبير ميزانيات ترقية البرمجيات التقليدية وخدمات الأنظمة للحصول على عتاد قدرات الحوسبة الخاصة بالذكاء الاصطناعي. كما واجهت IBM مشكلة مشابهة.
أظهر بحث لمديري CIO لدى Morgan Stanley للربع الثاني من عام 2026 أن معدل نمو ميزانية خدمات تكنولوجيا المعلومات المتوقعة في 2026 لا يتجاوز +1.8%، وهو أقل من +2.1% في 2025. وحتى مع تحسن الميزانية الإجمالية لتكنولوجيا المعلومات، ما يزال الذكاء الاصطناعي يستحوذ على جزء من الميزانية المتاحة.
إذا كان، مشكلة شركات SaaS هي أن البرمجيات نفسها قد تُعاد تعريفها بواسطة Agent، فإن مشكلة خدمات تقنية المعلومات هي أن دور الإنسان قد يتم استبداله بواسطة Agent. والأمر الثاني بالطبع مشكلة أكبر.
بالطبع، لدى شركات خدمات تكنولوجيا المعلومات هذه أعمال جديدة أيضًا: قد يواجه العملاء صعوبات في تحقيق عائد ROI للذكاء الاصطناعي، مثلما يجلب ترحيل السحابة طلبًا جديدًا لخدمات ذكاء اصطناعي—فقط انظر هل يمكنها تعويض تراجع الأعمال القديمة أم لا.
الخلاصة
يمكن القول إن قطاع البرمجيات التقليدي هو أول قطاع تشرّدت/تكسرت فيه المنظومة بسبب صدمة الذكاء الاصطناعي، وهو أيضًا أول قطاع ازدهرت فيه تطبيقات الذكاء الاصطناعي الأصلية. في البداية، كان السوق يقسم شركات البرمجيات إلى ذكاء اصطناعي وغير ذكاء اصطناعي. أما التقسيم الحالي فهو إلى فائزين وخاسرين وغير محددي الوضع، ومعظمهم “غير محدد”.
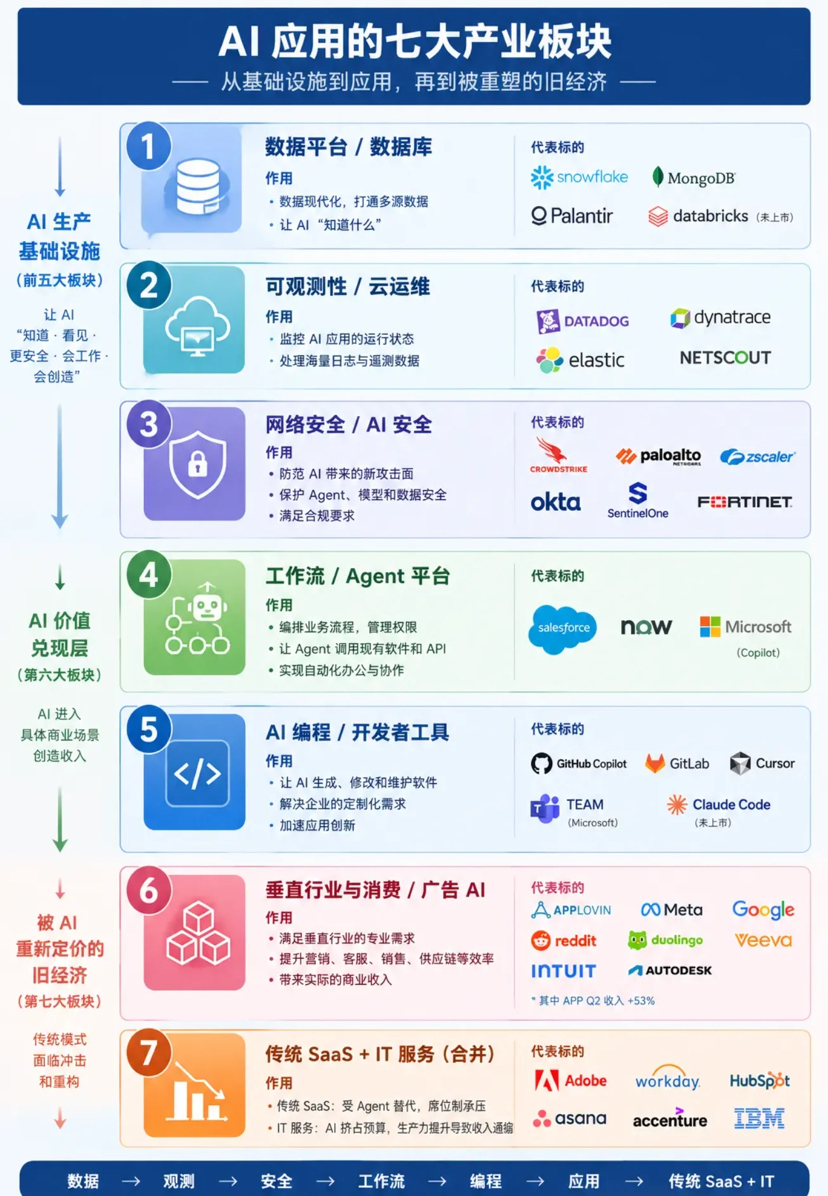
ضمن فئات التطبيقات السبع أعلاه، فإن أول ثلاث فئات هي “الفائزون”: خدمات البيانات وخدمات قابلية التنبؤ وخدمات الأمن السيبراني. خصائصها أنها ضرورة حتمية (Just need). وكلما انتشر الذكاء الاصطناعي، زادت تعقيد الأنظمة، وبالتالي زادت الطلبات.
الرابع والخامس: منصات Workflow/Agent وبرمجة الذكاء الاصطناعي. حتى الآن، ما زالت “وضعها غير محدد”، لكن كلما انتشر الذكاء الاصطناعي، زاد تأثيرها. وقد تصبح حتى “نظام تشغيل” جديدًا للشركات، وتعيد بشكل جذري تشكيل نموذج أعمال صناعة البرمجيات.
الفئة السادسة: تطبيقات عمودية. الانقسام شديد جدًا ويجب التحقق واحدًا تلو الآخر: من هو فعلًا عمل مدفوع بالذكاء الاصطناعي، ومن هو مجرد تغليف بمفهوم AI؟
وأخيرًا، الفئة التي تم تقويضها؛ حاليًا يبدو أنها “خاسر”. كلما زاد انتشار الذكاء الاصطناعي، زادت خطورة النماذج التجارية القديمة. ومع ذلك، ليس الأمر بلا أي فرص تمامًا.
لم يعد تطبيق البرمجيات المدفوع بالذكاء الاصطناعي مجرد صناعة، بل ولا حتى مجرد تطبيقات أصلية مثل البرمجة؛ فهو انقلاب كامل على طرق الإنتاج داخل المؤسسات. لذلك، إطار تقييم البرمجيات في المستقبل لا ينبغي أن ينظر فقط إلى نمو الإيرادات وهوامش الربح، بل أيضًا إلى عدد مرات استدعاء الذكاء الاصطناعي، وحجم تنفيذ المهام، ومعدل اختراق العمليات الآلية، ودرجة الاعتماد على الـAgent، وتقدم انتقال بنية التسعير إلى النموذج الجديد.
