أحدثتُ بحثًا في KGeN، وتوجد به تغيّرات لافتة.
في السابق، عندما كنت أرى مثل هذه المشاريع، كنت أنظر أولًا إلى:
سعر العملة.
أما الآن، فأطرح أولًا السؤال:
ما المشكلة التي يحلّها هذا فعليًا؟
إجابة KGeN بالنسبة لي كانت بسيطة نسبيًا:
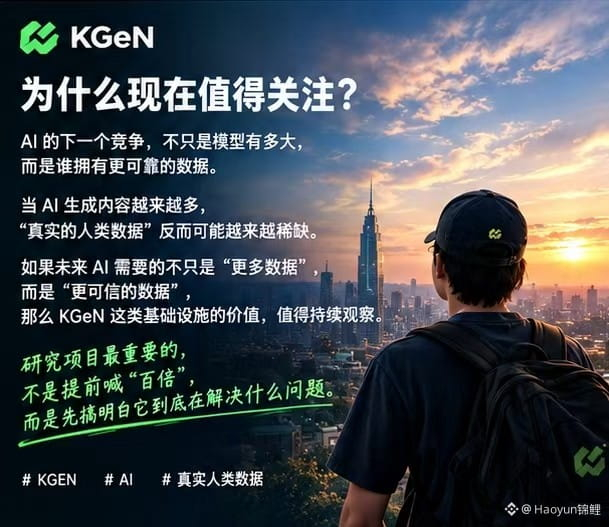
تحتاج الذكاء الاصطناعي إلى بيانات، لكن في المستقبل قد نحتاج أكثر إلى «بيانات بشرية موثوقة».
هذا المنطق ليس صعب الفهم.
افترض أنك تجعل الذكاء الاصطناعي يتعلم من 100 مليون قطعة من محتوى الإنترنت.
يبدو ذلك كثيرًا جدًا.
لكن إذا كان جزء كبير من هذا المحتوى نفسه مُولّدًا بواسطة روبوتات، أو بواسطة الذكاء الاصطناعي، أو مكررًا، أو ذا جودة منخفضة…
فإن العدد الكبير لن يعني شيئًا ذا قيمة.
ومن ناحية أخرى، إذا كانت البيانات قادمة من بلدان مختلفة ولغات مختلفة وبيئات معيشية مختلفة، وكان وراءها فعلًا أشخاص حقيقيون تمتْ عملية التحقق منهم، فقد تكون القيمة مختلفة تمامًا.
KGeN الآن يتجه في هذا الاتجاه.
حاليًا تُعرّف الجهة الرسمية الشبكة على أنها Verified Human Network، وتمتد كذلك لتشمل بيانات متعددة الوسائط وPhysical AI وLLM.
وأكثر ما يعجبني شخصيًا في هذا النوع من المشاريع هو أنه:
لا يحاول فقط أن يقول لك «الذكاء الاصطناعي مثير جدًا، لذا يجب أن نستخدم الذكاء الاصطناعي أيضًا».
بل ينطلق من سؤال محدد نسبيًا:
عندما يصبح الذكاء الاصطناعي أقوى أكثر فأكثر، أين يمكن أن نجد بعد ذلك بشرًا حقيقيين؟
هل لهذا السؤال قيمة؟ أعتقد أنه لا داعي للتعجل في إصدار حكم.
دعنا ننظر إلى احتياجات البيانات المستقبلية، والشراكات التجارية، والحالات الواقعية للاستخدام؛ فالجواب سينبثق من ذلك طبيعيًا.
أهم ما في مشروع بحثي ليس أن يعلن مبكرًا عن «مئة ضعف»، بل أن يوضح أولًا المشكلة التي يحلها.
وهذا أيضًا أكبر انطباع لدي بعد اطلاعي مؤخرًا على KGeN.
#KGEN 🟩
في السابق، عندما كنت أرى مثل هذه المشاريع، كنت أنظر أولًا إلى:
سعر العملة.
أما الآن، فأطرح أولًا السؤال:
ما المشكلة التي يحلّها هذا فعليًا؟
إجابة KGeN بالنسبة لي كانت بسيطة نسبيًا:
تحتاج الذكاء الاصطناعي إلى بيانات، لكن في المستقبل قد نحتاج أكثر إلى «بيانات بشرية موثوقة».
هذا المنطق ليس صعب الفهم.
افترض أنك تجعل الذكاء الاصطناعي يتعلم من 100 مليون قطعة من محتوى الإنترنت.
يبدو ذلك كثيرًا جدًا.
لكن إذا كان جزء كبير من هذا المحتوى نفسه مُولّدًا بواسطة روبوتات، أو بواسطة الذكاء الاصطناعي، أو مكررًا، أو ذا جودة منخفضة…
فإن العدد الكبير لن يعني شيئًا ذا قيمة.
ومن ناحية أخرى، إذا كانت البيانات قادمة من بلدان مختلفة ولغات مختلفة وبيئات معيشية مختلفة، وكان وراءها فعلًا أشخاص حقيقيون تمتْ عملية التحقق منهم، فقد تكون القيمة مختلفة تمامًا.
KGeN الآن يتجه في هذا الاتجاه.
حاليًا تُعرّف الجهة الرسمية الشبكة على أنها Verified Human Network، وتمتد كذلك لتشمل بيانات متعددة الوسائط وPhysical AI وLLM.
وأكثر ما يعجبني شخصيًا في هذا النوع من المشاريع هو أنه:
لا يحاول فقط أن يقول لك «الذكاء الاصطناعي مثير جدًا، لذا يجب أن نستخدم الذكاء الاصطناعي أيضًا».
بل ينطلق من سؤال محدد نسبيًا:
عندما يصبح الذكاء الاصطناعي أقوى أكثر فأكثر، أين يمكن أن نجد بعد ذلك بشرًا حقيقيين؟
هل لهذا السؤال قيمة؟ أعتقد أنه لا داعي للتعجل في إصدار حكم.
دعنا ننظر إلى احتياجات البيانات المستقبلية، والشراكات التجارية، والحالات الواقعية للاستخدام؛ فالجواب سينبثق من ذلك طبيعيًا.
أهم ما في مشروع بحثي ليس أن يعلن مبكرًا عن «مئة ضعف»، بل أن يوضح أولًا المشكلة التي يحلها.
وهذا أيضًا أكبر انطباع لدي بعد اطلاعي مؤخرًا على KGeN.
#KGEN 🟩