$ETH فيتالik: تصميم الآليات الخصامية قد يكون المفتاح لسلامة الذكاء الاصطناعي
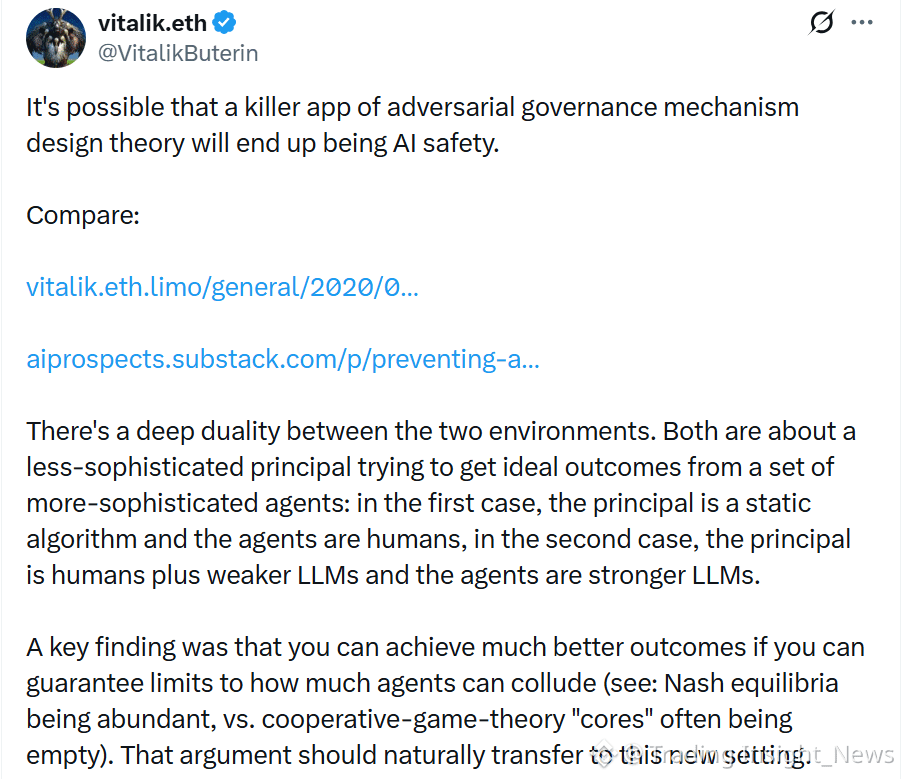
لقد أجرى فيتاليك بوتيرين مقارنة لافتة: يمكن أن يكون لتصميم الآليات الخصامية، وهو مجال مألوف في التشفير، تطبيق مهم لسلامة الذكاء الاصطناعي.
كلا المجالين يشتركان في بنية ثنائية عميقة بين الموكِّل والوكيل:
في التشفير: الموكِّل خوارزمية ثابتة (قدرة أضعف)، والوكيل إنسان (قدرة أقوى).
في الذكاء الاصطناعي: الموكِّل إنسان وLLM أضعف، والوكيل LLM أقوى.
تشير أبحاث ذات صلة إلى أنه إذا تمكنت من تقييد مستوى التواطؤ بين الوكلاء، يمكنك تحقيق نتائج أفضل. قد ينطبق هذا الاستنتاج مباشرة على سلامة الذكاء الاصطناعي.
هذه واحدة من أكثر الأفكار إثارة للاهتمام التي شاركها فيتاليك مؤخرًا. المشكلة الأساسية لسلامة الذكاء الاصطناعي هي: كيف يتحكم البشر في نظام أكثر ذكاءً منهم؟
الإجابة التي تعلمها التشفير عبر سنوات: لا تتحكم بالثقة، تحكم بتصميم الآليات. وقد أثبتت الآليات الخصامية التي تكون فيها الأطراف ذات مصالح متعارضة وتراقب بعضها بعضًا فعاليتها في بروتوكولات البلوك تشين.
إن تطبيق هذا المنطق على الذكاء الاصطناعي يمثل نهجًا جديدًا. بدلًا من محاولة «تدريب» الذكاء الاصطناعي ليكون جيدًا، يمكننا تصميم بيئات يقوم فيها وكلاء الذكاء الاصطناعي بفحص بعضهم بعضًا ووضع قيود متبادلة.
ما رأيك: هل يمكن أن تكون الآليات الخصامية حلًا حقيقيًا لسلامة الذكاء الاصطناعي، أم مجرد طرح نظري؟
الأخبار هي للرجوع فقط وليست نصيحة استثمارية. يُرجى القراءة بعناية قبل اتخاذ أي قرار.
لقد أجرى فيتاليك بوتيرين مقارنة لافتة: يمكن أن يكون لتصميم الآليات الخصامية، وهو مجال مألوف في التشفير، تطبيق مهم لسلامة الذكاء الاصطناعي.
كلا المجالين يشتركان في بنية ثنائية عميقة بين الموكِّل والوكيل:
في التشفير: الموكِّل خوارزمية ثابتة (قدرة أضعف)، والوكيل إنسان (قدرة أقوى).
في الذكاء الاصطناعي: الموكِّل إنسان وLLM أضعف، والوكيل LLM أقوى.
تشير أبحاث ذات صلة إلى أنه إذا تمكنت من تقييد مستوى التواطؤ بين الوكلاء، يمكنك تحقيق نتائج أفضل. قد ينطبق هذا الاستنتاج مباشرة على سلامة الذكاء الاصطناعي.
هذه واحدة من أكثر الأفكار إثارة للاهتمام التي شاركها فيتاليك مؤخرًا. المشكلة الأساسية لسلامة الذكاء الاصطناعي هي: كيف يتحكم البشر في نظام أكثر ذكاءً منهم؟
الإجابة التي تعلمها التشفير عبر سنوات: لا تتحكم بالثقة، تحكم بتصميم الآليات. وقد أثبتت الآليات الخصامية التي تكون فيها الأطراف ذات مصالح متعارضة وتراقب بعضها بعضًا فعاليتها في بروتوكولات البلوك تشين.
إن تطبيق هذا المنطق على الذكاء الاصطناعي يمثل نهجًا جديدًا. بدلًا من محاولة «تدريب» الذكاء الاصطناعي ليكون جيدًا، يمكننا تصميم بيئات يقوم فيها وكلاء الذكاء الاصطناعي بفحص بعضهم بعضًا ووضع قيود متبادلة.
ما رأيك: هل يمكن أن تكون الآليات الخصامية حلًا حقيقيًا لسلامة الذكاء الاصطناعي، أم مجرد طرح نظري؟
الأخبار هي للرجوع فقط وليست نصيحة استثمارية. يُرجى القراءة بعناية قبل اتخاذ أي قرار.