


العنوان الأصلي: (وحيد القرن في مجال الذكاء الاصطناعي القانوني بتقييم 1.1 مليار دولار استثماره OpenAI، يبدأ “تغليف” نماذج صينية مفتوحة المصدر)
المؤلف الأصلي: BeatingDong察
20 أغسطس، شركة الذكاء الاصطناعي القانونية Harvey التابعة للاستثمار من OpenAI أعلنت عن Tenet. تأسست الشركة في عام 2022، وتبلغ قيمتها الآن 11 مليار دولار، وهي شركة الذكاء الاصطناعي القانونية بتقييم أعلى عالميًا. تقدم خدماتها لأكثر من ألف مؤسسة، ويضم جدول المساهمين Sequoia و a16z و GIC أيضًا.
Tenet هو أول نموذج مملوك لها. أما القاعدة فتعتمد على أوزان Kimi K3 التي تم فتحها في شهر يوليو من جهة “الجانب المظلم من القمر”. لا يزال Tenet حاليًا ضمن مرحلة المعاينة البحثية، وتخطط Harvey لإدراج القدرات التي تم التحقق منها تدريجيًا في المنتج.
كان مؤسس Harvey Winston Weinberg في الأصل محاميًا في مجال التقاضي في O'Melveny & Myers، وقد عمل Gabe Pereyra على أبحاث نماذج كبيرة في Google Brain وMeta. استثمر OpenAI فيها منذ وقت مبكر، ومن ثم تدرب الطرفان معًا على نموذج خاص بالسوابق القضائية، بإدخال حوالي 10 مليارات توكن من بيانات سوابق الولايات المتحدة القانونية في التدريب. وفي الحالات العميلية التي نشرتها OpenAI آنذاك، قال Pereyra إن Harvey قيّم خيارات مختلفة في النهاية وثق فقط بالخيار الذي تم إنجازه مع OpenAI لإجراء هذا التدريب المخصص.
على مدى السنوات القليلة الماضية، كانت هذه شبه الدائمة هي الشركة العميلة الأكثر نموذجية في قطاع الخدمات المهنية ذات النماذج المغلقة المصدر، كما كانت قادرة على الاستفادة من أقوى مجموعة من النماذج المغلقة عالميًا. ولكن عندما قررت لأول مرة إدخال مهامها القانونية، ومعايير تقييم المحامين، وقدرة الحوسبة لمدة شهرين فعليًا داخل مجموعة أوزان، كان الأساس الذي تم اختياره نموذجًا مفتوح الأوزان قادمًا من الصين.
بعد أن يتم إصدار نموذج، يعرف القطاع بسرعة أمرين: كم هو ذكي؟ وكم تُباع هذه القدرات به؟ خلال ساعات قليلة، تتحدث أخبار تحديثات الاختبارات المعيارية، وتتغير ترتيب Arena، وتبدأ خرائط مختلفة تُظهر العلاقة بين القدرات والأسعار بالانتشار. في النهاية يتم ضغط نموذج تم تدريبه لأشهر واستهلك قدرًا كبيرًا من الحوسبة إلى مجرد نقطة على الرسم البياني.
بالنسبة لمعظم المطورين، تظل هذه الطريقة فعالة. والافتراض الكامن وراءها هو أن قدرات النموذج تكون قد استقرت تقريبًا عند وصوله إلى المستخدم. وهذا الافتراض صحيح عندما تسود واجهات API المغلقة المصدر. تقوم شركات النماذج بإجراء التدريب المسبق والتدريب اللاحق، ثم تُغلّف القدرات في صورة واجهات. تستطيع الشركات في المنبع تعديل التعليمات، وإجراء البحث، وبناء وكلاء أذكياء، لكنها لا تستطيع تغيير النموذج نفسه بشكل أكبر.
كسر «الأوزان المفتوحة» هذا الافتراض. بعد حصول الشركات على الأوزان، يمكنها الاستمرار في إدخال بياناتها وتغذيتها الراجعة من الخبراء، وإحضار المهام الحقيقية ومعايير التقييم إلى التدريب. وبنفس الطريقة: نموذجين يحصلان على 90 نقطة عند الإطلاق، لكن مع نفس الدفعة من البيانات وقدرة الحوسبة للاستمرار في التدريب—أحدهما يتوقف عند 91 نقطة، والآخر يمكن أن يصل إلى 97 نقطة. وبالنسبة للشركات التي تستعد للاستثمار لأشهر في الوقت وقدرة الحوسبة وموارد الخبراء، فإن نشر نموذج بدرجة 90 نقطة، مع أنهما متساويان عند الإطلاق، قد يصبح فرقًا شاسعًا.
لكن لهذا الأمر شرط. إذا كانت الشركات راغبة في المراهنة على بضعة أشهر من الوقت وقدرة الحوسبة لمواصلة التدريب، فعليها أولًا أن تملك مجموعة أوزان تستحق التدريب. في السنوات الماضية، كانت هناك دائمًا مسافة بين النماذج المفتوحة المصدر والأكثر تقدمًا من النماذج المغلقة. كان الفرق في الأسئلة العامة والكتابة اليومية للكود ليس كبيرًا، لكن بمجرد الدخول إلى سيناريو مهني تكون فيه كلفة الأخطاء مرتفعة جدًا، تصبح هذه المسافة أكبر. والقانون من بين أعلى المجالات طلبًا للدقة؛ وفي الماضي كانت الشركات التي استطاعت حقًا الوصول إلى الأعمال الأساسية مثل Harvey، هي في الغالب الشركات التي كانت تمتلك آنذاك أقوى مجموعة نماذج مغلقة المصدر. الأوزان المفتوحة بالطبع أسهل في التحكم وإعادة التشكيل، لكن إذا لم يكن بإمكانها حتى إنجاز أبسط المهام المهنية، فلا معنى للحديث عن مساحة تدريب لاحقة.
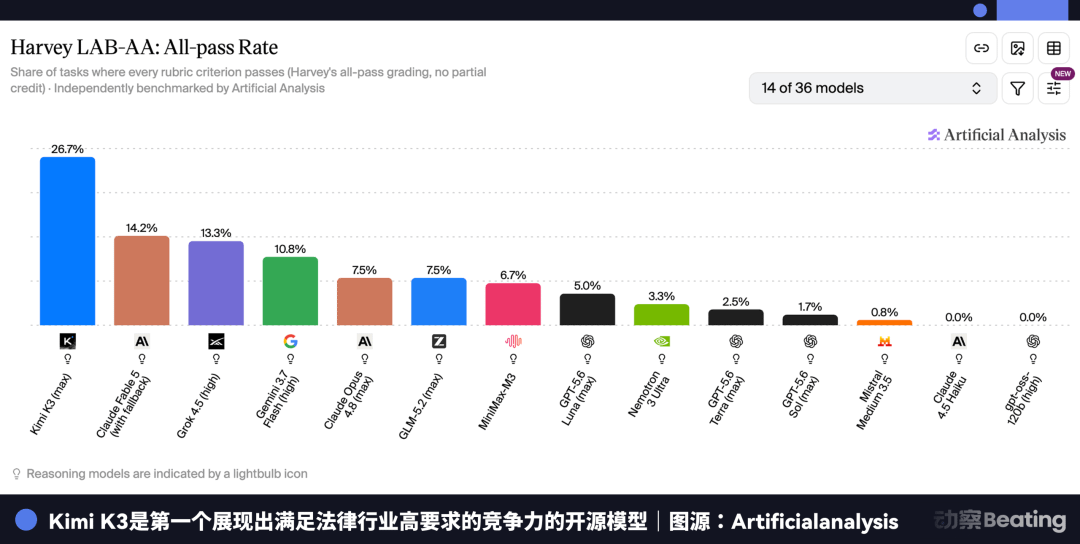
اجتاز Kimi K3 هذا العائق طويل الأمد لأول مرة. إجمالي عدد معلماتِه يصل إلى 2.8 تريليون، ويدعم سياقًا حتى مليون توكن، ولديه بالفعل أساس جيد في مهام طويلة المدى واستخدام الأدوات والاستدلال المعقد. وبالنسبة لـ Harvey، فإن نموذج الأوزان المفتوحة لأول مرة لم يعد مجرد بديل أرخص كلفة وأكثر تحكمًا، بل بدأ يدخل نطاقًا يمكن تقييمه بجدية مع النماذج المتقدمة.
وهكذا بدأت تهتم بسؤال لم يكن يُناقَش كثيرًا بشكل منفصل في الماضي: إلى أي مدى تكون هذه الأوزان قابلة للتدريب المتواصل؟
عندما درّب Cursor Composer 2 لم يُقم باختيار النموذج وفق قوائم «وكلاء البرمجة الذكية» الشائعة. كان حكمه أن قدرات الوكلاء ومهام المدى الطويل ستتغير بشكل كبير خلال التعلم المعزز، وأن الترتيب قبل بدء التدريب لا يضمن توقع النتيجة النهائية. وبالمقارنة مع نقاط القوائم، ركز Cursor أكثر على معرفة النموذج بالبرمجة، وقدرته على تتبع الحالة، ومدى «ارتباكه» داخل قاعدة الشيفرة البرمجية الداخلية، وكفاءة تشغيله في البنية التحتية الخاصة به. في النهاية، كان الأساس المختار هو نموذج Kimi K2.5.
لدى Cognition خلف Devin أيضًا حكم مماثل. بعد فتح أوزان K3، ضمّت بسرعة النموذج إلى Devin Desktop وCLI، وعلى FrontierCode 1.1 Extended في البنية الداخلية لديها، حصل K3 على 58.2% درجة و63.6% نسبة اجتياز. هذا الاختبار يقيّم مهام هندسية حقيقية؛ وهل يمكن دمج الكود في الفرع الرئيسي في النهاية، وما إذا كانت الجودة كافية، كلها تدخل في الحساب. كما أشارت Cognition إلى أن أداء K3 كان ممتازًا بشكل خاص في إعادة إنتاج الأخطاء (bugs) وإدارة بيئة تشغيله الخاصة—وهاتان هما أكثر نقطتين عرضة للسقوط في مهام البرمجة طويلة المدى. ثم قامت Cognition أيضًا بالتدريب اللاحق على هذه الأوزان.
إن الشيء النادر حقًا ليس البيانات القانونية
ينمو Harvey بسرعة. في شهر مارس من هذا العام، كان يخدم نحو 1300 مؤسسة وأكثر من 100 ألف محامٍ. وبعد خمسة أشهر، تضاعف عدد العملاء تقريبًا، ووصل إلى 70 دولة، وأكثر من ثلاثة أرباع مكاتب AmLaw 100 تستخدم Harvey.
قيمة مشاريع الخدمات القانونية مرتفعة، والتسامح تجاه الأخطاء منخفض جدًا. في تقرير تدقيق قانوني لاندماج أو استحواذ، قد يتطلب العثور على بنود انتقال السيطرة داخل مئات أو آلاف الوثائق، ثم الحكم إن كانت الصفقة تُفعّل شرطًا ما، ثم تحديد المخاطر وإرفاق الدليل من النص الأصلي. وغالبًا ما توجد عشرات الأحكام التي يجب أن تتحقق بشكل متتابع. فإذا تم تفويت نقطة واحدة تؤثر حقًا على الصفقة، فإن أغلب العمل الذي تم إنجازه بشكل صحيح في البداية لا يكون له معنى كبير.
ومع ازدياد عدد مكاتب المحاماة التي تقدم الخدمة، تراكم لدى Harvey نوع من بيانات الأساس التي يصعب على شركات نماذج أخرى الحصول عليها بنفسها. فهي تعرف كيف سيُوزع المحامي مهمة ما، وتعرف أيضًا من أين سيفحص الشريك الناتج النهائي بحثًا عن الأخطاء.
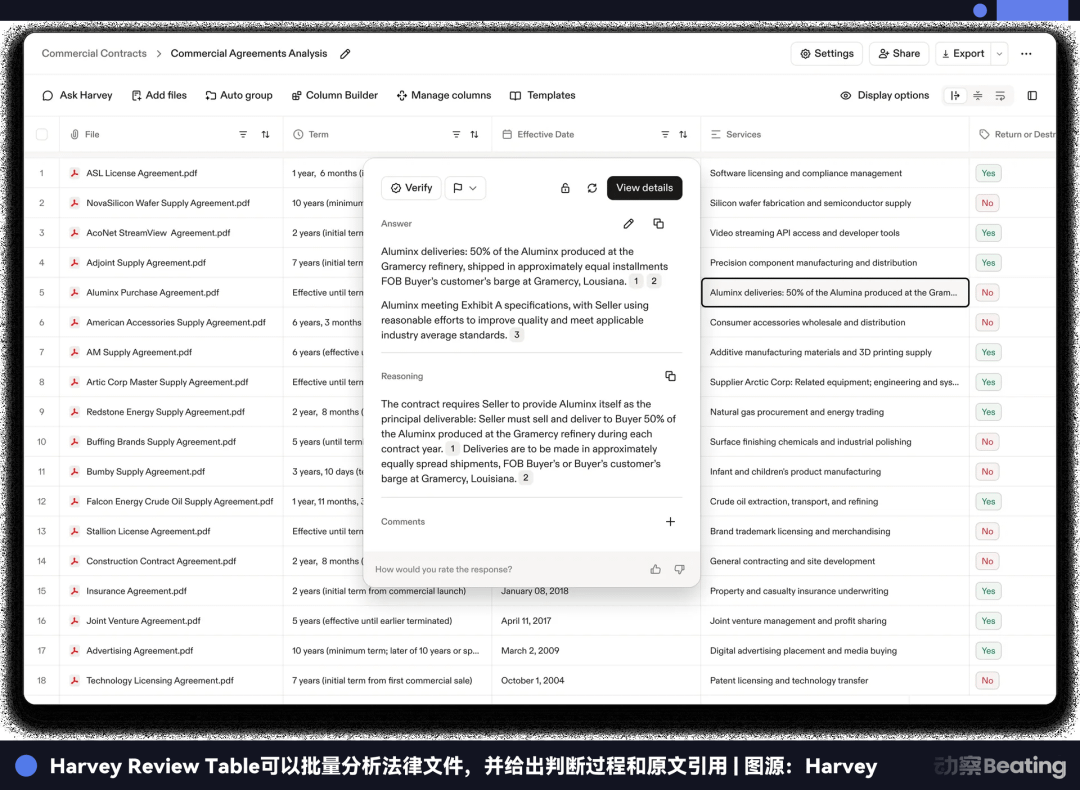
تم لاحقًا تحويل هذه الخبرات إلى Legal Agent Benchmark. يوجد داخله أكثر من 1200 مهمة قانونية طويلة المدى، تغطي 24 مجالًا مهنيًا. متوسط وصف كل مهمة لا يتجاوز نحو 50 كلمة، ثم ينتقل النموذج إلى بيئة مغلقة للقضايا الخاصة بالعميل. تُخلط الوثائق مع كمّ كبير من المواد غير ذات الصلة، ويجب عليه أن يبحث ويقرأ ويُجري أحكامًا، وفي النهاية يُسلم ناتج عمل يمكن فحصه بندًا بندًا.
لكل مهمة، يوجد في المتوسط نحو 50 معيار تقييم، ويمكن أن تصل المهام المعقدة إلى بضع مئات من المعايير. هل تم العثور على جميع الوقائع؟ هل يمكن أن تصمد النتيجة؟ هل تتطابق الإحالات مع النص الأصلي؟ هل مستوى المخاطر والتوصيات معقولة؟ كل ذلك يُفكك إلى عناصر تقييم يمكن الحكم عليها منفردة. يمكن أن تستمر المهمة الواحدة لأكثر من 1000 جولة كحد أقصى، ما يستهلك عشرات الآلاف من التوكنات.
بعد بضع سنوات من عمل المحامي الشاب، يبدأ تدريجيًا في معرفة ما الذي يقلق العميل حقًا، وكذلك يتذكر أي بنود تبدو غير مهمة لكنها لا يجوز تفويتها. كانت هذه الخبرات في الماضي صعبة جدًا على أن تُكتب كاملة في الكتب الدراسية؛ إذ غالبًا ما تبقى في تعديلات الشركاء، وفي عادات العمل داخل الفريق، وفي أكوام من الوثائق التي تم تسليمها بالفعل.
قسّم Harvey جزءًا من ذلك إلى مهام ومواد ومعايير تقييم، وأصبح مسار إتمام النموذج للعمل نفسه يولد ملاحظات يمكن حسابها والمقارنة بينها.
يمكن للتعليمات والبحث أن تخبر النموذج أين يبحث، بينما تبدأ معايير التقييم في الإجابة عن سؤال آخر: إلى أي مدى يجب أن يُنجز العمل القانوني حتى يُعد مكتملًا؟ وقد راكم Harvey خلال السنوات الماضية، بالإضافة إلى العملاء وبيانات القانون، منظومة تقييم احترافية يمكن استخدامها مباشرة في تدريب النموذج.
كتابة الخبرة القانونية في الأوزان
بدأت تلك المهام ومعايير التقييم تدخل فعليًا في التدريب. جاءت البيانات من مواد قانونية منشورة، وبيانات مُولّدة صناعيًا، وبيانات من خبراء بشريين. وشارك المحامون الممارسون في بناء المهام وتقييمها والتحقق من البيانات الاصطناعية. جهز Harvey إجمالًا نحو 1750 بيئة مهمة لوكلاء قانونيين.
عندما يدخل النموذج إلى مساحة العمل التي تحتوي على مواد وأدوات، عليه أن يقرأ الملفات بنفسه ويدعو الأدوات ويقدّم النتائج، ثم يقوم النظام بمراجعة مسار العمل بالكامل وفقًا للمعايير التي يضعها المحامون: ما مدى تحقق المتطلبات المحددة؟ وما مدى معالجة المشكلة القانونية؟ إذا اجتازت جميع المتطلبات الأساسية، سيحصل أيضًا على مكافأة إضافية.
ينتج عن كل دورة تدريبية أكثر من 10 آلاف مسار مهام. يستخدم Harvey استراتيجية تتابع المجموعات لتحسين الأداء، أي GSPO، بحيث يُنتج النموذج على نفس المهمة عدة طرق، ثم يتم تحديث الأوزان بناءً على فروق جودة النتائج. وعندما تكون درجات مسارين متقاربة جدًا، يقوم النظام بإعادة التقييم لتقليل تأثير ضوضاء التقييم على التدريب.
استمر كامل العملية حوالي شهرين، باستخدام نحو 150 بطاقة NVIDIA B300. عادةً يتطلب تدريب نموذج متقدم مسبقًا استخدام عشرات الآلاف من البطاقات، وكانت قدرة الحوسبة التي استثمرها Harvey هذه المرة على مستوى مختلف تمامًا. استخدم Harvey rank-64 LoRA، يغطي طبقات الانتباه في Kimi K3 والشبكات الأمامية وأوزان خبراء التوجيه، وهو ما يتضمن حوالي 500 ألف قالب توتر (tensors) خاصة بالخبراء.
تواجه التدريب على المسارات الطويلة أيضًا مشكلة هندسية. قد تستمر مهمة قانونية لأكثر من عدة مئات من الجولات. بينما يكون النموذج ما يزال يقوم بتوليد مسار المهمة، تكون أوزان جانب التدريب قد تم تحديثها بالفعل. وعندما يعود جهاز التدريب إلى حساب هذه الرحلة، إذا لم تتطابق حالة النموذج بين الطرفين، فسيتغير أيضًا احتمال كل خطوة في ذلك الوقت، مما يجعل المكافأة صعبة جدًا على أن تُطبق بدقة على القرارات الأصلية.
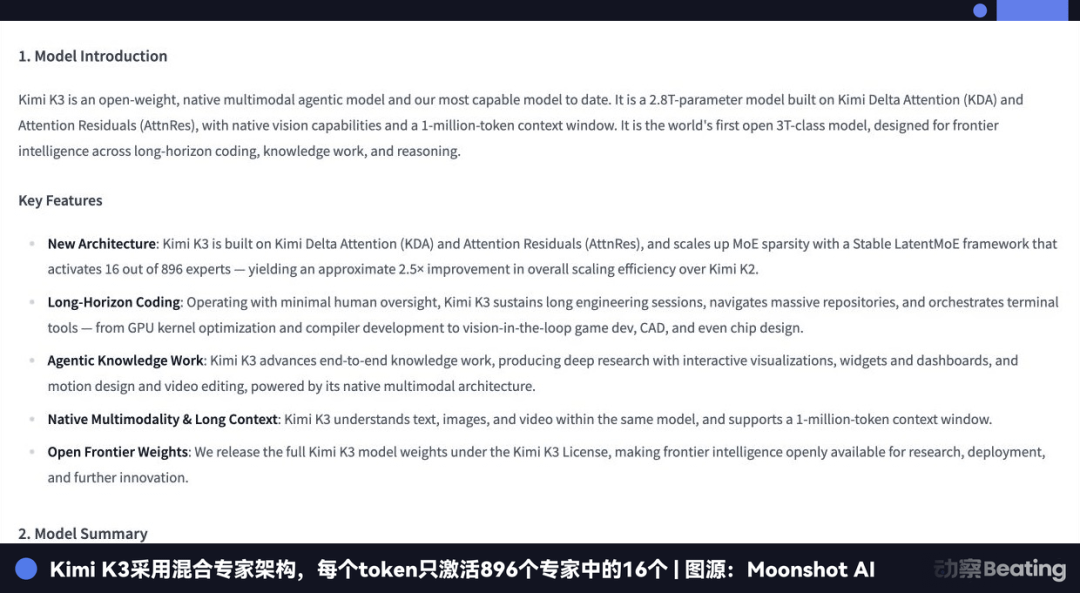
تجعل بنية الخبراء المختلطة في Kimi K3 هذه المشكلة أكثر تعقيدًا. بعد أن يدخل كل token إلى النموذج، يختار جهاز التوجيه 16 خبيرًا من بين 896 خبيرًا للمشاركة في الحساب. وفي حالة وجود اختلافات صغيرة بين جانب التدريب وجانب التنفيذ—مثل دقة الأرقام أو طريقة المعالجة المجمعة—يمكن أن يُحال نفس الـ token إلى خبراء مختلفين، وبالتالي يصعب إعادة إنتاج المسار الأصلي بالكامل.
لهذا السبب قام Harvey ومورّدوه بمحاذاة رقمية لجهاز التدريب وبيئة التنفيذ على مستوى النواة. كلما تم إجراء تحديث واحد للأوزان، يتم تحميله فورًا بشكل «ساخن» في بيئة التنفيذ، دون الحاجة إلى التوقف المتكرر لإعادة توليد المهام. كذلك يسجل النظام نتائج توجيه التوكنات المقابلة لمسارات الخبراء، بحيث عند إعادة حساب جهاز التدريب يمكن قدر الإمكان العودة إلى المسار الذي سلكه النموذج عند توليد تلك الرحلة أول مرة.
عندما وصل Tenet إلى هذه المرحلة، لم يعد يشبه كثيرًا مجرد ضبطٍ عادي لإضافة محتوى قانوني إلى نموذج. ما قام Harvey ببنائه هو عملية تدريب يمكن تشغيلها مرارًا وتكرارًا. تدخل المهام القانونية إلى البيئة باستمرار، وينجز النموذج العمل، ثم تُقيّم المسار بأكمله وفقًا للمعايير التي يضعها المحامي، وبعد ذلك يتم تحديث الأوزان، ثم يعود النموذج الجديد إلى البيئة لإنجاز جولة مهمة جديدة.
يُختبر بشكل واقعي داخل هذا النوع من الحلقة ما إذا كان يمكن تدريب Kimi K3 بشكل مستقر بشكل مستمر.
بعد التدريب، أصبح أقرب إلى Agent قانوني.
ما أراد Harvey تحسينه حقًا هو قدرة النموذج على إتمام الأعمال القانونية طويلة المدى. فهو يستخدم معيار all-pass شديد الصرامة: يجب أن تجتاز جميع المعايير التقييمية الأساسية داخل مهمة واحدة. ووفقًا للنتائج الداخلية التي نشرها Harvey، على مجموعة LAB الاحتياطية التي لم تشارك في التدريب، فإن عدد المهام التي أكملها Tenet بالكامل قريب من ضعفي عدد المهام التي أكملها Kimi K3 الأصلي، وارتفعت نسبة all-pass من نحو 11% إلى 19.7%، أي بزيادة تقارب 9 نقاط مئوية.
في LAB Contracts، وهي مجموعة اختبار متخصصة لصياغة ومراجعة ومفاوضة العقود، زاد عدد المهام المكتملة بحوالي 20%، وبلغت نسبة all-pass 11.3%، بزيادة تقارب نقطتين مئويتين. ووفقًا لقائمة Harvey الخاصة، جاء Tenet في المرتبة الأولى ضمن LAB Contracts، وفي المرتبة الثانية ضمن مجموع LAB الكامل.
ثم أدخل Tenet في اختبارين خارجيين: Mercor's APEX Agents Corporate Law وCrosby’s Redline Bench. اختبر الأول مهامًا مهنية طويلة المدى داخل بيئة عمل محاكاة، بينما يتطلب الثاني تعديل العقود بشكل متواصل، ثم تقييم الأداء وفقًا للمعايير التي وضعها المحامون.
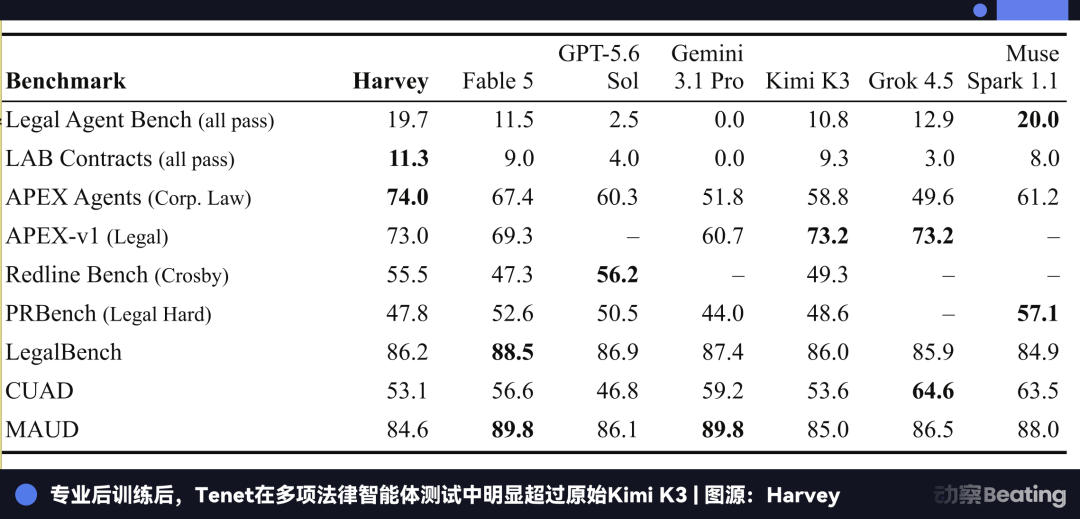
لم تتعرض Tenet لبيانات التدريب الخاصة بهاتين المجموعتين من الاختبارات، ومع ذلك ظل أداؤها أعلى بوضوح من Kimi K3 الأصلي. وهذا يعني أن القدرات المتعلمة داخل بيئة مهام Harvey يمكن نقلها إلى مهام قانونية جديدة.
لكن المشكلة الأخرى هي أن التدريب اللاحق في مجالٍ متخصص غالبًا ما يجعل النموذج يتقن نوعًا معينًا من الأعمال أكثر فأكثر، بينما يفقد جزءًا من المعرفة الأصلية وقدرات الاستدلال.
في LegalBench وCUAD وMAUD، لم يظهر Tenet أي تراجع واضح. ضمن مجموعة الصعوبات في Scale Professional Reasoning Benchmark، ارتفعت الدرجة قليلًا من 36.0% إلى 36.8%. وعلى الأقل من هذه النتائج، بعد أن أصبح Kimi K3 أقوى في مهام القانون، لم يظهر مشكلة نسيان للقدرات بشكل واضح.
يميل تصميم مكافآت Harvey إلى المسارات الأقصر عندما تكون جودة النتائج متقاربة، لأن الوكيل القانوني كلما قرأ ملفًا إضافيًا أو استدعى أداة إضافية، يزداد استهلاك التوكنات وزمن الانتظار. بعد التدريب، قلل Tenet جزءًا من الخطوات غير الفعالة، ومع تحسن جودة المهمة بقيت تكلفة إنجاز العمل شبه ثابتة.
والذي تغيّر في هذا التدريب اللاحق أكثر من غيره هو طريقة Kimi K3 في التعامل مع الأعمال القانونية المعقدة. فصار أكثر حرصًا على ترتيب الخطوات واستدعاء الأدوات، وأقل عرضة لتفويت المتطلبات الأساسية داخل المهمة.
بدأ Harvey اعتماد استراتيجية تعدد النماذج منذ عام 2025، وما زال حتى هذا العام مستمرًا في ربط نماذج جديدة من OpenAI وAnthropic. جعل Tenet أخيرًا هذه المنظومة تضيف لأول مرة نموذجًا مفتوح الأوزان تم تدريبه والتحكم فيه من قِبل Harvey نفسه داخل النظام.
ما يحتاجه هو منصة أساس (底座) جاهزة للنضج بحد ذاتها. قد تتعامل مهام Harvey القانونية مع عدد كبير من الملفات، وتنفيذ مئات بل وآلاف الجولات بشكل متواصل، ويجب أن يحافظ النموذج على الحالة خلال العمل الطويل. يمكن للتدريب اللاحق أن يشكل طريقة تعاملِه مع العمل القانوني، لكنه من الصعب جدًا أن يُلحق من البداية مجموعة قدرات لم تكن موجودة أصلاً في أساسه.
الشرط الآخر هو التحكم. يمكن لـ Harvey استدعاء GPT وClaude عبر واجهة برمجة التطبيقات، لكنه لا يستطيع إدخال 1750 بيئة مهمة قانونية ومعايير تقييم المحامين داخل تلك النماذج المغلقة المصدر. تتيح الأوزان المفتوحة له أن يقرر بنفسه كيفية التدريب وكيفية تصميم المكافآت، كما يمكنه أيضًا الاحتفاظ بالقدرات المهنية التي تم تعلمها داخل الأوزان التي يملكها.
لكن بعد الحصول على الأوزان، يبقى اختبار ما إذا كانت هذه المجموعة من النماذج مناسبة لمواصلة التدريب. هل يمكن للتعلم بالتعزيز لمسارات طويلة أن يعمل بثبات؟ هل يمكن أن تُعيد توجيهات الخبراء المختلطة إنتاج النتائج بدقة؟ وهل يؤدي تحسن القدرات المهنية إلى فقد المعرفة الأصلية؟ وهل يمكن إبقاء تكلفة الاستدلال ضمن نطاق قابل للاستخدام في الإنتاج؟ لا يمكن معرفة ذلك إلا بعد التجربة فعليًا مرة واحدة.
بعد انتهاء Harvey من التدريب لمدة شهرين، قدم Kimi K3 إجابات هذه الجولة. كان مسار التدريب قادرًا على العمل بثبات، وظهرت زيادة ملحوظة في قدرات المهام القانونية، ولم نرَ نسيانًا كبيرًا للقدرات، كما لم تفلت التكلفة عن السيطرة مع تحسن الأداء.
بالنسبة لـ Harvey، فإن هذه النتائج أهم من «الأوزان المفتوحة» نفسها. يمكن تنزيل الأوزان، وهذا فقط يعني أن الشركة مؤهلة لمواصلة التدريب. أما مقدار القدرات التي تبقى بعد التدريب، فهو ما يحدد ما إذا كان من الجدير الاستمرار في الاستثمار في هذه الأوزان بقدر الحوسبة والبيانات ووقت الخبراء.
صفقة أخرى لدى شركة النماذج
قال Harvey إن هدفه هو تمكين مكاتب المحاماة من تدريب نماذجها الخاصة على أوزان مفتوحة، وبحيث تمتلك القدرات المتولدة بعد التدريب. أما Tenet، فما هو أشبه بمجموعة نماذج؛ بل هو مجموعة أساليب.
في الماضي، كانت معظم أعمال شركات نماذج الأساس تحدث في الاستدعاءات بعد إصدار النموذج. قدمت الأوزان المفتوحة علاقة أخرى: يمكن لشركة أن تحصل على نموذج أساس جاهز وتكمله بالتدريب، وتُبقي خبرتها المعرفية في مجالها داخل الأوزان، وفي النهاية تحصل على نموذج أقرب إلى أعمالها.
كانت هذه النوعية من الاحتياجات صعبة جدًا سابقًا لتكوين سوق حقيقي. عندما لا تكون قدرات النماذج العامة قوية بما يكفي، حتى لو حصلت الشركات المتخصصة على الأوزان، فمن الصعب جدًا أن تُكمل تدريبًا لاحقًا وحده استدلالًا طويل المدى ونداءات الأدوات ومعالجة المهام المعقدة. إن تدريب نموذج من البداية مكلف جدًا، ومعظم الشركات لا ترى ضرورة لذلك أصلًا.
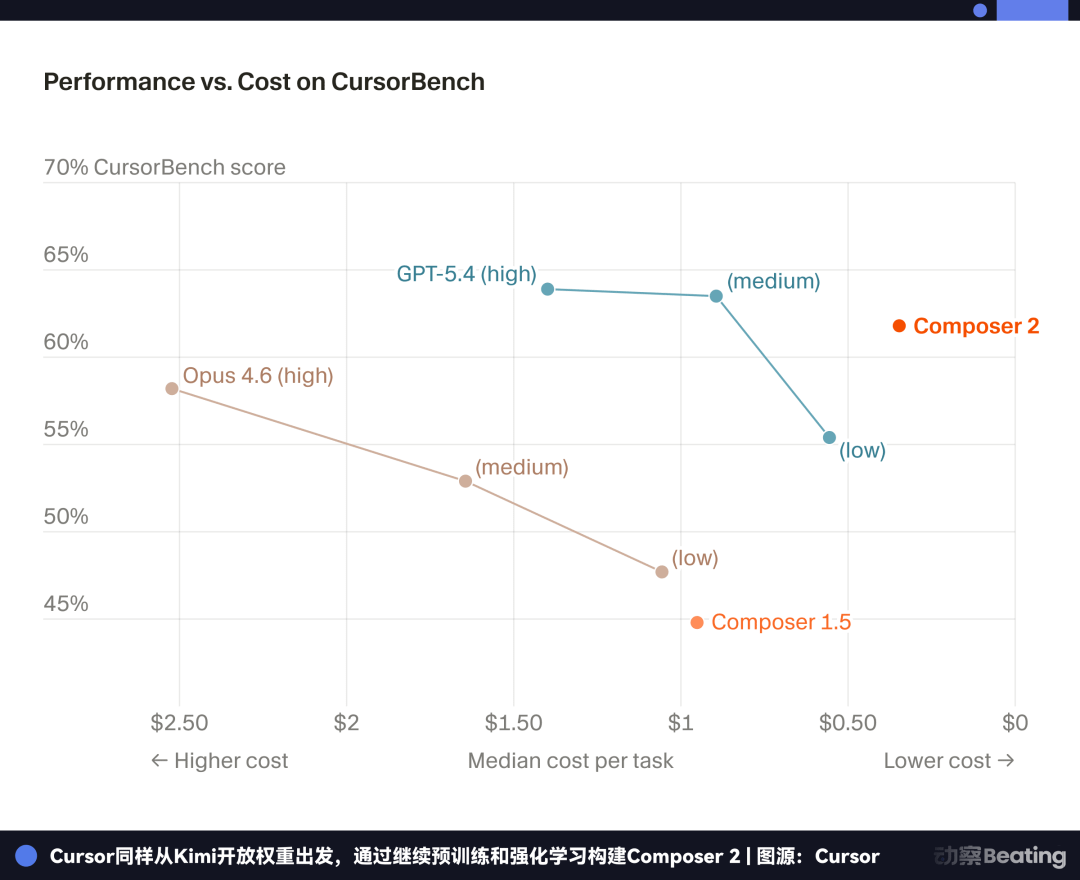
درّب Cursor في البرمجة Composer 2، وواصل Cognition أيضًا التدريب على نفس مجموعة الأوزان للنموذج الذي استخدمه Devin، ثم قام Harvey بإنتاج Tenet في مجال القانون. وبينما تبعد البرمجة عن القانون مسافة بعيدة، اختارت الاثنتان الانطلاق من القدرات العامة التي تدرب عليها Kimi، ثم إدخال أكثر أعمالهما المهنية تخصصًا التي يعرفانها جيدًا.
يخفض Tenet عتبة هذه العملية إلى شيء ملموس. خلال شهرين، مع نحو 150 بطاقة، بالإضافة إلى مجموعة معايير تقييم يحددها محامون ممارسون، يمكن لشركة واحدة أن تدفع مجموعة أوزان عامة إلى مقدمة صناعتها. كما انخفضت عتبة قدرة الحوسبة بمقدار رتبة، وبدأ الجزء الأصعب في الانتقال إلى الطرف الآخر: هل يمكن لأي شخص أن يوضح إلى أي درجة يجب إتمام عمل مهني حتى يُعد مكتملًا؟
تطوير البرمجيات والقانون مجرد مثالين ظهرتا بالفعل. فهناك قطاعات مثل التمويل والاستشارات والدواء والمحاسبة، فضلاً عن الكثير من مجالات الخدمات الاحترافية، جميعها لديها بياناتها وسير عملها وأحكام الخبراء الخاصة بها. وهذه القطاعات نفسها هي سوق أعمال معرفية بمقياس تريليونات الدولارات. أما الشركات الأبرز في القمة، فقد لا تقوم بتدريب نماذج الأساس لديها مسبقًا من الصفر بنفسها، لكنها تملك بشكل متزايد القدرة على الاستمرار في تدريب نموذجها ضمن مجموعة أوزان ناضجة جاهزة.
إذا بقيت هذه المسار على صحته، فلن يكون سوق Kimi بعد الآن مجرد عدد من الأشخاص الذين يستدعونها. والأكثر جدارة بالمتابعة بعد ذلك هو: بعد Harvey وCursor وDevin، كم عدد الشركات الأخرى التي ستختار تدريب نماذجها الخاصة على Kimi؟
رابط النص الأصلي