⚡️ تحديث بالذكاء الاصطناعي: معيارٌ للأمن السيبراني كان يُربك كل نماذج الذكاء الاصطناعي قبل عام تم كسره بالكامل الآن، وتترتب على ذلك تبعات في اتجاهين.
تختبر CyberGym شيئًا محددًا: هل يمكن لوكيل ذكاء اصطناعي قراءة وصف ثغرة وكود حقيقي، ثم توليد كود يعمل كتجربة لإثبات المفهوم (PoC) ينجح فعلاً في تشغيل الخطأ؟ لستُ هنا للحديث عن الأمن—بل للقيام بالأمن.
يستند هذا المعيار إلى 1,507 ثغرة تاريخية حقيقية عبر 188 مشروع برمجي، دون أمثلة لعب، ودون حالات اختبار مبسطة.
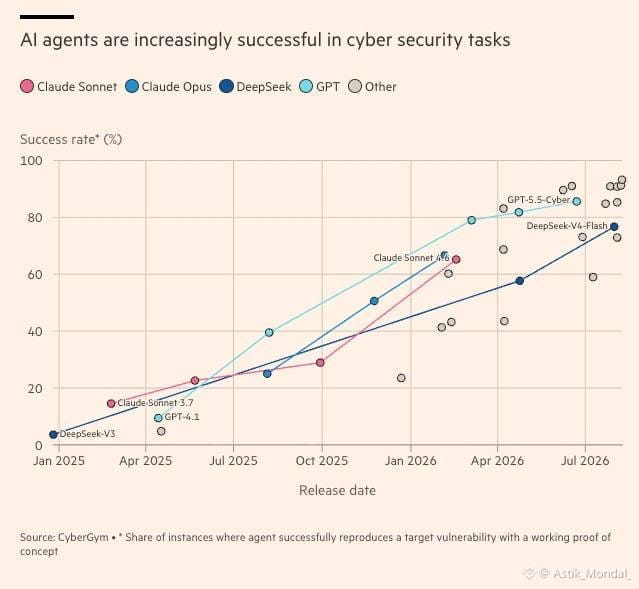
عندما نفّذ الباحثون هذا المعيار لأول مرة، لم ينجح أفضل دمج للذكاء الاصطناعي والوكلاء المتاح آنذاك إلا بحوالي 20% من المرات. اعتبر باحثو الأمن ذلك طمأنة، إذ ظل الاستغلال الذاتي شبه بعيد المنال.
لكن تلك الطمأنة ولّت. النماذج المتخصصة الأحدث باتت الآن تحقق معدلات نجاح 80%+ على المعيار نفسه، قفزة بأربع مرات خلال قرابة عام.
الأمر أكثر جدية من مجرد مطابقة الأنماط للأخطاء المعروفة. في اختبارات مفتوحة النهاية دون معرفة مسبقة بما هو معطّل، اكتشفت إعدادات الوكلاء نفسها بشكل مستقل ثغرات “يوم-صفر” مؤكدة، ومشكلات أمنية لم يكن أحد يعلم بوجودها حتى عثر عليها الذكاء الاصطناعي.
هذه هي الجزء المزعج في هذا الرسم. القدرة نفسها التي تُمكّن وكيل الذكاء الاصطناعي لدى المدافع من العثور على ثغرة وإصلاحها قبل أن يفعل المهاجمون، هي القدرة التي تُمكّن وكيل الذكاء الاصطناعي للمهاجم من العثور على الثغرة نفسها أولًا.
الهجوم والدفاع الآن يتسابقان على بنية تحتية متطابقة.
#AI #Cybersecurity #GPT5 #Claude #DeepSeek