

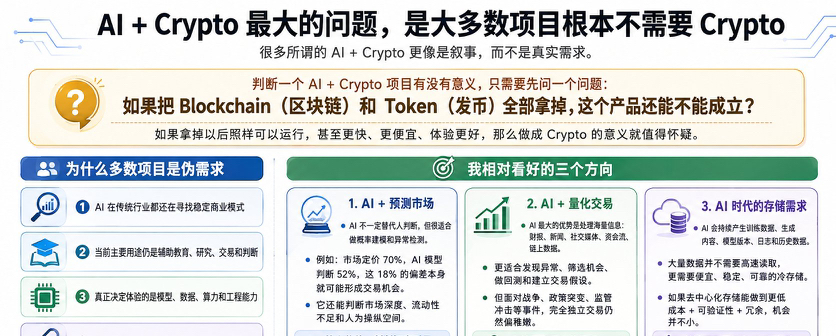


اليوم تحدثت بالصدفة مع أصدقاء @BNB_Chain حول موضوع الذكاء الاصطناعي + الكريبتو. وبالنسبة لي، فإن غالبية مشاريع AI + Crypto في السوق الآن هي في الواقع مجرد طلبات زائفة.
حتى الذكاء الاصطناعي نفسه ما يزال في الصناعات التقليدية في مرحلة التنفيذ السريع والبحث المستمر عن نماذج عمل. ولا توجد في الواقع الكثير من السيناريوهات التي يمكنها توليد دخل بشكل ثابت، وخفض التكاليف بشكل واضح، وتحسين الكفاءة كما يتخيل البعض. وبعد إدخاله إلى عالم الكريبتو، ستصبح هذه المشكلة أكثر وضوحًا.
أعتقد أن الذكاء الاصطناعي في الوقت الحالي ما زال في المقام الأول أداة مساعدة في التعليم، والبحث العلمي، والتداول، واتخاذ القرارات، بما في ذلك تنظيم بيانات السلسلة على السلسلة، وقراءة الأخبار، وتحليل المشاريع، وشرح العقود، والبحث عن فرص التداول وغيرها من الوظائف. لكن هذه الوظائف تعتمد فعليًا على قدرات النموذج، وجودة البيانات، وقوة الحوسبة، والقدرات الهندسية، وتكلفة الاستدلال. وفي كثير من الأحيان لا يؤدي البلوك تشين دورًا غير قابل للاستبدال.
لذلك، عندما أقيّم الآن ما إذا كان مشروع الذكاء الاصطناعي + الكريبتو له معنى أم لا، أبدأ بسؤال بسيط جدًا: إذا أزلنا Blockchain (البلوك تشين) وToken (إصدار العملة) بالكامل، هل سيظل هذا المنتج قادرًا على الوجود؟
إذا أزلنا ذلك وظل النظام يعمل، بل ربما أصبح أسرع وأقل تكلفة وأفضل تجربة للمستخدم، فسأجد صعوبة كبيرة في فهم لماذا يجب أن يكون مشروع كريبتو أصلًا. وعلى العكس، إذا كانت شركة ما تمتلك بالفعل نموذج ذكاء اصطناعي قويًا جدًا، أو قدرة حوسبة، أو قوة خوارزمية، فلا توجد حاجة كبيرة أصلًا للدخول قسرًا إلى الكريبتو. فأسواق رأس المال التقليدية، بالنسبة لشركات الذكاء الاصطناعي الممتازة فعلًا، مستعدة أصلًا لمنح تقييمات مرتفعة جدًا وشروط تمويل جيدة.
بالطبع، ما زلت أرى أن هناك ثلاثة اتجاهات من هذا الدمج أرى شخصيًا أنها واعدة أكثر:
الأول: الجمع بين الذكاء الاصطناعي وأسواق التنبؤ.
أنا لا أعتقد أن الذكاء الاصطناعي يمكنه أن يحل محل حكم الإنسان. والشيء المثير حقًا في أسواق التنبؤ هو التداول على الاحتمالات نفسها: إذا كان سعر حدث ما الحالي يعادل احتمال وقوع بنسبة 70%، فهذا لا يعني أنه سيقع فعلًا باحتمال 70%؛ بل يعني فقط أن السوق قام بتسعيره عند هذا المستوى، وهذا السعر قد يتضمن معلومات حقيقية، أو مشاعر، أو نقصًا في السيولة، أو مراكز كبيرة لدى اللاعبين الكبار، أو حتى تلاعبًا متعمدًا.
ما يجيده الذكاء الاصطناعي هو قراءة البيانات التاريخية، والبيانات الكلية، والأخبار، ووسائل التواصل الاجتماعي، والوثائق السياسية، وأسعار الأسواق ذات الصلة، والأحداث المشابهة السابقة في الوقت نفسه، ثم بناء نموذج احتمالي مستقل. مثلًا، إذا كان السوق يقدّر احتمال وقوع حدث ما بنسبة 70%، لكن الذكاء الاصطناعي يحسبه بناءً على المعلومات الحالية بنسبة 52% فقط، فإن الفجوة البالغة 18% قد تشكل بحد ذاتها فرصة تداول.
يمكن للذكاء الاصطناعي حتى أن يحدد لاحقًا ما إذا كانت سيولة هذا السوق كافية، وكم يمكن أن تدفع الأموال المنفردة السعر، وكم من الصفقات قد يأتي من تحريك اللاعبين الكبار، وما مدى المساحة المتاحة للتأثير المتعمد على السعر الحالي. وبهذا، لا يقدم الذكاء الاصطناعي مجرد نعم أو لا، بل يقدم حكمًا على جودة الاحتمال في السوق الحالي. وأعتقد أن هذا الاتجاه أكثر إثارة من مجرد بناء ما يسمى AI Oracle (أوراكل الذكاء الاصطناعي) وحده.
وخاصة في التنبؤات الكلية، قد يكون هذا النمط أكثر قيمة. وحتى بعض مسؤولي الاحتياطي الفيدرالي تحدثوا عن موضوعات مشابهة.
أسعار الفائدة، والتضخم، والتوظيف، والناتج المحلي الإجمالي، وتغيرات السياسات—كل هذه الأمور لديها أصلًا قدر كبير من البيانات التاريخية يمكن اختبارها رجعيًا. والأهم في الذكاء الاصطناعي هنا هو تصحيح الاحتمالات باستمرار. مثلًا، هل الأحداث التي يصنفها النموذج على أنها ذات احتمال 70% تحدث فعلًا بنحو 70% في النهاية.
إذا استطاع نموذج ذكاء اصطناعي أن يقدم على المدى الطويل احتمالات أدق من سوق التنبؤ نفسه، فحتى لو كانت الأفضلية بضع نقاط مئوية فقط، فإنها قد تتحول إلى قيمة كبيرة جدًا مع عدد كافٍ من الصفقات.
الثاني: الجمع بين الذكاء الاصطناعي والتداول الكمي.
أنا أيضًا أبحث في هذا الاتجاه منذ فترة، لكن بصراحة ما زلت أرى أن ترك الذكاء الاصطناعي يتداول بشكل مستقل بالكامل أمر لا يزال غير ناضج.
أكبر ميزة للذكاء الاصطناعي هي معالجة المعلومات. فمن الصعب على شخص واحد أن يقرأ في الوقت نفسه تقارير عشرات الشركات، ومئات الأخبار، وآلاف الحسابات على وسائل التواصل الاجتماعي، ثم يحلل معها البيانات الكلية، والخيارات، وتدفقات الأموال، والبيانات على السلسلة، والأسعار. أما الذكاء الاصطناعي فيستطيع ذلك. لذلك، أفضل الآن أن يساعدني الذكاء الاصطناعي في اكتشاف الشذوذ، وتصفية الفرص، وإجراء الاختبارات الرجعية للبيانات، والبحث عن الارتباطات، وبناء فرضيات التداول، ثم يقرر الإنسان في النهاية ما إذا كان سينفذ أم لا.
في الواقع، كثير من التغيرات الكبرى في الأسواق المالية تأتي من أشياء لم تظهر في البيانات التاريخية: تصعيد مفاجئ في الحرب، تغيير دولة لسياساتها بشكل مفاجئ، نشر رئيس رسالة فجأة، أو اتخاذ جهة تنظيمية قرارًا غير متوقع. كل هذا يصعب جدًا تدريبه من خلال بيانات السنوات العشر الماضية. لذلك، على الأقل في الوقت الحالي، أفضل أن أرى الذكاء الاصطناعي كمساعد قوي جدًا، لا كمدير استثماري ناضج.
الثالث: احتياجات التخزين التي يجلبها عصر الذكاء الاصطناعي.
كلما تطور الذكاء الاصطناعي، ستزداد بيانات التدريب، والمحتوى المُولَّد، وإصدارات النماذج، وسجلات الاستدلال، والبيانات التاريخية، ومقاطع الفيديو، والصور، والصوت، ولقطات النماذج، وما يحتاج فعليًا إلى قراءة عالية السرعة منها ليس إلا جزءًا صغيرًا. أما الكثير من البيانات التاريخية فقد لا يُستدعى لسنوات، ومع ذلك لا يمكن حذفه مباشرة. هذا النوع من البيانات يحتاج في الواقع إلى تخزين بارد رخيص، مستقر، وموثوق.
لذلك، أعتقد دائمًا أن شبكات التخزين اللامركزي مثل FIL قد لا تكون بلا فرصة، وليس فقط من ناحية السعر. فالشركات تهتم أيضًا بما إذا كانت البيانات يمكن استرجاعها بثبات، وكيف تكون السرعة، وهل توجد مرونة زائدة كافية، وهل يمكن التحقق من سلامة البيانات، وكيف تُعالج الخصوصية، وما إذا كانت تكلفة النقل مرتفعة أم لا.
إذا كان بإمكان التخزين اللامركزي في المستقبل أن يصبح أرخص فعلًا من التخزين البارد في السحابة التقليدية، مع توفير القابلية للتحقق والمرونة الزائدة أيضًا، فأعتقد أن عصر الذكاء الاصطناعي قد يعيد في الواقع إحياء طلب حقيقي كبير على هذا المسار.
في الجوهر، بالنسبة لي، أهم سؤال في الذكاء الاصطناعي + الكريبتو لا يتجاوز سؤالًا واحدًا: ما المشكلة التي يحلها الكريبتو ولا يستطيع الذكاء الاصطناعي حلها بمفرده؟ إذا لم نستطع الإجابة عن هذا السؤال، فلا أرى أن القصة، مهما كانت عظيمة، تحمل أهمية كبيرة.