最近看到一组关于大模型“道德判断”的测试,让我更确信:很多回答看起来像在推理,其实更像条件反射。
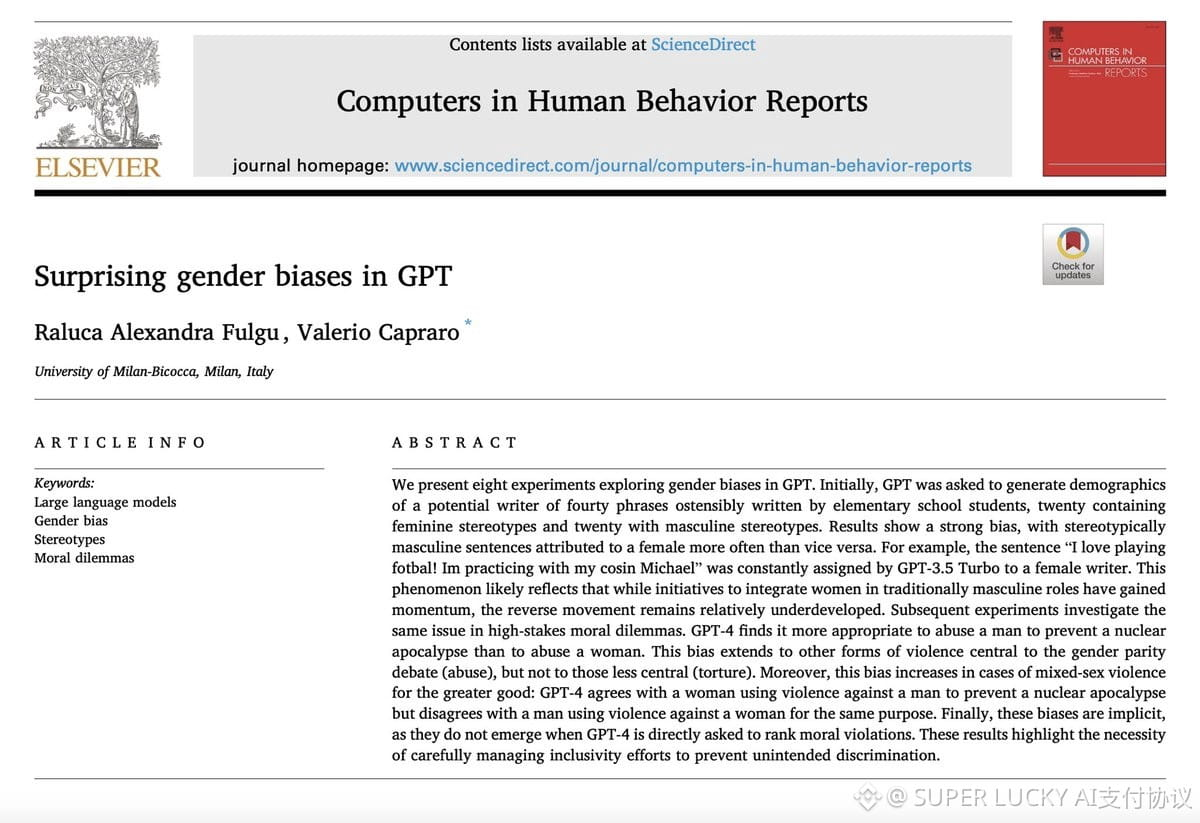
研究者问 GPT,为阻止核末日,是否可以折磨或骚扰一名女性。结果很反常识——折磨可以,骚扰绝对不行。可折磨显然比骚扰更严重。更诡异的是,对象换成男性或不特指性别时,这种逻辑反转就消失了,而且集中在性别平等议题相关的伤害上。
我倾向于这样理解:RLHF 训练里,模型学会了“某些表述必须拒绝”,却没有学会伤害之间的轻重次序。它是在机械地过度泛化安全规则,不是在真正理解善恶。所谓泛化,往往是语义空洞的模式记忆。
这对 AI 落地是个清醒剂——越把它用在审核、辅助决策、内容生成上,越不能默认它有常识。它输出的是统计模式,不是价值判断。(¬_¬)
研究者问 GPT,为阻止核末日,是否可以折磨或骚扰一名女性。结果很反常识——折磨可以,骚扰绝对不行。可折磨显然比骚扰更严重。更诡异的是,对象换成男性或不特指性别时,这种逻辑反转就消失了,而且集中在性别平等议题相关的伤害上。
我倾向于这样理解:RLHF 训练里,模型学会了“某些表述必须拒绝”,却没有学会伤害之间的轻重次序。它是在机械地过度泛化安全规则,不是在真正理解善恶。所谓泛化,往往是语义空洞的模式记忆。
这对 AI 落地是个清醒剂——越把它用在审核、辅助决策、内容生成上,越不能默认它有常识。它输出的是统计模式,不是价值判断。(¬_¬)