
بقلم | دينغ جياو ون ون وانغ لولو
التحرير | وي جيا
في الوقت الذي تستمر فيه شريحة الذكاء المُجسَّد في جذب أنظار رأس المال، يزداد عدد القوائم المرتبطة بها أيضًا. عندما تصبح عبارة «الأول» شبه أمرٍ قياسي لدى كل جهة، فهل ما تزال القوائم موثوقة؟
قبل أكثر من شهر بقليل، مرّت شركة Qianshan Intelligent بموقفٍ محرج. في بداية يونيو، حقق نموذجها الأساسي للذكاء المُجسَّد Spirit v1.6 على قائمة RoboArena 1918 نقطة، متجاوزًا 1880 نقطة التي حققها نموذج Nvidia Cosmos3، ما وضعه لفترة في الصدارة باعتباره «الأول عالميًا». وبعد ذلك مباشرة، أعلنت Qianshan عن إتمام جولة تمويل A+ بقيمة 1.5 مليار يوان. وخلال ثلاثة أشهر، أكملت أربع جولات تمويل متقاربة على نحو مكثف، لتصل القيمة الإجمالية إلى قرابة 5 مليارات يوان، مُسجلةً رقمًا قياسيًا جديدًا في وتيرة التمويل ضمن مجال الذكاء المُجسَّد.
لكن في القطاع، بدأت الشكوك حول جودة بيانات التقييم تقريبًا من اليوم التالي للارتفاع. فقد أشار مراقبون إلى أنه من بين 310 سجلات تقييم، جاءت 72% من الدرجات من حسابين اثنين. والأكثر لفتًا للانتباه هو أن إدارة RoboArena أصدرت لاحقًا بيانًا، وبعد تحقيق رجعي أزالت جزءًا من بيانات التقييم محل الشك، وجرى تحديث ترتيب القائمة. كما تم حذف Spirit v1.6 من القائمة تباعًا.
لكن هذه الواقعة لم تُطفئ حماس اللاعبين. عند تصفح أخبار الصناعة لنحو نصف سنة، ستجد أن شركة Starryturn Yuan (星动纪元) وForce Lingji (原力灵机) وJijia Shijie (极佳视界) وZhiyuan (智元) وKuawé'i (跨维) وLuming (鹿明)... تكاد كل شركة رائدة تمسك بواحدة “الأولى”، ولا تختلف أبعاد “الأولى” هذه من شركة لأخرى.
ربما لا يصعب فهم هذا المشهد: فحتى الآن لم تتوحد مسارات التكنولوجيا في مجال الذكاء الجسدي، وغالبًا ما تكون معدلات نجاح الاختبارات على الروبوت الحقيقي محصورة بين خمسين إلى ستين بالمئة تقريبًا. ولذلك، عندما يريد الخارج أن يعرف ما إذا كانت شركة ما “فعلاً ناجحة”، فغالبًا ما يعتمدون إلى حد كبير على القوائم. لكن عندما تكون الجهة التي تعلن النتائج جامعات أو مؤسسات أو وسائل إعلام أيضًا، والمعايير تختلف من جهة لأخرى، وبعضها يتورط في صفقات تجارية وعلاقات مصالح، فهل يمكن لما تصفه القائمة أن يظل “مسطرة”؟ هنا تصبح المشكلة.
قال مستثمر يركز على مسار الذكاء الجسدي إن القوائم تميل أكثر إلى سلوك السوق، ولا تعدو أن تكون مرجعًا لاتخاذ قرار استثماري. ولم يكن الأمر مفاجئًا بالنسبة له في قضية QianXun. من وجهة نظره، الجهات التي تهتم فعلاً بالمراكز ليست بالضرورة التي تنطلق من دوافع مالية أو تقنية، بل غالبًا جهات مثل صناديق توجيه محلية أو أموال ذات طابع حكومي. قد يكون “الأول” بالنسبة لهم مجرد مدخل جيد يُكتب في التقارير. لكن يوجد مستثمرون آخرون يرون الأمر بشكل مختلف: ففي المراحل المبكرة التي ترتفع فيها عتبة التكنولوجيا وتوجد فيها فجوة معلومات وعدم تماثل، توفر القوائم على الأقل نقطة بداية للمقارنة الأفقية.
عندما يتجاوز عدد “الأولى” عدد الشركات التي تعمل بجد لصناعة الروبوتات، فماذا تختبر هذه القوائم فعلاً: التقنية أم قدرة رواية القصص؟ وما القوائم التي تستحق المشاهدة؟
01 مسار التكنولوجيا غير موحّد بعد، لكل شخص “أول” خاص به
لنبدأ أولاً بمناقشة القوائم المتاحة في السوق حاليًا، وبناء انطباع مبدئي. ووفقًا لإحصاءات غير كاملة، توجد حاليًا أكثر من 20 قائمة نشطة في مجال الذكاء الجسدي. وبحسب محتوى التقييم، يمكن تقسيم هذه القوائم تقريبًا إلى ثلاث فئات.
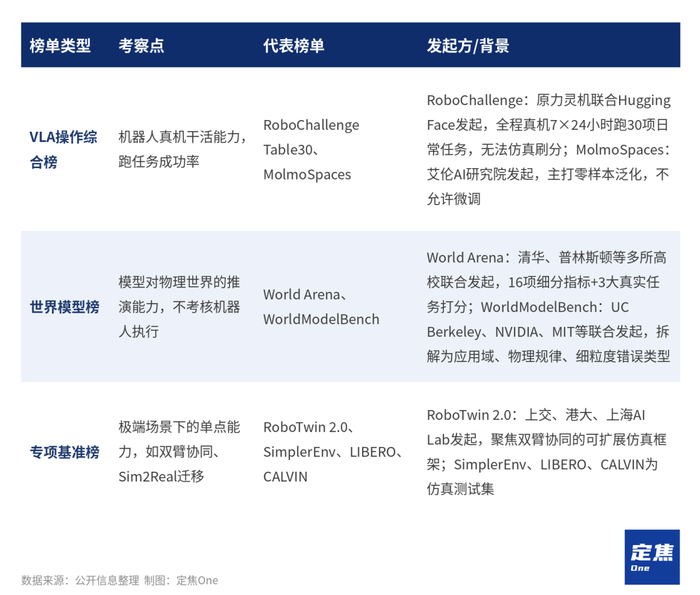
قائمة التوليف الشامل لأعمال VLA (التشغيل بالمستوى التكاملي) تختبر هل يستطيع الروبوت أن يقوم فعلًا بالعمل؛ فهي تقيس معدل نجاح المهام، ومن الأمثلة RoboChallenge Table30 وMolmoSpaces؛
منافسة النماذج العالمية (World Model) تختبر ما إذا كان الاستدلال داخل الرأس صحيحًا؛ فهي تقيّم قدرة النموذج على استنتاج العالم الفيزيائي، ولا تقيم مدى رشاقة الأذرع والأرجل للروبوت. ومن أبرز الأمثلة World Arena وWorldModelBench؛
قائمة المعايير المتخصصة تختبر: “هل سيظهر العجز في الحالات القصوى؟” وهي موجهة لقدرات متطرفة في نقاط محددة، مثل تنسيق الذراعين معًا، أو الانتقال من المحاكاة إلى الروبوت الحقيقي. ومن الأمثلة RoboTwin 2.0 وSimplerEnv وLIBERO وCALVIN. قيمتها تكمن في أنه في السيناريوهات القصوى التي لا تُغطى ضمن القوائم الشاملة، تُجبر حدود النموذج على الظهور.
تجدر الإشارة إلى أن هذه الفئات الثلاث تركّز كل منها على جانب مختلف ولا يمكن استبدالها. فـ“قائمة الروبوت الحقيقي” تقيس التنفيذ، و“قائمة نماذج العالم” تقيس الاستدلال، و“القائمة المتخصصة” تقيس حدود السيناريو. ولا توجد أي قائمة تغطي كامل قدرات الذكاء الجسدي.
وبوجود هذا الإحداثي، يمكن ترتيب تقارير المعارك الخاصة بنماذج “القاعدة” للذكاء الجسدي خلال نصف سنة وفق الشواهد. وإذا جمعنا تقارير المعارك الخاصة بنماذج “القاعدة” خلال الشهرين الأخيرين، يمكن الحصول على قائمة مبهرة.
في شهر مايو من هذا العام، أعلنت Starryturn Era0 أنها استحوذت على المركز الأول في RoboChallenge Table30؛ وكانت Zhiyuan GE-Sim 2.0 هي الأولى في World Arena Track1؛ أما Kuawé'i DSCFuncWorld فهي الأولى في World Arena Track2. وفي يونيو، استحوذت QianXun Spirit v1.6 على المركز الأول في RoboArena (ثم تم حذفها)، وتصدرت Luming Prime R0 قائمة MolmoSpaces. تكاد تكون كل شركة هي “الأولى”، ولديها ترتيب قائمة محدد كدليل مؤيد.
والفوضى أيضًا بدأت من أنواع مختلفة من القوائم.
الأوضح هو أن صاحب المركز الأول مثل “وجبة تتغير على المائدة باستمرار”، إذ يتكرر تبديل “الرقم 1” بشكل كبير.
قمة RoboChallenge Table30. خلال النصف سنة الماضية تبدلت على الأقل أربع مرات: أولًا، قامت QianXun Spirit v1.5 بتحطيم الرقم القياسي بنسبة نجاح 50.33%، ثم سرعان ما تجاوزتها 极佳视界 GigaBrain-0.1، وAtlas من Boston Dynamics في الولايات المتحدة، وEra0 من Starryturn (星动纪元) تباعًا.
هذا السرعة أعلى بكثير من القوائم الرئيسية في نماذج اللغة الكبيرة. من 2023 إلى 2025، غالبًا ما استطاع GPT-4 وClaude 3 وGemini 1.5 الحفاظ على الصدارة في قوائم مثل MMLU وGSM8K لأشهر تصل أحيانًا إلى سنة؛ حتى في فترة التطور السريع بين 2020 و2022، كان GPT-3 وPaLM أيضًا بتبديل على أساس شهري. “في الوقت الحالي، في الذكاء الجسدي، ليس بالأمر السهل أن يظل نموذج واحد على القمة أسبوعًا.” قال Mi Fan، أحد العاملين في شركة رائدة في الذكاء الجسدي.
وتعود الأسباب الرئيسية إلى نقطتين. الأولى هي عشوائية العالم الفيزيائي: عندما يشغّل نموذج واحد على الروبوت الحقيقي مرتين، من الطبيعي أن تختلف نسبة النجاح بين 3 و5 نقاط مئوية، إذ تؤثر الإضاءة ومواقع الأجسام وتفاوتات الذراع الميكانيكية على النتيجة. أما قوائم نماذج اللغة الكبيرة مثل MMLU فهي أسئلة ثابتة وتحكيم حتمي، لذلك لا تتغير درجات نفس النموذج تقريبًا حتى بعد 100 تشغيل. السبب الثاني هو مدى انفتاح مهام الاختبار: مثل RoboChallenge Table30، توزيع المهام الـ30 منشور. يمكن لكل جهة جمع البيانات خصيصًا لهذه المهام، ثم ضبط/تحسين النموذج وإرساله، فتُضغط “مدة صلاحية” الحفاظ على الصدارة إلى حد يحسب بالأسبوع.
والأكثر إرباكًا هو أن القائمة نفسها قد يتسلل فيها عدة “أولى” في الوقت نفسه.
World Arena مثال نموذجي: تُعلن Zhiyuan GE-Sim 2.0 وKuawé'i DSCFuncWorld خارجيًا أنهما “تصدرتا World Arena”. لكن الحقيقة أن هذه القائمة تحتوي على مسارات متعددة. فالـ Track1 (الاستشعار والاستجابة الحركية) لـ Zhiyuan GE-Sim 2.0 جاء أولًا بـ 68.26 نقطة، بينما Track2 (محرك البيانات) لـ Kuawé'i DSCFuncWorld جاء أولًا. تنتمي “الأولى” إلى قوائم فرعية مختلفة، لكن خارجيًا تُكتب كجملة واحدة موحدة.
بالنسبة للقراء غير المعتادين على تقسيم المسارات، فإن قول “العالمية الأولى في World Arena” بالتساوي بين جهتين غالبًا لا يمكن تمييزه إطلاقًا؛ وقد يشكون إن كان هناك من يكذب. لكن الحقيقة أن أحدًا لم يخطئ، فقط لم يكن الكلام دقيقًا بما يكفي.
وهناك منطقة أغمق تتمثل في أن طبيعة القائمة تختلط؛ فالقيمة الفعلية لكلمة “الأولى” تُفترض تلقائيًا أنها في نفس الفئة، ما يسهل حدوث تضليل.
في خطاب كثير من الشركات الموجّه للخارج، غالبًا ما يذكرون في نفس الوقت: “هذا النموذج تصدر RoboChallenge”، و“في اختبار/تقييم على وسيلة إعلامية للذكاء الجسدي أيضًا حصل على المركز الأول”. الأول هو نسبة نجاح من تشغيل روبوت حقيقي 7×24 ساعة، أما الثاني فقد يكون مجرد قائمة تُحدد داخل غرفة الأخبار بعد مناقشات مغلقة، وحتى عبر اتفاقات تجارية. عند وضعهما جنبًا إلى جنب داخل جملة واحدة، يتم افتراض أن قيمة الاثنين في نفس الرتبة.
ومن أكثر ما هو غامض: “قائمة الصناعة”. بعض القوائم تضع كلمة “الصناعة” في العنوان، لكنها لا تُعد لوحة صلبة قُفلَت فيها الروبوتات الحقيقية، ولا هي benchmark مؤيد من مؤسسة أكاديمية. بل إنها قائمة تقييم من شركة استشارات أو وسيلة إعلامية. ظهرت حالات مشابهة أيضًا في دوائر نماذج اللغة الكبيرة، لكن مع تدريج فصل القوائم الأكاديمية والاختبارات التجارية والقوائم الإعلامية إلى طبقات، جرى تفكيك “الأول المزدوج” تدريجيًا. أما في الذكاء الجسدي، فهي ما تزال في تلك المرحلة التي لم تُفصل فيها الطبقات بعد.
عندما تتراكب هذه الظواهر الثلاث، تكون النتيجة تضخمًا شديدًا في “الأولى” داخل القوائم. ولا يقتصر هذا التضخم على مستوى التسويق فقط؛ فعنوان “الأولى” غالبًا ما يجلب الاهتمام والموارد، وأيضًا علاوة في التقييم المالي حقيقية على أرض الواقع.
02 كيف يتم صنع “الأول”؟
بما أن القوائم تستطيع تحريك أموال حقيقية، فكيف يتم صنع “الأول” أيضًا تشكلت حوله “قواعد غير مكتوبة” في الصناعة. يقول خبراء من الداخل إنه رغم أن QianXun Spirit v1.6 حالة متطرفة، فإن ظاهرة “صناعة الأول” ليست نادرة، وتتم عادة عبر ثلاث طرق تقريبًا.
الأقل تكلفة والأكثر شيوعًا هو أسلوب التغليف بالعبارات: يتحول “الأولى في كل مادة” إلى “الأولى في المجموع”. الفكرة تكمن في حذف الكلمات المحدِّدة الأساسية.
مثلًا: ما الذي يتم الحصول عليه فعليًا هو “الأولى من فئة VLA منسقة لتنسيق الذراعين في RoboTwin 2.0”، لكن من الخارج تصبح “تصدر RoboTwin 2.0”. فعليًا كذلك “الأولى في تعميم مخصص لسيناريو LIBERO-Plus”، لكن خارجيًا تصبح “قمة لوحة LIBERO-Plus”. لم يتم تزوير البيانات، والنتيجة حقيقية أيضًا، لكن نطاق “الأولى” تمت توسيعه بشكل متعمد.
الطريقة الثانية هي التدخل مباشرة في النتيجة عبر أساليب مثل “الحشو بالأسئلة”.
الأولى هي “التدرب على نماذج أسئلة الامتحان”. يمكن استخدام توزيع المهام والمعايير ونُظم البيئة التي تُنشر للعموم لتدريب موجّه بعدة طرق، ويبدو ذلك خصوصًا في القوائم التي تكون مهامها ثابتة نسبيًا. تستطيع كل جهة عبر تكرار “الحشو بالأسئلة” ورفع درجة التكيّف الزائد مع سيناريوهات محددة أن تحصل على درجات عالية.
يقول Mi Fan إن بعض القوائم في مجال الذكاء الجسدي مهام اختبارها منشورة، ويمكن لكل جهة جمع بيانات خصيصًا لهذه المهام، ثم ضبط النموذج وإرساله. ويُنظر إلى ذلك في دائرة الذكاء الجسدي كعملية تكرارية طبيعية، وليست غشًا. وهذا يختلف جوهريًا عن “تسريب البيانات وتلوث البيانات” في مجال LLM.
الطريق الأخرى هي استغلال ثغرات آلية التقييم. فبعض القوائم تتمتع بسلطة عالية، لكن يوجد لها ثغرات يمكن استغلالها. مثلًا RoboArena تستخدم تسجيلًا مفتوحًا وتقييمًا موزعًا. الهدف هو إشراك المزيد من المشاركين، لكنها تركت ثلاثة ثغرات.
أولًا: هوية المُقيِّم ليست لها عوائق. أي شخص يستطيع التسجيل ليكون قاضيًا؛ خلال فترة قصيرة، يؤدي تركّز أعداد كبيرة من الحسابات الجديدة على تقييم النموذج نفسه إلى رفع درجة Elo بسرعة؛
ثانيًا: ليست المطابقة مُلزمة بتغطية شاملة. فالتوزيع العشوائي للخصوم لا يعني ضرورة أن تلعب مرة واحدة ضد جميع من هم في القائمة في نفس الفترة. عندما يستلم المُقيِّم المهام، يكون A ثابتًا، وB يتم اختياره عشوائيًا من نماذج ذات درجات متقاربة. ومع عدم كفاية حجم العينة، يمكن أن لا يلتقي نموذجين أبدًا. على سبيل المثال، في الفترة المبكرة من Spirit v1.6 حين لعب ضد DreamZero، توقف بعد 23 مباراة. أما إنجما قبل 30 مايو وظهور Cosmos3-Nano-Policy من NVIDIA في القائمة، فقد لم يكن هناك أي مواجهة بينه وبين Spirit v1.6؛
ثالثًا: الحشد المركز في التقييم؛ باستخدام عدة حسابات لتقييم نموذج الشركة بكثافة، بهدف تقليل السجلات السلبية. على سبيل المثال، في 310 سجل تقييم لنسخة Spirit v1.6، جاءت 72% من الدرجات من حسابين هما ECUST وRobotics Lab. وقد استخدمتا 224 جلسة تقييم للحصول على 97% من نسبة الفوز، ودفع ذلك Spirit v1.6 إلى المركز الأول. بينما قامت شركة NVIDIA، تحت نفس الظروف، بتجربة ذاتية 21 مرة فقط، وكانت نسبة الفوز 0%. عند وضع مجموعتي البيانات معًا، ينتج عن ذلك شكوك لدى العاملين في المجال.
بعد ذلك، أضافت RoboArena قواعد: أن يكون المُقيِّمون طرفًا ثالثًا بلا أي علاقة مصلحية، لسد باب الحسابات التي تحشو نفسها. ويُوسم أي حساب نسبة إكماله للتقييم أقل من 20% بأنه مشبوه، وتُسد باب “المطابقة الانتقائية”. وبعد المعالجة، سقطت QianXun من القائمة.
وهناك طريقة أخرى هي الأكثر خفاءً والأكثر انتشارًا: تبادل الموارد، حيث يتم تحويل القوائم مباشرة إلى عمل تجاري.
معايير اختيار بعض “القوائم الإعلامية” ليست واضحة. بل أحيانًا تكون هناك شراكات تجارية مع موضوعات التقييم، فتقوم الطرفان بإصدار “تقرير رسمي” معًا، وتُعبّئان القائمة الإعلامية والـ benchmark الأكاديمي جنبًا إلى جنب. هذا لا يتضمن أي تقنيات ولا يتعلق بالبيانات؛ كل ما يتعلق بالميزانية والعلاقات. ويقول أكثر من شخص يعمل في المجال إن ظواهر الحشو في القوائم وشراء القوائم ليست نادرة.
غالبًا تتداخل هذه الطرق الثلاث: أولًا، رفع الدرجات عبر تدريب موجّه أو استغلال ثغرات؛ ثم استخدام تبديل “ما ينتمي إليه المسار” لإخفاء المصدر؛ وأخيرًا نشر ذلك خارجيًا عبر العبارات التسويقية، وعند الحاجة شراء اعتماد من وسيلة إعلامية. ومع التغليف طبقة بعد طبقة، يصبح “الأول” هو كل شيء.
هذه الأساليب ليست سرًا داخل الصناعة. المشكلة الحقيقية هي أن كشفها يحتاج أساسًا تقنيًا؛ فكلما كانت التقنية أكثر تعقيدًا، كان من الصعب على غير المتخصصين التمييز. وتصبح القصة حينها أسهل في السرد.
03 بعد إزالة الماء، ماذا يجب أن نصدّق؟
واعترف أكثر من عامل في مجال الذكاء الجسدي بأنهم حاليًا لا يهتمون كثيرًا بترتيب القوائم، لأن القوائم يمكن حشوها وشراؤها؛ حتى لو كانت الأمور “ملتزمة”، فإن تعقيد البيئة الفيزيائية يجعل من الصعب تحقيق دقة 100% في البيانات.
والمشكل الأعمق هو أن هذا القطاع حتى الآن لا يملك “مسطرة عامة” واحدة.
استخدم أحد العاملين في مجال الذكاء الجسدي gashero تشبيهًا بـ “قلي البيض” و“تتبيل السلطة الباردة”. الروبوت A يتقن قلي البيض، بنسبة نجاح 90%، والروبوت B يتقن خلط السلطة الباردة، بنسبة نجاح 85%، لكن لا يمكن القول من ذلك أن A أقوى من B. فمهارة قلي البيض تختبر الالتقاط وقلب المقلاة، بينما مهارة السلطة الباردة تختبر صب التتبيلة بدقة والخلط؛ المهارتان مختلفتان، مستوى الصعوبة مختلف، ومعايير التقييم مختلفة أيضًا. وفي الوقت الحالي، لا يوجد معيار موحد في مسار الذكاء الجسدي يمكنه تحويل “قدرة قلي البيض” و“قدرة خلط السلطة الباردة” إلى نظام تقييم واحد.
ومع ذلك، هذا لا يعني أن القوائم بلا قيمة. يرى العاملون في المجال عمومًا أن للقوائم ما تزال قيمة مرجعية، بشرط معرفة ما الذي يستحق المشاهدة، وماذا يجب أن تنظر إليه بعد الاطلاع.
وبحسب إجماع الصناعة، تمتلك القوائم الموثوقة فعليًا، بشكل عام، ثلاثة خصائص في الوقت نفسه.
أولًا: شفافية في الأقسام، وليس مجرد عرض “الأولى” واحدة.
سواء كانت القوائم الشاملة أو المتخصصة، فالطريقة الموثوقة هي تفكيك التفاصيل واحدةً واحدة. مثلًا RoboChallenge Table30: فهو يقيس معدل النجاح الشامل في 30 مهمة يومية. وتكمن الموثوقية في أنه لا يخبر القارئ فقط أن الرقم الإجمالي 64.33%، بل يُظهر أيضًا أي مهام من الـ30 كانت جيدة وأيها فشلت. فالقوائم التي تذكر المجموع فقط دون تفاصيل تُقلل قيمتها بشكل كبير.
ثانيًا: التقييم يُدار من طرف طرف ثالث، كما تتضمن آليات “منع الحشو بالأسئلة”.
لا تسمح MolmoSpaces بالتفصيل (fine-tuning)، فالنموذج يجتاز الاختبار مباشرة “بدون تدريب مسبق”؛ أما LIBERO-Plus فتضيف اضطرابات متطرفة مثل تغيرات مفاجئة في الإضاءة، وتشوش الخلفية، وتبدل زاوية الكاميرا، بهدف منع الحصول على الدرجات بالاعتماد على الحفظ الأعمى. السمة المشتركة هي جعل الحشو بالأسئلة أصعب، وجعل التعميم عتبة حقيقية.
ثالثًا: انظر لآلية التقييم، لا لمعدل التحديث.
القوائم التي تتأخر في التحديث ليست بالضرورة موثوقة، والقوائم التي تتحدث بسرعة ليست بالضرورة غير قابلة للحشو. فبعض القوائم يكون تحديثها بطيئًا لأن تكلفة اختبار الروبوت الحقيقي مرتفعة جدًا؛ مثلًا، في RoboChallenge قد يحتاج دورة تقييم كاملة إلى أسابيع. 30 مهمة، كل مهمة تُشغَّل 10 مرات، أي 300 محاولة حقيقية للروبوت، مع تشغيل متواصل 7×24 ساعة. وهذه قيود تكلفة العالم الفيزيائي. أما القوائم التي تُحدَّث بسرعة، فغالبًا يعود ذلك إلى تصميم الآلية. فمثلًا، تستخدم RoboArena نظام تقييم Elo لترتيب ديناميكي، وتدخل بيانات مباريات جديدة يوميًا، فينعكس التحديث يوميًا. السرعة نفسها ليست مشكلة؛ موثوقيتها تعتمد على مدى إحكام الآلية وما إذا كانت الثغرات قد سُدّت.
ولكن بما أن الجميع في الدائرة يعرفون أن للقوائم ماءً، لماذا لا يزال الجميع يتنافس على الحشو بكل قوة؟
الإجابة تكمن في مرحلة تطور الصناعة الحالية.
في هذه المعركة على “الأولى” حاليًا، يكمن جوهرها في نتاج قلق رأس المال. هذا العام هو سنة كثرة تحديث “قاعدة” نماذج الذكاء الجسدي. ففي المراحل المبكرة كانت أحجام شحن القنوات والإيرادات وكمية الطلبات غير مستقرة، لذلك لا مفر من استخدام القوائم للتغطية. طالما بقي التوجه نحو التمويل، فلن تتوقف مسألة حشو القوائم.
عندما يدخل القطاع المرحلة التالية، سيتحول معيار التقييم تلقائيًا؛ مثلًا: عدد الوحدات التي يتم تسليمها سنويًا، وما إذا كانت هناك عملاء ثابتون، وما إذا كانت الشركة قادرة على تحقيق الأرباح. عندها سيزول تضخم “الأول” تلقائيًا، وستعود القوائم إلى مكانها الطبيعي.
ربما، الجهة التي لا تنشغل بالتصدر في القوائم، بل تركز على إدخال الروبوت إلى خط الإنتاج، هي الإجابة الحقيقية في هذا القطاع.
(وفقًا لطلب من الشخص المُقابَل، فإن “Mi Fan” اسم مستعار)