لقد كنت أفكر في مدى سهولة الخلط بين النشاط المرئي وبين الفهم المرئي.
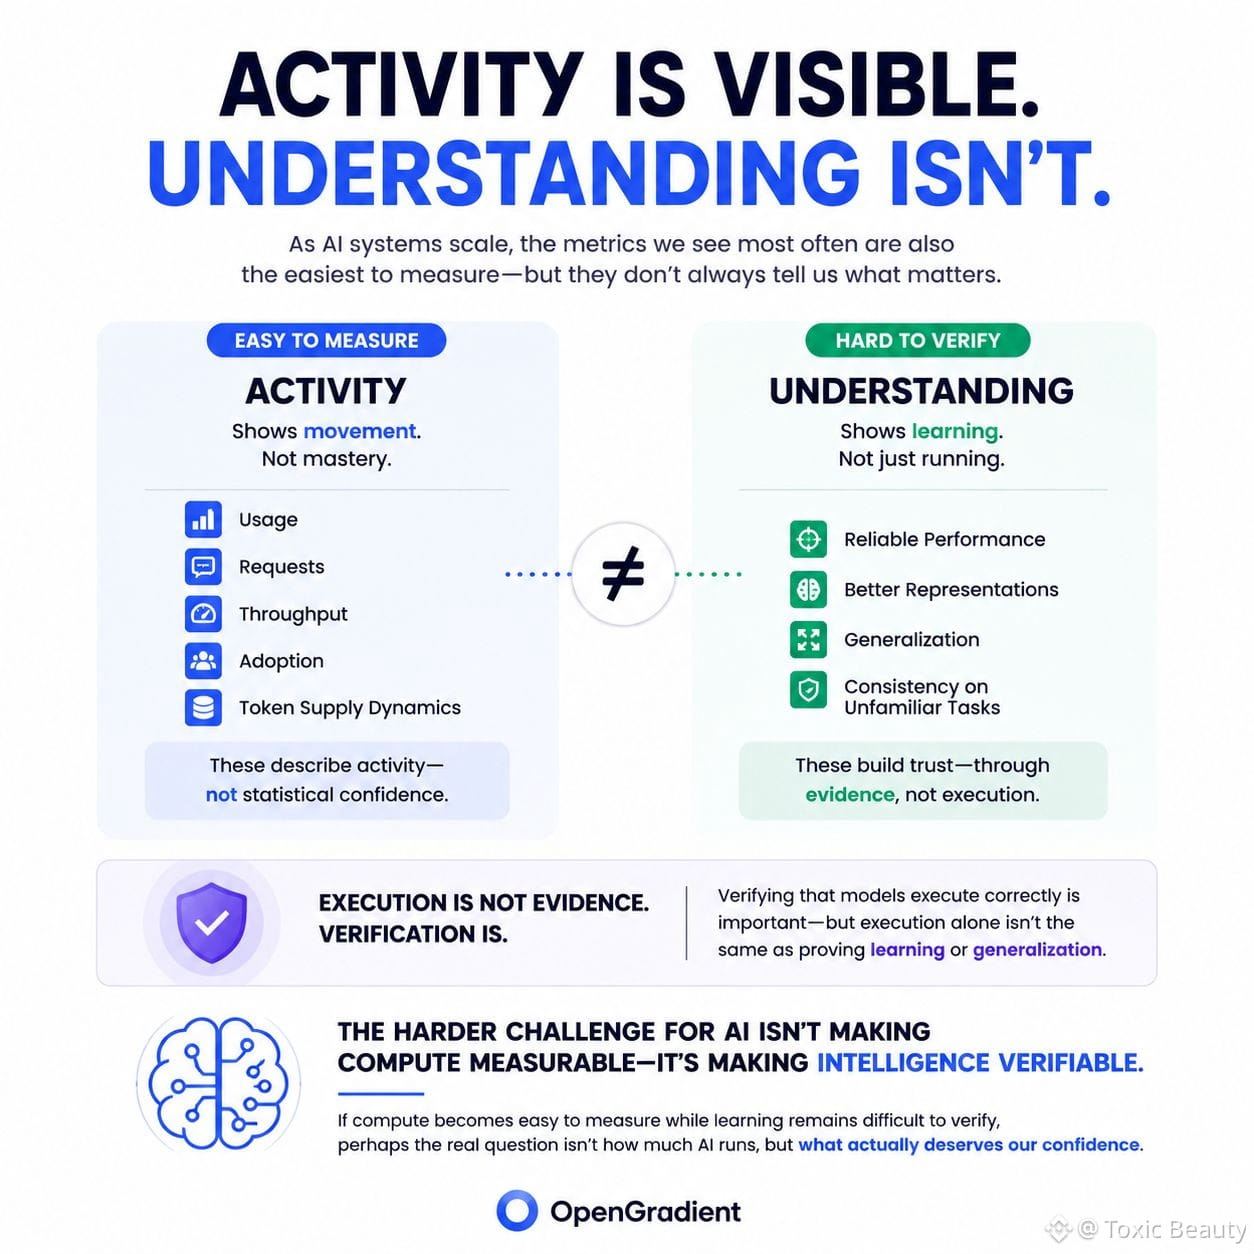
ومع ازدياد قدرة أنظمة الذكاء الاصطناعي، فإن المقاييس التي نراها غالبًا—الاستخدام، والطلبات، والإنتاجية، أو التبنّي—هي أيضًا الأسهل في القياس. إنها مفيدة، لكنها لا تخبرنا بالضرورة ما إذا كان النظام أصبح أكثر موثوقية، أو تعلّم تمثيلات أفضل، أو يمكنه التعميم خارج نطاق المهام المألوفة.
النشاط والفهم ليسا دائمًا الشيء نفسه.
الثقة لا تأتي من مقدار ما يشغّله نموذج. بل تأتي من جودة الأدلة على ما تعلمه فعليًا، ومن مدى اتساق أدائه عندما يواجه شيئًا جديدًا. هذه هي الفروقات بين قياس التنفيذ والتحقق من القدرة.
لهذا السبب تحديدًا لفتتني OpenGradient. التحقق من أن النماذج تنفّذ بشكل صحيح خطوة مهمة، لكن التنفيذ وحده ليس هو نفسه إثبات التعلّم أو القدرة على التعميم. حتى مقاييس مثل 2,000+ نماذج مستضافة أو 2M+ من الاستدلالات تصف النشاط أكثر من كونها تعطي ثقةً إحصائية، ويمكن أن تزيد ديناميكيات إمداد الرموز من تعقيد الطريقة التي يفسّر بها الناس النمو.
ربما تكون التحدية الأصعب أمام الذكاء الاصطناعي ليست جعل الحوسبة قابلة للقياس—بل جعل الذكاء قابلاً للتحقق.
إذا أصبحت الحوسبة سهلة القياس بينما يظل التعلّم صعب التحقق، فربما لا يكون السؤال الحقيقي هو مقدار ما يعمل عليه الذكاء الاصطناعي، بل ما الذي يستحق حقًا ثقتنا.
#opg
#OPG
@OpenGradient
$OPG
$S
$AGLD
#OilFuturesFallAbout4
#PredictionMarketVolumeHitsRecordHigh