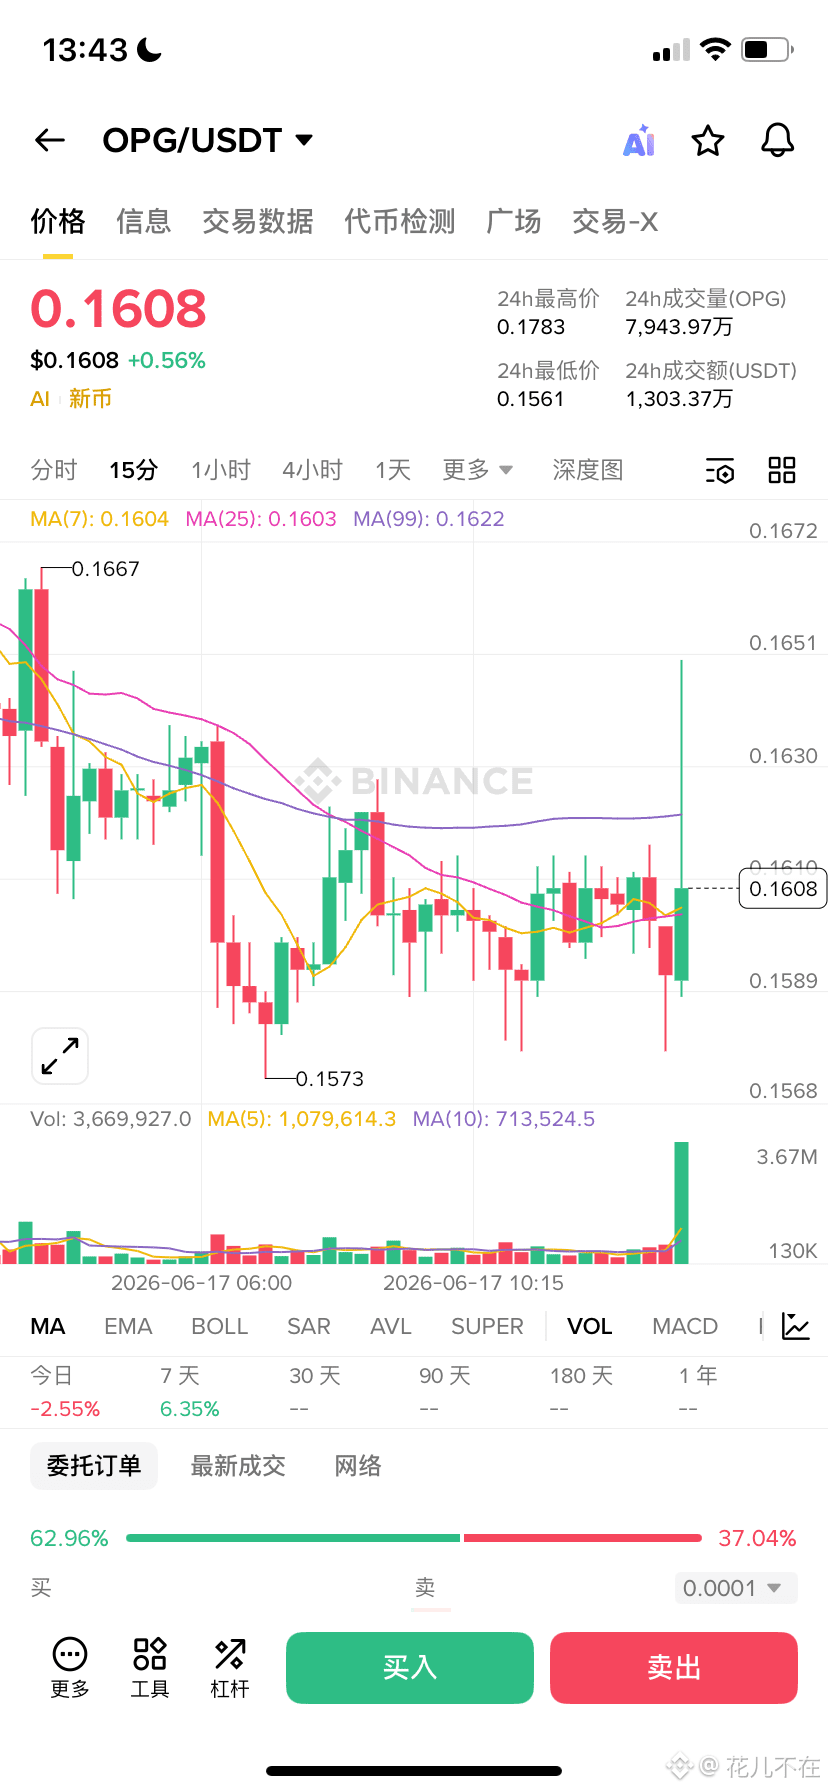
#opg $OPG في عطلة نهاية الأسبوع، أوصى موظف في مقهى بوجود «قائمة مخفية». كنت متحمسًا وطلبت مشروبًا—لكن ما حصلت عليه كان ببساطة لاتيه عادي أضيفت إليه شراب كراميل. هذا ذكرني بمشاريع العملات المشفرة التي تدّعي «ثورة بالذكاء الاصطناعي»؛ فغالبًا ما تلتف حول نموذج كبير وتضع عليه غلاف إصدار توكن فقط. لكن بعد تجربة عميقة لـ@OpenGradient، تغيّر انطباعي حقًا.
إن معمارية HACA للهندسة الهجينة للحوسبة بالذكاء الاصطناعي لديها تكسر الصور النمطية لديّ عن أن «بلوك تشين + ذكاء اصطناعي = بطيء». تعتمد سلاسل البلوك تشين التقليدية على تكرار تنفيذ كل معاملة من كل عقدة تحقق للوصول إلى إجماع، وهو أمر غير قابل للتطبيق حسابيًا لتشغيل نماذج كبيرة. تقوم HACA بتقسيم الشبكة إلى ثلاثة أدوار متخصصة: عقد الاستدلال تشغّل النموذج وتولّد إثباتات يمكن التحقق منها، والعُقد الكاملة تتحقق فقط من الصلاحية التشفيرية للإثباتات، وعُقد البيانات تحصل على مدخلات موثوقة من مصادر خارجية. يحصل المستخدم أولًا على النتيجة، بينما يتم إتمام التحقق والتسوية بشكل غير متزامن—وبذلك تُحافظ على سرعة مستوى Web2 وتُقفل ثقة السلسلة على مستوى محكم.
وما يجعلني أشعر بأنها «مختلفة فعلًا» هو تصميمها للخصوصية. عند معالجة معلومات حساسة في OpenGradient Chat، يتم تنفيذ التشفير مباشرة على جانب المتصفح، ولا تكون المفاتيح موجودة إلا على جهازك؛ وبعد تمرير مجهول عبر ترحيل مُخبري (Oblivious HTTP)، يتم فك التشفير والمعالجة داخل بيئة TEE موثوقة—وبذلك لا يمكن للجهة المشغّلة رؤية من أنت، ولا فهم المحتوى الذي ترسله. بالمقارنة مع أساليب ChatGPT التي تغذي النموذج بالمحادثات، هذه هي خصوصية «على مستوى المعمارية» فعلًا.
النتائج تؤكد سرعة التطبيق على أرض الواقع: منذ إطلاق Base في أبريل، تم استضافة أكثر من 2000 نموذج، والتحقق من أكثر من 500 ألف إثبات، ومعالجة أكثر من 2 مليون عملية استدلال. لكن لديّ دائمًا هاجس: إن «وهَم الصندوق الأسود» في الذكاء الاصطناعي والتعاقد «الشفاف» في البلوك تشين يتصادمان بطبيعتهم. إذا أخطأ النموذج في الاستدلال، فمن سيتحمل مخاطر القرارات التلقائية على السلسلة؟ حاليًا أشارك بمركز صغير للمراقبة فقط؛ لا أرغب في الرهان الأعمى، ولا أريد أن أفوّت الفرصة.
عندما يستطيع الذكاء الاصطناعي تقديم خدمات بسرعة فائقة مع قفل الخصوصية فعليًا، هل سيكون خصمًا شرسًا لعمالقة الصناعة؟ أم أنه مقامرة تقنية؟ لِنترقّب كيف سيحل مشكلته التالية @OpenGradient