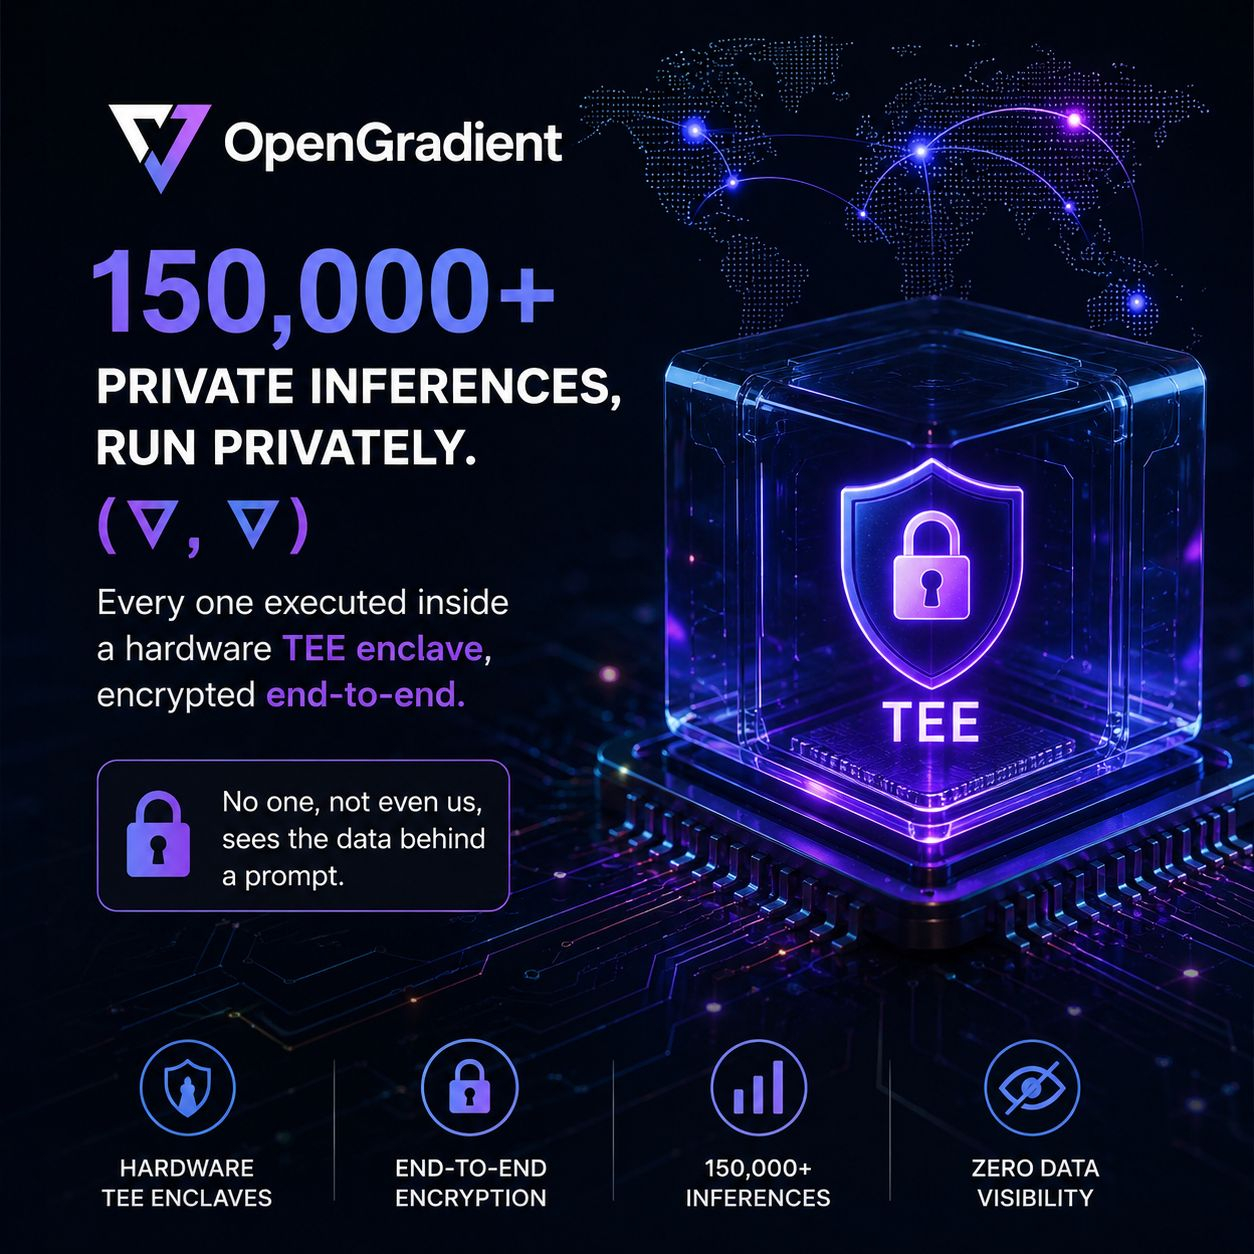
ما يبرز بالنسبة لي هو أن الذكاء الاصطناعي السري أصبح أقل تحديًا في التشفير وأكثر تحديًا في تخصيص الموارد. تشغيل أكثر من 150,000 استدلال خاص داخل مناطق تنفيذ موثوقة يوضح أن التنفيذ الآمن يمكن أن يعمل على نطاق كبير، لكن الحجم وحده لا يحدد الاستدامة على المدى الطويل. السؤال الحقيقي هو ما إذا كان التنفيذ السري سيظل تنافسيًا من الناحية الاقتصادية مع زيادة الطلب.
في الذكاء الاصطناعي اللامركزي، غالبًا ما يتم التعامل مع الثقة كخاصية ثنائية: إما أن يكون التنفيذ قابلًا للتحقق وسريًا أو لا. في الواقع، الثقة موجودة على منحنى التكلفة. كل طبقة من التحقق، وعزل المناطق، وإدارة الحالة الآمنة تحسن من ضمانات الأمان بينما تستهلك في الوقت نفسه موارد يمكن أن تزيد من معدل الإنتاج. مع نمو الشبكات، تصبح هذه المقايضة مشكلة بنية تحتية بدلاً من كونها مشكلة أمان بحتة.
وجهة نظري هي أن أكثر مشاريع بنية الذكاء الاصطناعي نجاحًا لن تكون بالضرورة تلك التي تتمتع بأقوى ضمانات الخصوصية. ستكون المشاريع التي تحقق أفضل نسبة ثقة إلى تكلفة. هذه التفرقة مهمة لأن المطورين في نهاية المطاف يعملون على تحسين قابلية النشر. إذا كان التنفيذ السري يزيد بشكل كبير من الكمون أو التكاليف التشغيلية، فقد تهاجر التطبيقات التي تتطلب استدلالًا في الوقت الفعلي نحو هياكل ذات افتراضات ثقة أضعف ولكن خصائص أداء أفضل.
أعتقد أن التحدي الحقيقي هو أن النجاح قد يخلق عنق زجاجة خاص به. إذا أصبح الذكاء الاصطناعي السري مُعتمدًا على نطاق واسع عبر Web3، فقد ينمو الطلب على الحسابات المحمية أسرع من البنية التحتية المصممة لدعمه. في هذا السيناريو، هل ينبغي على الشبكات المستقبلية تحسين الثقة القصوى أم القابلية للتوسع القصوى؟🤔
#OPG @OpenGradient $OPG
في الذكاء الاصطناعي اللامركزي، غالبًا ما يتم التعامل مع الثقة كخاصية ثنائية: إما أن يكون التنفيذ قابلًا للتحقق وسريًا أو لا. في الواقع، الثقة موجودة على منحنى التكلفة. كل طبقة من التحقق، وعزل المناطق، وإدارة الحالة الآمنة تحسن من ضمانات الأمان بينما تستهلك في الوقت نفسه موارد يمكن أن تزيد من معدل الإنتاج. مع نمو الشبكات، تصبح هذه المقايضة مشكلة بنية تحتية بدلاً من كونها مشكلة أمان بحتة.
وجهة نظري هي أن أكثر مشاريع بنية الذكاء الاصطناعي نجاحًا لن تكون بالضرورة تلك التي تتمتع بأقوى ضمانات الخصوصية. ستكون المشاريع التي تحقق أفضل نسبة ثقة إلى تكلفة. هذه التفرقة مهمة لأن المطورين في نهاية المطاف يعملون على تحسين قابلية النشر. إذا كان التنفيذ السري يزيد بشكل كبير من الكمون أو التكاليف التشغيلية، فقد تهاجر التطبيقات التي تتطلب استدلالًا في الوقت الفعلي نحو هياكل ذات افتراضات ثقة أضعف ولكن خصائص أداء أفضل.
أعتقد أن التحدي الحقيقي هو أن النجاح قد يخلق عنق زجاجة خاص به. إذا أصبح الذكاء الاصطناعي السري مُعتمدًا على نطاق واسع عبر Web3، فقد ينمو الطلب على الحسابات المحمية أسرع من البنية التحتية المصممة لدعمه. في هذا السيناريو، هل ينبغي على الشبكات المستقبلية تحسين الثقة القصوى أم القابلية للتوسع القصوى؟🤔
#OPG @OpenGradient $OPG