معظم الناس الذين يقيمون مشاريع الذكاء الاصطناعي يسألون نفس السؤال:
"ما مدى قدرة النموذج؟"
بعد قضاء بعض الوقت في استكشاف @OpenGradient
أعتقد أن هناك سؤالًا أكثر أهمية يجري تجاهله.
"ماذا يحدث بعد أن ينتج النموذج إجابة؟"
قد يبدو ذلك بسيطًا، لكن هنا تبدأ العديد من التحديات المستقبلية.
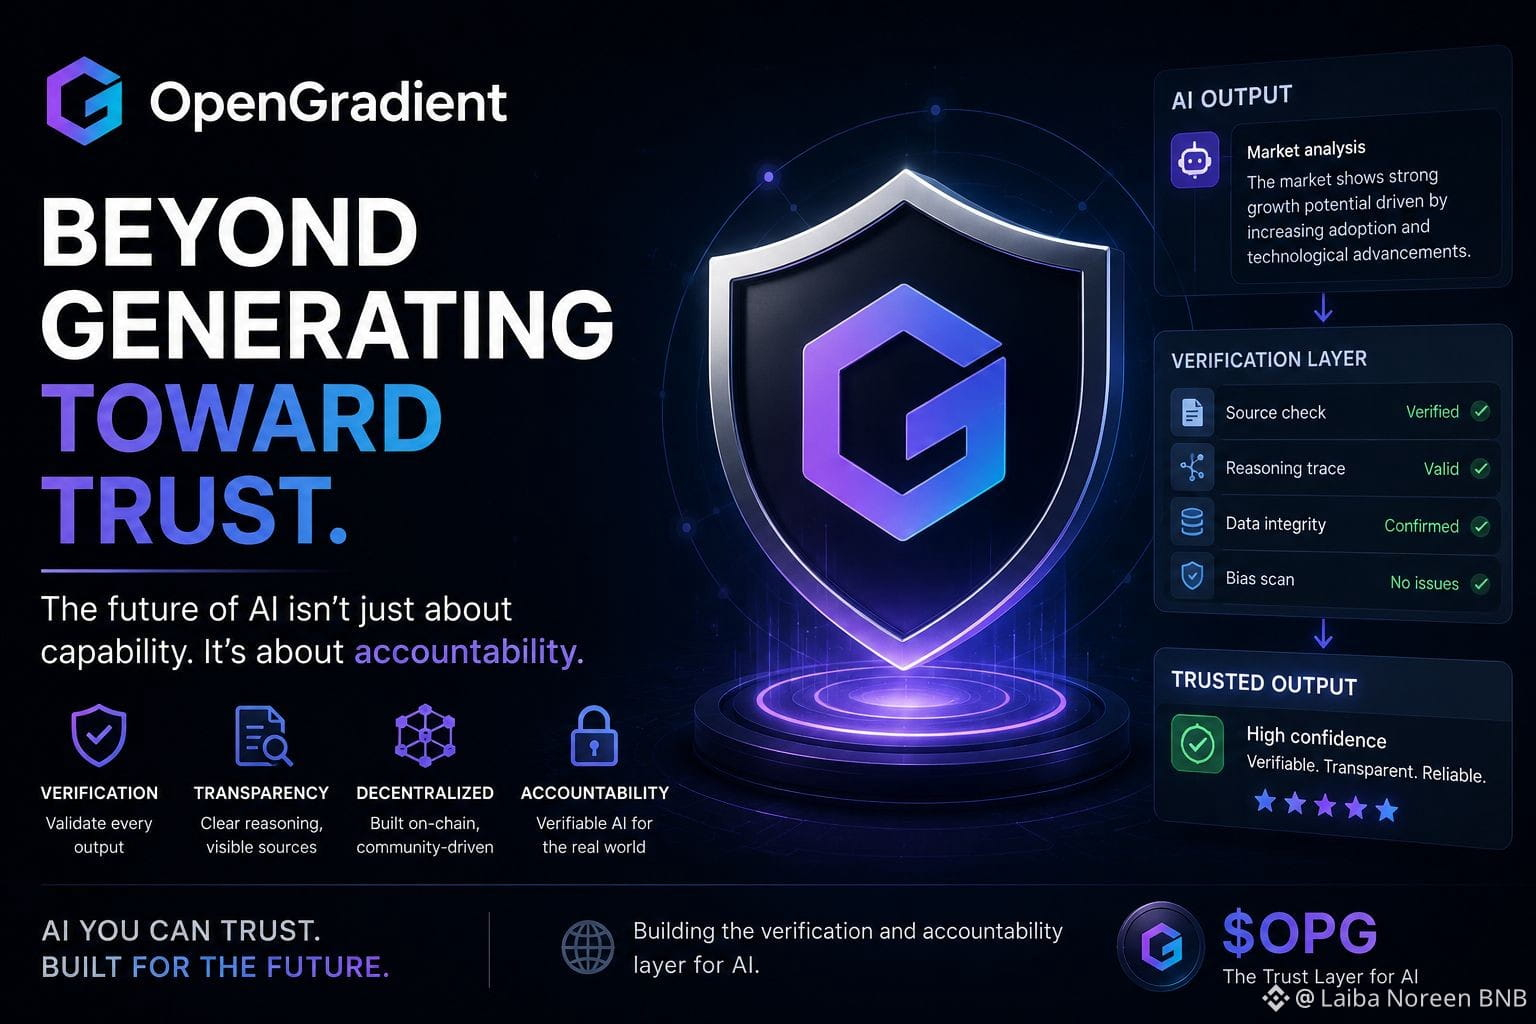
يمكن لنظام الذكاء الاصطناعي أن يولد تحليلًا للسوق، يلخص الأبحاث، يشرح موضوعًا معقدًا، أو يساعد في اتخاذ القرارات في ثوانٍ. قد يبدو الناتج مقنعًا. قد تبدو الأسباب منطقية. ومع ذلك، بالنسبة للمستخدم النهائي، غالبًا ما يكون هناك القليل من الوضوح حول مقدار الثقة التي ينبغي وضعها في تلك النتيجة.
بينما كنت أستكشف OpenGradient Chat، كان هذا الجزء هو الذي استمر في جذب انتباهي.
يبدو أن المشروع يركز على طبقة من البنية التحتية للذكاء الاصطناعي التي لا تتلقى مناقشة كافية: التحقق والمساءلة. في رأيي، تصبح هذه المفاهيم أكثر قيمة مع انتقال الذكاء الاصطناعي من التجريب إلى الاستخدام في العالم الحقيقي.
لدى الكريبتو تاريخ في مكافأة المشاريع التي تحل المشكلات قبل أن تتعرف عليها السوق الأوسع بشكل كامل. قابلية التوسع، والتشغيل البيني، والبيانات اللامركزية كانت تبدو نيشًا قبل أن تصبح سردًا رئيسيًا.
سواء تمكنت OpenGradient من تحقيق طموحاتها على المدى الطويل يبقى أن نرى، لكنني أعتقد أن السؤال الذي تعالجه يستحق الانتباه.
إذا كان من المقرر أن يؤثر الذكاء الاصطناعي على الأبحاث، والأتمتة، وعمليات الأعمال، واتخاذ القرارات المالية في السنوات المقبلة، قد تصبح الثقة واحدة من أهم قطع البازل.
تلك الإمكانية وحدها هي السبب الذي يجعلني أتابع @OpenGradient وتطوير $OPG .
$OPG #OPG
"ما مدى قدرة النموذج؟"
بعد قضاء بعض الوقت في استكشاف @OpenGradient
أعتقد أن هناك سؤالًا أكثر أهمية يجري تجاهله.
"ماذا يحدث بعد أن ينتج النموذج إجابة؟"
قد يبدو ذلك بسيطًا، لكن هنا تبدأ العديد من التحديات المستقبلية.
يمكن لنظام الذكاء الاصطناعي أن يولد تحليلًا للسوق، يلخص الأبحاث، يشرح موضوعًا معقدًا، أو يساعد في اتخاذ القرارات في ثوانٍ. قد يبدو الناتج مقنعًا. قد تبدو الأسباب منطقية. ومع ذلك، بالنسبة للمستخدم النهائي، غالبًا ما يكون هناك القليل من الوضوح حول مقدار الثقة التي ينبغي وضعها في تلك النتيجة.
بينما كنت أستكشف OpenGradient Chat، كان هذا الجزء هو الذي استمر في جذب انتباهي.
يبدو أن المشروع يركز على طبقة من البنية التحتية للذكاء الاصطناعي التي لا تتلقى مناقشة كافية: التحقق والمساءلة. في رأيي، تصبح هذه المفاهيم أكثر قيمة مع انتقال الذكاء الاصطناعي من التجريب إلى الاستخدام في العالم الحقيقي.
لدى الكريبتو تاريخ في مكافأة المشاريع التي تحل المشكلات قبل أن تتعرف عليها السوق الأوسع بشكل كامل. قابلية التوسع، والتشغيل البيني، والبيانات اللامركزية كانت تبدو نيشًا قبل أن تصبح سردًا رئيسيًا.
سواء تمكنت OpenGradient من تحقيق طموحاتها على المدى الطويل يبقى أن نرى، لكنني أعتقد أن السؤال الذي تعالجه يستحق الانتباه.
إذا كان من المقرر أن يؤثر الذكاء الاصطناعي على الأبحاث، والأتمتة، وعمليات الأعمال، واتخاذ القرارات المالية في السنوات المقبلة، قد تصبح الثقة واحدة من أهم قطع البازل.
تلك الإمكانية وحدها هي السبب الذي يجعلني أتابع @OpenGradient وتطوير $OPG .
$OPG #OPG