أعتقد أن هذا واحد من أكثر الأسئلة إثارة للاهتمام في الذكاء الاصطناعي في الوقت الحالي.
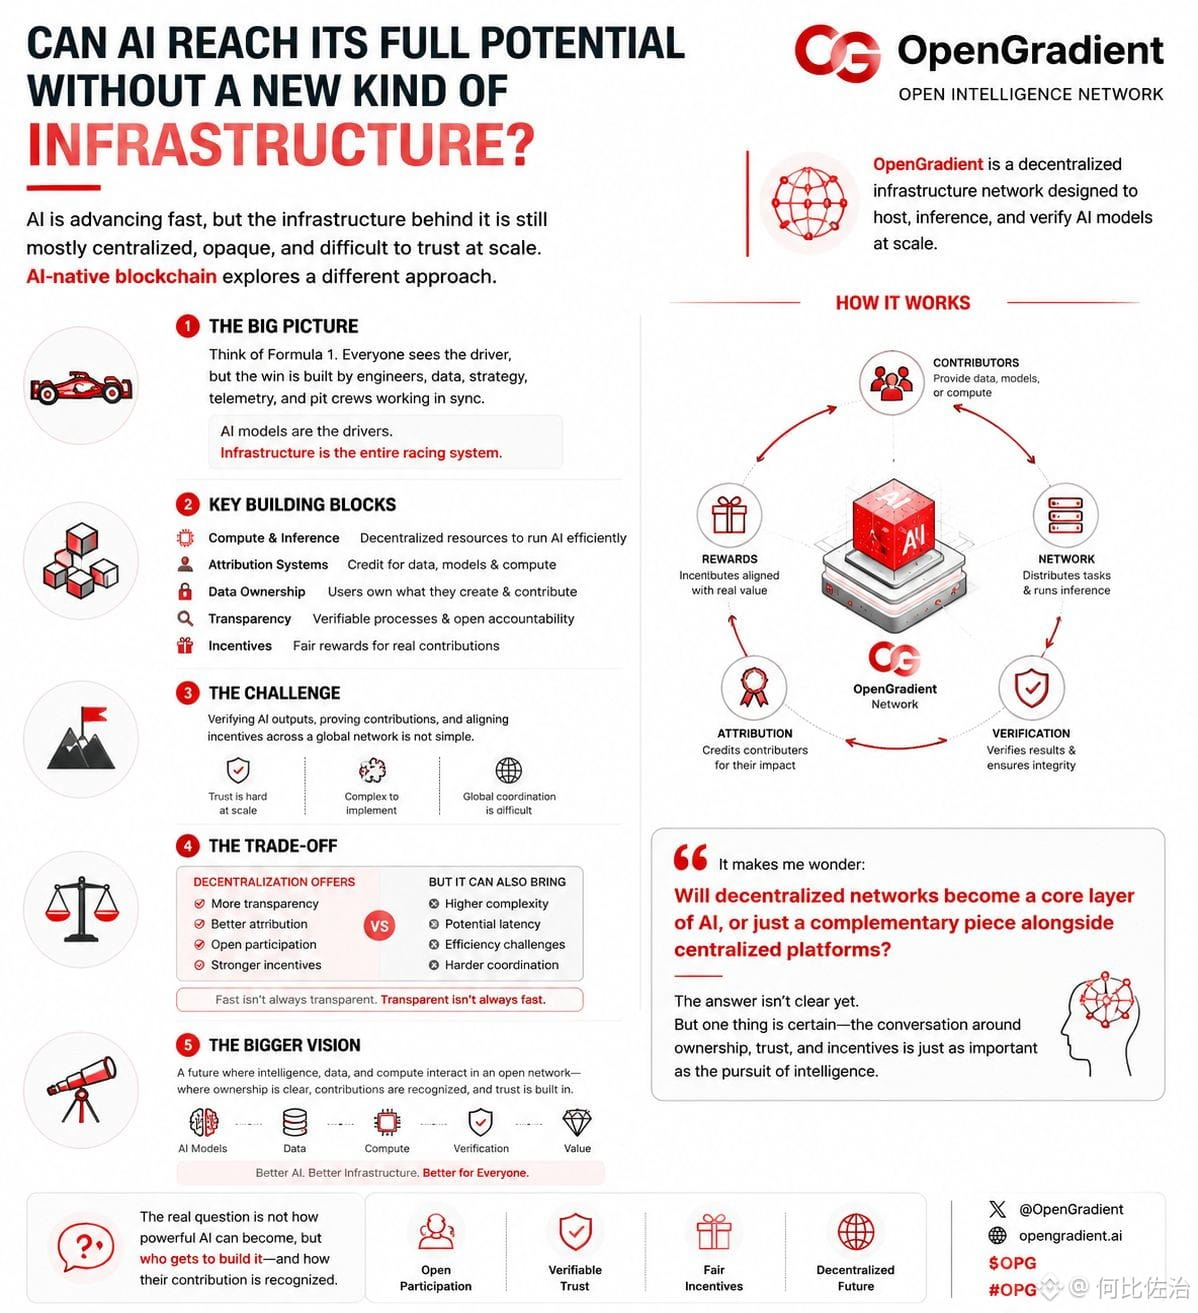
تركز معظم المناقشات على النماذج، والمعايير، والقدرات. لكن مع تزايد دمج الذكاء الاصطناعي في الحياة اليومية، أظل أتساءل عن الأنظمة التي تدعمه. من يملك البيانات؟ من يحصل على المكافأة لمساهمته في الموارد؟ وكيف نعرف ما الذي يفعله نظام الذكاء الاصطناعي فعلاً خلف الكواليس؟
ما أفهمه هو أن البلوكشين الأصلي للذكاء الاصطناعي يحاول استكشاف هذه الأسئلة بدلاً من مجرد جعل الذكاء الاصطناعي أكبر أو أسرع. الفكرة تبدو أقل حول الضجة وأكثر حول إنشاء بنية تحتية حيث يمكن تتبع العمليات، والنماذج، والمساهمات والتحقق منها بشكل أكثر شفافية.
يذكرني قليلاً بسباقات الفورمولا 1. يرى الناس السائق في يوم السباق، لكن هناك المئات من المهندسين، والفنيين، والأنظمة تعمل في الخلفية. نماذج الذكاء الاصطناعي مشابهة. نلاحظ الناتج، لكن نادراً ما نفكر في البنية التحتية التي جعلت ذلك ممكنًا.
بالطبع، هناك تحديات. المزيد من الشفافية يمكن أن يعني مزيدًا من التعقيد. يبدو أن التخصيص الأفضل رائع، لكن تنفيذه على نطاق واسع ليس سهلاً. ورغم أن اللامركزية يمكن أن تخلق هياكل تحفيزية جديدة، قد لا يكون ذلك دائمًا هو المسار الأكثر كفاءة.
ومع ذلك، يجعلني أتساءل ما إذا كانت مستقبل الذكاء الاصطناعي سيعتمد بقدر ما على الثقة والملكية كما يعتمد على الذكاء نفسه.
مشاريع مثل OpenGradient تستكشف هذا المجال، وسواء أصبحت هذه الأفكار سائدة أم لا، أعتقد أنها تثير أسئلة مهمة حول كيفية تطور بنية الذكاء الاصطناعي.
السؤال الحقيقي ليس فقط مدى قوة الذكاء الاصطناعي، ولكن من يحق له المشاركة في بنائه وكيف يتم الاعتراف بتلك المشاركة.
@OpenGradient
$OPG
#OPG
تركز معظم المناقشات على النماذج، والمعايير، والقدرات. لكن مع تزايد دمج الذكاء الاصطناعي في الحياة اليومية، أظل أتساءل عن الأنظمة التي تدعمه. من يملك البيانات؟ من يحصل على المكافأة لمساهمته في الموارد؟ وكيف نعرف ما الذي يفعله نظام الذكاء الاصطناعي فعلاً خلف الكواليس؟
ما أفهمه هو أن البلوكشين الأصلي للذكاء الاصطناعي يحاول استكشاف هذه الأسئلة بدلاً من مجرد جعل الذكاء الاصطناعي أكبر أو أسرع. الفكرة تبدو أقل حول الضجة وأكثر حول إنشاء بنية تحتية حيث يمكن تتبع العمليات، والنماذج، والمساهمات والتحقق منها بشكل أكثر شفافية.
يذكرني قليلاً بسباقات الفورمولا 1. يرى الناس السائق في يوم السباق، لكن هناك المئات من المهندسين، والفنيين، والأنظمة تعمل في الخلفية. نماذج الذكاء الاصطناعي مشابهة. نلاحظ الناتج، لكن نادراً ما نفكر في البنية التحتية التي جعلت ذلك ممكنًا.
بالطبع، هناك تحديات. المزيد من الشفافية يمكن أن يعني مزيدًا من التعقيد. يبدو أن التخصيص الأفضل رائع، لكن تنفيذه على نطاق واسع ليس سهلاً. ورغم أن اللامركزية يمكن أن تخلق هياكل تحفيزية جديدة، قد لا يكون ذلك دائمًا هو المسار الأكثر كفاءة.
ومع ذلك، يجعلني أتساءل ما إذا كانت مستقبل الذكاء الاصطناعي سيعتمد بقدر ما على الثقة والملكية كما يعتمد على الذكاء نفسه.
مشاريع مثل OpenGradient تستكشف هذا المجال، وسواء أصبحت هذه الأفكار سائدة أم لا، أعتقد أنها تثير أسئلة مهمة حول كيفية تطور بنية الذكاء الاصطناعي.
السؤال الحقيقي ليس فقط مدى قوة الذكاء الاصطناعي، ولكن من يحق له المشاركة في بنائه وكيف يتم الاعتراف بتلك المشاركة.
@OpenGradient
$OPG
#OPG