كنت أعتقد أن مستقبل بنية الذكاء الاصطناعي يتعلق في الغالب بالوصول إلى النماذج.
المزيد من النماذج.
نماذج أفضل.
سوق أكبر.
مكان واحد حيث يمكن للمستخدمين والمطورين اختيار أي ذكاء يحتاجونه.
كان يبدو ذلك منطقيًا.
لكن كلما نظرت إلى أين يتجه الذكاء الاصطناعي، شعرت أن تلك الفكرة غير مكتملة.
لأن النموذج الذي يجلس في السوق هو فقط إمكانية.
تبدأ الأسئلة الحقيقية عندما يتعين على هذا النموذج أن يعمل، وينتج مخرجات، ويشغل تدفق عمل، ويمكّن وكيلًا، أو يتفاعل مع تطبيق يعتمد على النتيجة.
هنا يتوقف الذكاء الاصطناعي عن كونه محتوى.
يصبح تنفيذًا.
والتنفيذ يحتاج إلى نوع مختلف من البنية التحتية.
إذا كان نموذج الذكاء الاصطناعي يولد نصوصًا فقط، قد يتحمل المستخدمون بعض عدم اليقين. لكن عندما يبدأ الذكاء الاصطناعي في تمكين الوكلاء، والأدوات المالية، والتطبيقات على السلسلة، وتدفقات البيانات، والقرارات الآلية، لم يعد السؤال مجرد:
"أي نموذج متاح؟"
بل يصبح:
أين تم تشغيل الاستدلال؟
هل يمكن التحقق من المخرجات؟
هل تم تنفيذ النموذج بشكل صحيح؟
هل يمكن تدقيق العملية لاحقًا؟
هل يمكن للتطبيقات الوثوق في النتيجة دون الثقة بمزود مركزي واحد؟
لهذا السبب لفت انتباهي OpenGradient.
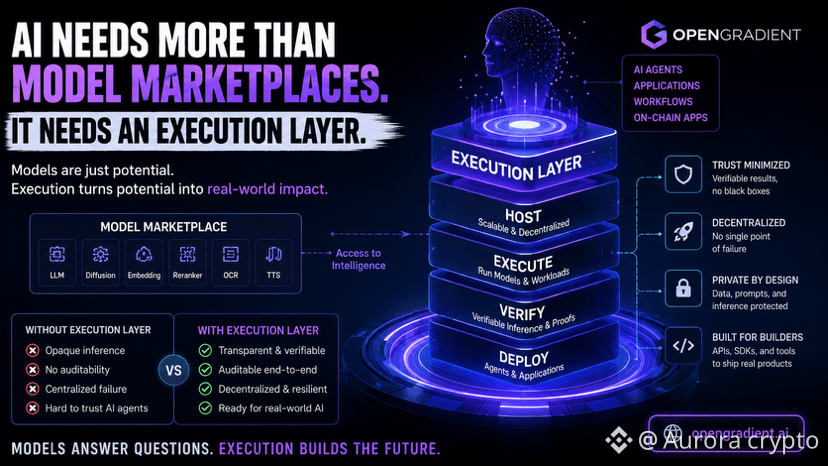
ليس لأنه ببساطة يبني مكانًا آخر لاكتشاف نماذج الذكاء الاصطناعي، ولكن لأنه يبدو مركزًا على الطبقة التي تلي الاكتشاف: الاستضافة، والتنفيذ، والتحقق، والنشر.
هذا الاختلاف مهم.
يساعد مركز النماذج المستخدمين في العثور على الذكاء.
تساعد طبقة التنفيذ الذكاء على أن يصبح قابلًا للاستخدام في الأنظمة الحقيقية.
وربما هذا هو الجزء من الذكاء الاصطناعي في Web3 الذي لا يزال السوق يقلل من شأنه.
قد لا ينتمي المستقبل فقط إلى المنصات التي تحتوي على أكبر عدد من النماذج.
قد ينتمي إلى بنية تحتية يمكنها إثبات ما فعلته تلك النماذج بعد استدعائها.
لأنه في النهاية، الوصول إلى الذكاء هو فقط البداية.
التنفيذ الموثوق هو ما يجعله مفيدًا.
@OpenGradient $OPG #opg
المزيد من النماذج.
نماذج أفضل.
سوق أكبر.
مكان واحد حيث يمكن للمستخدمين والمطورين اختيار أي ذكاء يحتاجونه.
كان يبدو ذلك منطقيًا.
لكن كلما نظرت إلى أين يتجه الذكاء الاصطناعي، شعرت أن تلك الفكرة غير مكتملة.
لأن النموذج الذي يجلس في السوق هو فقط إمكانية.
تبدأ الأسئلة الحقيقية عندما يتعين على هذا النموذج أن يعمل، وينتج مخرجات، ويشغل تدفق عمل، ويمكّن وكيلًا، أو يتفاعل مع تطبيق يعتمد على النتيجة.
هنا يتوقف الذكاء الاصطناعي عن كونه محتوى.
يصبح تنفيذًا.
والتنفيذ يحتاج إلى نوع مختلف من البنية التحتية.
إذا كان نموذج الذكاء الاصطناعي يولد نصوصًا فقط، قد يتحمل المستخدمون بعض عدم اليقين. لكن عندما يبدأ الذكاء الاصطناعي في تمكين الوكلاء، والأدوات المالية، والتطبيقات على السلسلة، وتدفقات البيانات، والقرارات الآلية، لم يعد السؤال مجرد:
"أي نموذج متاح؟"
بل يصبح:
أين تم تشغيل الاستدلال؟
هل يمكن التحقق من المخرجات؟
هل تم تنفيذ النموذج بشكل صحيح؟
هل يمكن تدقيق العملية لاحقًا؟
هل يمكن للتطبيقات الوثوق في النتيجة دون الثقة بمزود مركزي واحد؟
لهذا السبب لفت انتباهي OpenGradient.
ليس لأنه ببساطة يبني مكانًا آخر لاكتشاف نماذج الذكاء الاصطناعي، ولكن لأنه يبدو مركزًا على الطبقة التي تلي الاكتشاف: الاستضافة، والتنفيذ، والتحقق، والنشر.
هذا الاختلاف مهم.
يساعد مركز النماذج المستخدمين في العثور على الذكاء.
تساعد طبقة التنفيذ الذكاء على أن يصبح قابلًا للاستخدام في الأنظمة الحقيقية.
وربما هذا هو الجزء من الذكاء الاصطناعي في Web3 الذي لا يزال السوق يقلل من شأنه.
قد لا ينتمي المستقبل فقط إلى المنصات التي تحتوي على أكبر عدد من النماذج.
قد ينتمي إلى بنية تحتية يمكنها إثبات ما فعلته تلك النماذج بعد استدعائها.
لأنه في النهاية، الوصول إلى الذكاء هو فقط البداية.
التنفيذ الموثوق هو ما يجعله مفيدًا.
@OpenGradient $OPG #opg