لقد لاحظت شيئًا مثيرًا للاهتمام في عالم الكريبتو.
كلما حصل مشروع جديد في الذكاء الاصطناعي على اهتمام، تتحول المحادثة بسرعة إلى سباق للعثور على من لديه أكبر قدر من الحوسبة، وأكبر النماذج، أو أقوى البنى التحتية. الفرضية بسيطة: من يمكنه استضافة أكبر قدر من الذكاء هو الفائز.
ربما تكون هذه أول استنتاج يصل إليه معظم الناس عند النظر إلى @OpenGradient أيضًا.
لكن كلما فكرت في الأمر أكثر، كلما كنت أقل اقتناعًا بأن استضافة الذكاء هي أصعب مشكلة.
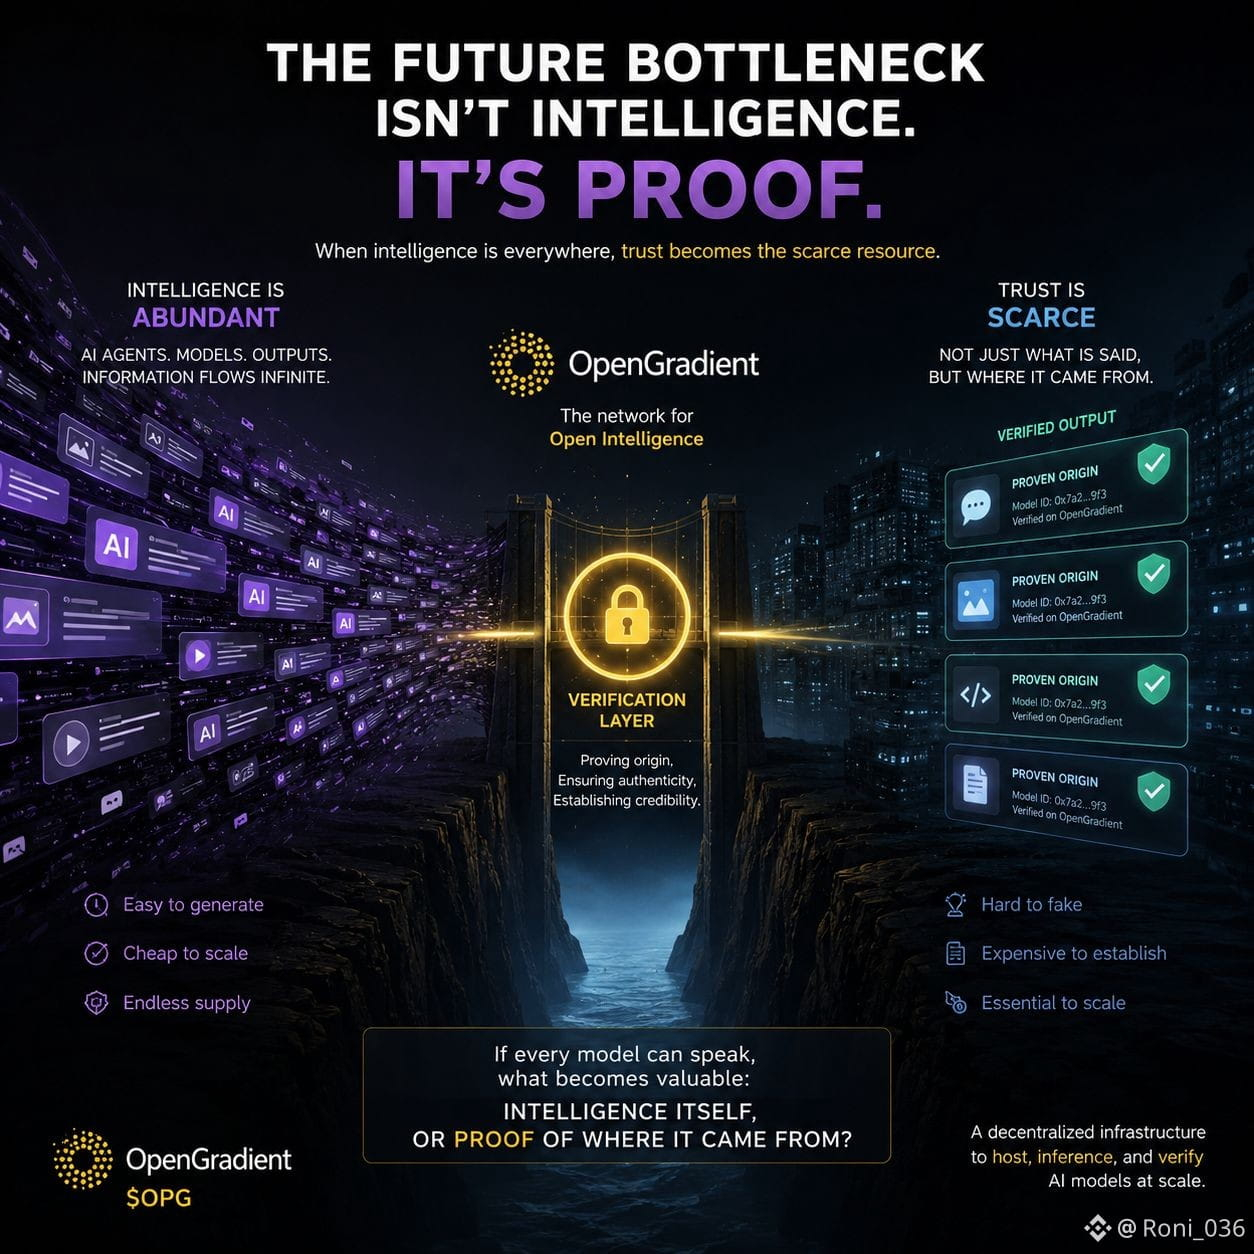
تخيل مستقبلًا حيث تكون وكلاء الذكاء الاصطناعي في كل مكان. وكلاء البحث، وكلاء التداول، وكلاء دعم العملاء، وبرامج مستقلة. يتحول توليد المعلومات إلى شيء رخيص ودائم. تتدفق المخرجات إلى كل زاوية من زوايا الإنترنت.
الآن اسأل سؤالًا مختلفًا.
كيف تعرف أن المخرجات جاءت فعلاً من النموذج أو الوكيل أو النظام الذي يدعي أنه أنتجها؟
يبدو أن هذا تفصيل صغير اليوم، لكنه قد يصبح طبقة اقتصادية مهمة غدًا. إذا أصبح الذكاء وفيرًا، فإن الثقة لا تصبح وفيرة تلقائيًا معه.
لهذا السبب يجعلني @OpenGradient أفكر أقل في قدرة الذكاء الاصطناعي وأكثر في مصداقية الذكاء الاصطناعي. ليس لأنني أعرف أن السوق يتجه إلى هناك، ولكن لأن هذا سؤال يبدو غريبًا أنه لم يتم استكشافه بما فيه الكفاية.
ربما تكون عنق الزجاجة في المستقبل ليست إنشاء الذكاء.
ربما هي إثبات مصدر الذكاء.
#opg $OPG
@OpenGradient