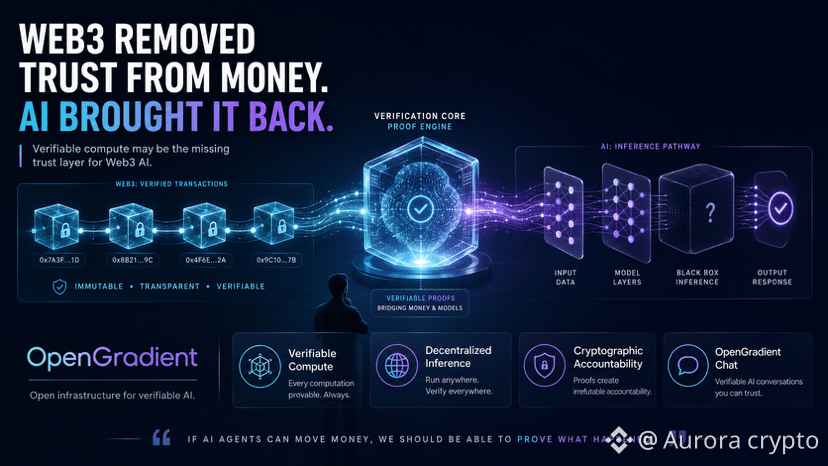
لقد قضت Web3 سنوات في محاولة إزالة الثقة من المال.
ثم أعاد الذكاء الاصطناعي الثقة من الباب الجانبي.
هذه هي النقطة التي أستمر في التفكير فيها.
في عالم الكريبتو، تعلمنا كيفية التحقق من المعاملات. تعلمنا كيفية فحص العناوين، التوقيعات، السيولة، كود العقود، وتاريخ السلسلة. كانت الثقافة بأكملها مبنية حول فكرة واحدة: لا تثق، تحقق.
لكن مع الذكاء الاصطناعي، عاد معظم الناس فجأة إلى الثقة في صندوق أسود.
نحن نثق في النموذج.
نحن نثق في المزود.
نحن نثق في واجهة البرمجة.
نحن نثق أن المخرجات لم تتغير.
نحن نثق أن الاستنتاج تم بالطريقة التي تقولها الواجهة.
والآن يتم ربط وكلاء الذكاء الاصطناعي بالمحافظ، أدوات التداول، أنظمة البيانات، سير العمل، والتطبيقات على السلسلة.
هذا يجعلني غير مرتاح.
لأنه عندما يكتب الذكاء الاصطناعي نصًا فقط، يمكن أن تكون الخطأ مزعجًا. ولكن عندما يتخذ وكيل الذكاء الاصطناعي إجراءً، يمكن أن يصبح الخطأ ماليًا أو تشغيليًا أو دائمًا.
لكنني أيضًا متشكك بشأن مدى سهولة استخدام هذه العبارة.
التحقق من الحسابات لا يجعل النموذج حكيمًا تلقائيًا.
لا يجعل البيانات السيئة جيدة.
لا يجعل كل قرار من قرارات الذكاء الاصطناعي آمنًا.
ما يمكن أن يفعله هو شيء أضيق، ولكن ربما أكثر أهمية:
يمكن أن يظهر ما إذا كانت العملية قد حدثت كما تم الادعاء.
أي نموذج تم تشغيله؟
ما الطلب الذي تمت معالجته؟
هل تم تغيير المخرجات؟
هل يمكن تدقيق التنفيذ لاحقًا؟
لهذا السبب أشعر أن OpenGradient ذات صلة بالنسبة لي.
ليس لأنها تحل سحريًا كل مشكلة في Web3 AI، ولكن لأنها تعمل على طبقة الثقة التي قد يحتاجها وكلاء الذكاء الاصطناعي قبل أن يتمكنوا من التعامل بأمان مع الأنظمة الجادة.
وأعتقد أن هذا أصبح أكثر أهمية الآن لأن حديث OpenGradient لم يعد يدور حول تطبيق دردشة واحد فقط. الناس يتحدثون عن دردشة ذكاء اصطناعي خاصة، استوديو الصور، الوصول متعدد النماذج، الاستنتاج اللامركزي.
كلما أصبح الذكاء الاصطناعي مفيدًا، كلما زادت الثقة غير المرئية التي نطلب قبولها.
هذه هي النقطة التي أريد أن أرى OpenGradient تثبتها.
ليس فقط أن الذكاء الاصطناعي القابل للتحقق يبدو جيدًا.
ولكن أنه يصبح مفهومًا، قابلًا للاستخدام، ومهمًا بما فيه الكفاية ليهتم المستخدمون العاديون.
النظام يحتاج إلى دليل.
@OpenGradient $OPG #opg
ثم أعاد الذكاء الاصطناعي الثقة من الباب الجانبي.
هذه هي النقطة التي أستمر في التفكير فيها.
في عالم الكريبتو، تعلمنا كيفية التحقق من المعاملات. تعلمنا كيفية فحص العناوين، التوقيعات، السيولة، كود العقود، وتاريخ السلسلة. كانت الثقافة بأكملها مبنية حول فكرة واحدة: لا تثق، تحقق.
لكن مع الذكاء الاصطناعي، عاد معظم الناس فجأة إلى الثقة في صندوق أسود.
نحن نثق في النموذج.
نحن نثق في المزود.
نحن نثق في واجهة البرمجة.
نحن نثق أن المخرجات لم تتغير.
نحن نثق أن الاستنتاج تم بالطريقة التي تقولها الواجهة.
والآن يتم ربط وكلاء الذكاء الاصطناعي بالمحافظ، أدوات التداول، أنظمة البيانات، سير العمل، والتطبيقات على السلسلة.
هذا يجعلني غير مرتاح.
لأنه عندما يكتب الذكاء الاصطناعي نصًا فقط، يمكن أن تكون الخطأ مزعجًا. ولكن عندما يتخذ وكيل الذكاء الاصطناعي إجراءً، يمكن أن يصبح الخطأ ماليًا أو تشغيليًا أو دائمًا.
لكنني أيضًا متشكك بشأن مدى سهولة استخدام هذه العبارة.
التحقق من الحسابات لا يجعل النموذج حكيمًا تلقائيًا.
لا يجعل البيانات السيئة جيدة.
لا يجعل كل قرار من قرارات الذكاء الاصطناعي آمنًا.
ما يمكن أن يفعله هو شيء أضيق، ولكن ربما أكثر أهمية:
يمكن أن يظهر ما إذا كانت العملية قد حدثت كما تم الادعاء.
أي نموذج تم تشغيله؟
ما الطلب الذي تمت معالجته؟
هل تم تغيير المخرجات؟
هل يمكن تدقيق التنفيذ لاحقًا؟
لهذا السبب أشعر أن OpenGradient ذات صلة بالنسبة لي.
ليس لأنها تحل سحريًا كل مشكلة في Web3 AI، ولكن لأنها تعمل على طبقة الثقة التي قد يحتاجها وكلاء الذكاء الاصطناعي قبل أن يتمكنوا من التعامل بأمان مع الأنظمة الجادة.
وأعتقد أن هذا أصبح أكثر أهمية الآن لأن حديث OpenGradient لم يعد يدور حول تطبيق دردشة واحد فقط. الناس يتحدثون عن دردشة ذكاء اصطناعي خاصة، استوديو الصور، الوصول متعدد النماذج، الاستنتاج اللامركزي.
كلما أصبح الذكاء الاصطناعي مفيدًا، كلما زادت الثقة غير المرئية التي نطلب قبولها.
هذه هي النقطة التي أريد أن أرى OpenGradient تثبتها.
ليس فقط أن الذكاء الاصطناعي القابل للتحقق يبدو جيدًا.
ولكن أنه يصبح مفهومًا، قابلًا للاستخدام، ومهمًا بما فيه الكفاية ليهتم المستخدمون العاديون.
النظام يحتاج إلى دليل.
@OpenGradient $OPG #opg