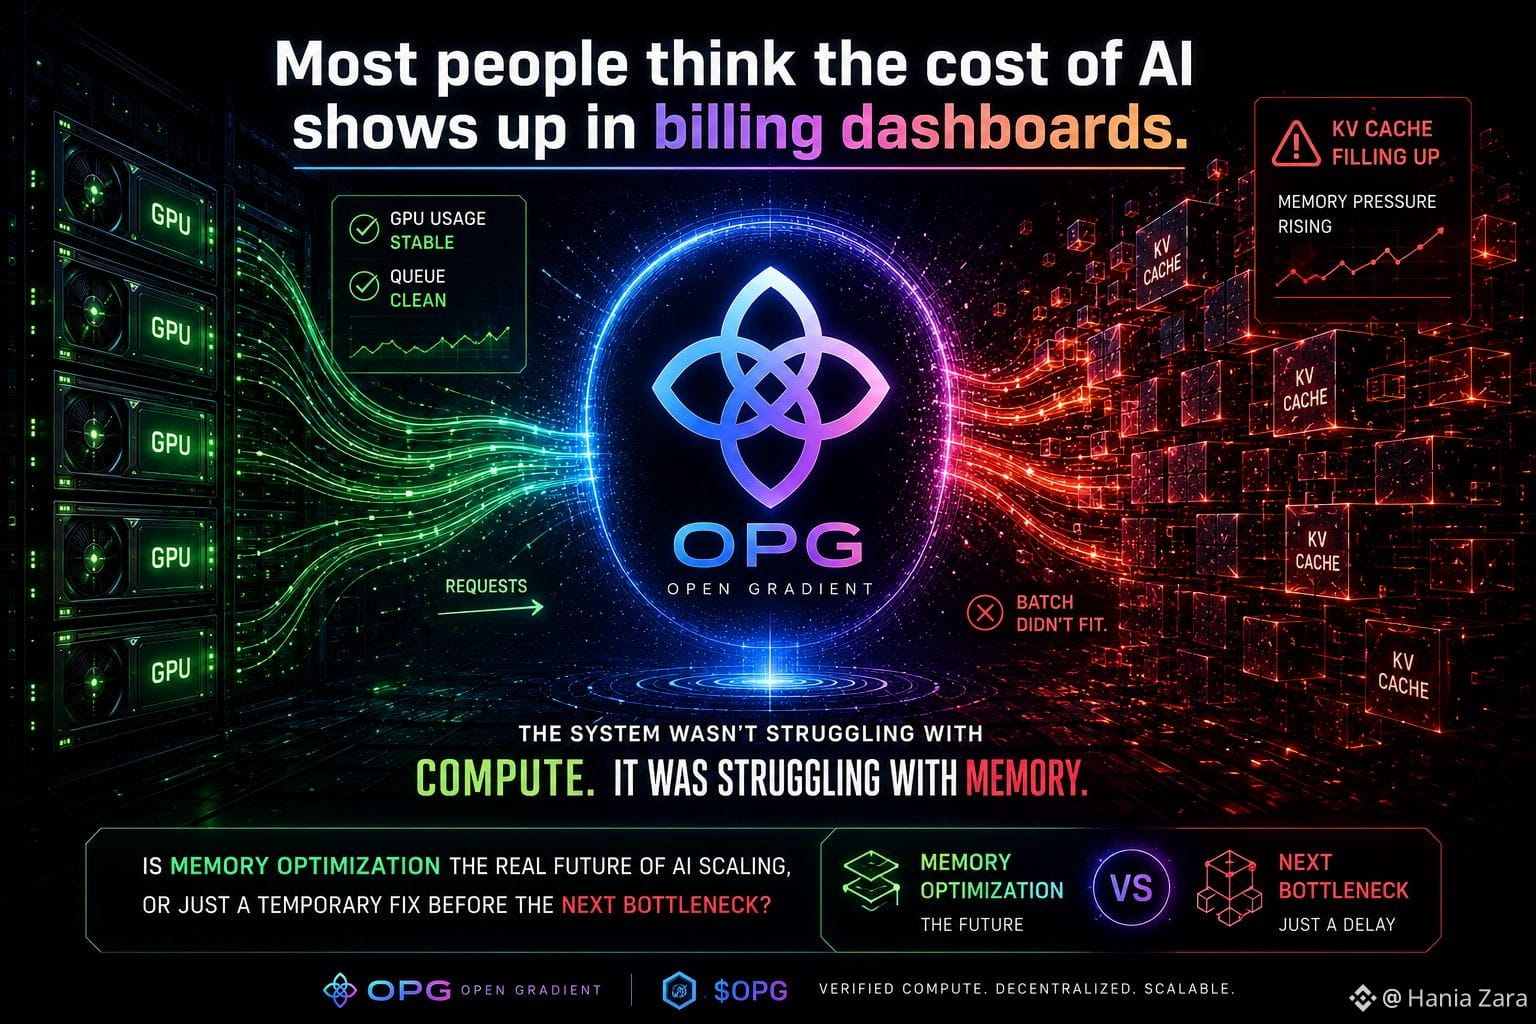
أغلب الناس يعتقدون أن تكلفة الذكاء الاصطناعي تظهر في لوحات الفوترة.
لكن بصراحة... مو هنا اللي تحس فيه فعلاً.
أول مرة لاحظت فيها، كل شيء كان يبدو تمام — استخدام GPU ثابت، قائمة الانتظار نظيفة، ما في شيء مقلق.
لكن دفعة واحدة ما كانت مناسبة.
وهنا جاني الإدراك... النظام مو كان يعاني من القدرة الحاسوبية.
كان يعاني من الذاكرة.
النصوص الطويلة كانت تحتفظ بسلاسل KV مثل مساحة مؤقتة ما تنفك تمامًا — ببطء تقلل من كمية البيانات اللي النظام يقدر يستوعبها.
إدارة سلاسل KV المعتمدة على الصفحات تحاول تصلح هذا عن طريق تقسيم الذاكرة إلى صفحات أصغر قابلة لإعادة الاستخدام. المزيد من الطلبات تناسب، والمحادثات الطويلة ما تصير عنق زجاجة على طول.
لكن هنا النقاش الحقيقي:
هل هذا كافي لمستقبل أنظمة الذكاء الاصطناعي مثل OpenGradient Chat (https://chat.opengradient.ai)؟
أو إحنا بس نؤجل عنق الزجاجة الجاي؟
لأن توسيع القدرة الحاسوبية الموثوقة مع $OPG مو بس مشكلة أداء بعد الآن... هي مشكلة معمارية.
فشو رأيك:
👉 هل تحسين الذاكرة هو المستقبل الحقيقي لتوسيع الذكاء الاصطناعي، أو بس حل مؤقت؟
@OpenGradient
#opengradientchat
#OPG
$OPG
لكن بصراحة... مو هنا اللي تحس فيه فعلاً.
أول مرة لاحظت فيها، كل شيء كان يبدو تمام — استخدام GPU ثابت، قائمة الانتظار نظيفة، ما في شيء مقلق.
لكن دفعة واحدة ما كانت مناسبة.
وهنا جاني الإدراك... النظام مو كان يعاني من القدرة الحاسوبية.
كان يعاني من الذاكرة.
النصوص الطويلة كانت تحتفظ بسلاسل KV مثل مساحة مؤقتة ما تنفك تمامًا — ببطء تقلل من كمية البيانات اللي النظام يقدر يستوعبها.
إدارة سلاسل KV المعتمدة على الصفحات تحاول تصلح هذا عن طريق تقسيم الذاكرة إلى صفحات أصغر قابلة لإعادة الاستخدام. المزيد من الطلبات تناسب، والمحادثات الطويلة ما تصير عنق زجاجة على طول.
لكن هنا النقاش الحقيقي:
هل هذا كافي لمستقبل أنظمة الذكاء الاصطناعي مثل OpenGradient Chat (https://chat.opengradient.ai)؟
أو إحنا بس نؤجل عنق الزجاجة الجاي؟
لأن توسيع القدرة الحاسوبية الموثوقة مع $OPG مو بس مشكلة أداء بعد الآن... هي مشكلة معمارية.
فشو رأيك:
👉 هل تحسين الذاكرة هو المستقبل الحقيقي لتوسيع الذكاء الاصطناعي، أو بس حل مؤقت؟
@OpenGradient
#opengradientchat
#OPG
$OPG