كنت أظن أن خصوصية الذكاء الاصطناعي تتعلق بشكل أساسي بالبيانات.
أين يتم تخزينها.
من يمكنه الوصول إليها.
مدة الاحتفاظ بها.
هذا لا يزال مهمًا.
لكن كلما استخدمت دردشة الذكاء الاصطناعي أكثر، شعرت أن المشكلة أعمق من مجرد التخزين.
لم يعد الناس يسألون الذكاء الاصطناعي عن المعلومات فقط. بل يسألونه أسئلة قد لا يطرحونها على أي شخص آخر. مخاوف مهنية. قلق مالي. مشكلات صحية. مخاوف خاصة. أفكار غير مكتملة لا يزالون يحاولون فهمها بأنفسهم.
في مرحلة ما، تتوقف دردشة الذكاء الاصطناعي عن كونها مربع بحث.
تصبح مكانًا يترك فيه الناس أجزاءً من حياتهم الداخلية.
لهذا السبب يبدو أن السؤال "من يمكنه قراءة هذا؟" أثقل بكثير مما كان عليه سابقًا.
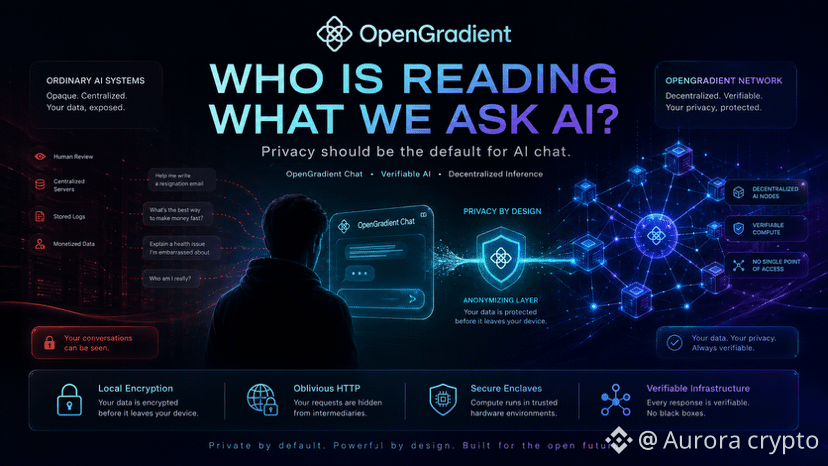
قد تبدو الواجهة بسيطة. إدخال استفسار. خروج إجابة. لكن تحت تلك اللحظة يوجد طبقة كاملة من البنية التحتية لا يراها معظم المستخدمين أبدًا.
أي نموذج تعامل مع الطلب؟
أين تم تشغيل الاستنتاج؟
هل يمكن التحقق من النتيجة؟
هل كانت العملية قابلة للتدقيق، أم أننا فقط نثق في صندوق أسود لأن الإجابة بدت واثقة؟
هنا جعلني OpenGradient Chat أتوقف.
ليس لأنه مجرد تطبيق دردشة ذكاء اصطناعي آخر، ولكن لأنه يشير إلى معيار مختلف للذكاء الاصطناعي: يجب ألا تعتمد الخصوصية فقط على الوعود، ويجب ألا تعتمد الذكاء فقط على الثقة العمياء.
فكرة OpenGradient الأوسع حول بنية الذكاء الاصطناعي القابلة للتحقق مهمة هنا. إذا أصبح الذكاء الاصطناعي شيئًا نعتمد عليه في التفكير الشخصي، الوكلاء، التطبيقات، والقرارات على السلسلة، فإن الاستنتاجات اللامركزية، المساءلة التشفيرية، والبنية التحتية المفتوحة تتوقف عن كونها تفاصيل تقنية.
تصبح جزءًا من ما إذا كان يمكن للمستخدمين الثقة في النظام على الإطلاق.
ربما مستقبل الذكاء الاصطناعي لن يتحدد فقط من خلال أي نموذج يبدو أكثر إنسانية.
ربما سيتحدد من خلال أي بنية تحتية تجعل البشر يشعرون بالأمان الكافي لطرح الأسئلة الحقيقية.
ولست متأكدًا أننا قد فهمنا مدى أهمية ذلك بعد.
@OpenGradient $OPG #opg
أين يتم تخزينها.
من يمكنه الوصول إليها.
مدة الاحتفاظ بها.
هذا لا يزال مهمًا.
لكن كلما استخدمت دردشة الذكاء الاصطناعي أكثر، شعرت أن المشكلة أعمق من مجرد التخزين.
لم يعد الناس يسألون الذكاء الاصطناعي عن المعلومات فقط. بل يسألونه أسئلة قد لا يطرحونها على أي شخص آخر. مخاوف مهنية. قلق مالي. مشكلات صحية. مخاوف خاصة. أفكار غير مكتملة لا يزالون يحاولون فهمها بأنفسهم.
في مرحلة ما، تتوقف دردشة الذكاء الاصطناعي عن كونها مربع بحث.
تصبح مكانًا يترك فيه الناس أجزاءً من حياتهم الداخلية.
لهذا السبب يبدو أن السؤال "من يمكنه قراءة هذا؟" أثقل بكثير مما كان عليه سابقًا.
قد تبدو الواجهة بسيطة. إدخال استفسار. خروج إجابة. لكن تحت تلك اللحظة يوجد طبقة كاملة من البنية التحتية لا يراها معظم المستخدمين أبدًا.
أي نموذج تعامل مع الطلب؟
أين تم تشغيل الاستنتاج؟
هل يمكن التحقق من النتيجة؟
هل كانت العملية قابلة للتدقيق، أم أننا فقط نثق في صندوق أسود لأن الإجابة بدت واثقة؟
هنا جعلني OpenGradient Chat أتوقف.
ليس لأنه مجرد تطبيق دردشة ذكاء اصطناعي آخر، ولكن لأنه يشير إلى معيار مختلف للذكاء الاصطناعي: يجب ألا تعتمد الخصوصية فقط على الوعود، ويجب ألا تعتمد الذكاء فقط على الثقة العمياء.
فكرة OpenGradient الأوسع حول بنية الذكاء الاصطناعي القابلة للتحقق مهمة هنا. إذا أصبح الذكاء الاصطناعي شيئًا نعتمد عليه في التفكير الشخصي، الوكلاء، التطبيقات، والقرارات على السلسلة، فإن الاستنتاجات اللامركزية، المساءلة التشفيرية، والبنية التحتية المفتوحة تتوقف عن كونها تفاصيل تقنية.
تصبح جزءًا من ما إذا كان يمكن للمستخدمين الثقة في النظام على الإطلاق.
ربما مستقبل الذكاء الاصطناعي لن يتحدد فقط من خلال أي نموذج يبدو أكثر إنسانية.
ربما سيتحدد من خلال أي بنية تحتية تجعل البشر يشعرون بالأمان الكافي لطرح الأسئلة الحقيقية.
ولست متأكدًا أننا قد فهمنا مدى أهمية ذلك بعد.
@OpenGradient $OPG #opg