

التخزين موش مركز تكلفة، هو نظام توزيع القيمة في Bitroot AI Stack. كثير من الفرق ما فهمتش هالموضوع إلا بعد مرور أكثر من ستة أشهر من الإطلاق. البيانات ما ضاعت، والخدمة ما توقفت، لكن المشكلة ظهرت بشكل آخر: استرجاع بيانات التدريب المؤرشفة صار أبطأ بشكل متزايد، وتأخير استعلامات المتجهات الساخنة من المستوى المللي صار للثواني. ولما جاء وقت مراجعة حادثة على الإنترنت، ما كانش في حد يعرف أي نسخة من بيانات التدريب كانت تستخدمها النموذج في الوقت داك. عند هالمرحلة، المشكلة موش إننا نوسع، لكن ثلاثة مشاكل أصعب: مين يقدر يثبت إن البيانات كانت متاحة دائماً، مين المسؤول عن النسخ، ومين يتحمل تكلفة طويلة الأمد.
فهم التخزين على أنه نقل الملفات من سحابة مركزية إلى شبكة لامركزية خارج السلسلة حتى في عصر بيانات ميتاداتا NFT. لكن ما إن يتوسع العمل إلى محتوى تدريب AI وأوزان النماذج وفهارس المتجهات، ستفشل هذه الفكرة بسرعة.
حتى اليوم، تعتبر أغلب الفرق التخزين تكلفة خدمات خلفية “كلما قلّت كان أفضل”، وهذا بالضبط هو المكان الأكثر التقليل من قيمته والأكثر سهولة في اختيار الطريق الخاطئ: في سلاسل عامة AI، يصبح التخزين طبقة توزيع قيمة تحدد من يملك البيانات ومن يحصل على الأرباح. هذه المقالة تجيب فقط عن سؤال واحد: في سيناريو دمج AI مع سلاسل عامة، كيف نبني حل تخزين موزع قابل للتحقق وقابل للحوكمة ومستدام؟ في ما يلي سنفك أولًا حدود قدرات ثلاث أنماط رئيسية، ثم نوضح الصعوبات الخاصة ببيانات AI، وأخيرًا نصل إلى بنية تنفيذ بخمس طبقات مع عتبات إطلاق على مراحل.
كمثال لـ Bitroot، فإن تحديد مكان طبقة التخزين بدقة هو أنها قاعدة توزيع قيمة داخل AI Stack. من جهة، يوفر Bitroot بيئة تنفيذ على السلسلة عالية الأداء عبر التوازي في EVM وPipeline BFT. ومن جهة أخرى، عبر التدريب والتعلم/الاستدلال الموزع وشبكات التنفيذ الموثوق وإدارة أصول AI، يقوم ربط البيانات والنماذج والقدرة الحاسوبية وتطبيقات Agent في شبكة قابلة للتسوية. في هذه الشبكة، لا يعتبر التخزين وحدة معزولة، بل هو البنية التحتية التي تحدد ما إذا كانت البيانات يمكن تثبيت حقوقها (إثبات الملكية/الحق)، وما إذا كان يمكن إعادة إنتاج النموذج، وما إذا كانت القدرة الحاسوبية قابلة للتسوية، وما إذا كان بإمكان المساهمين الاستمرار في الحصول على الأرباح.
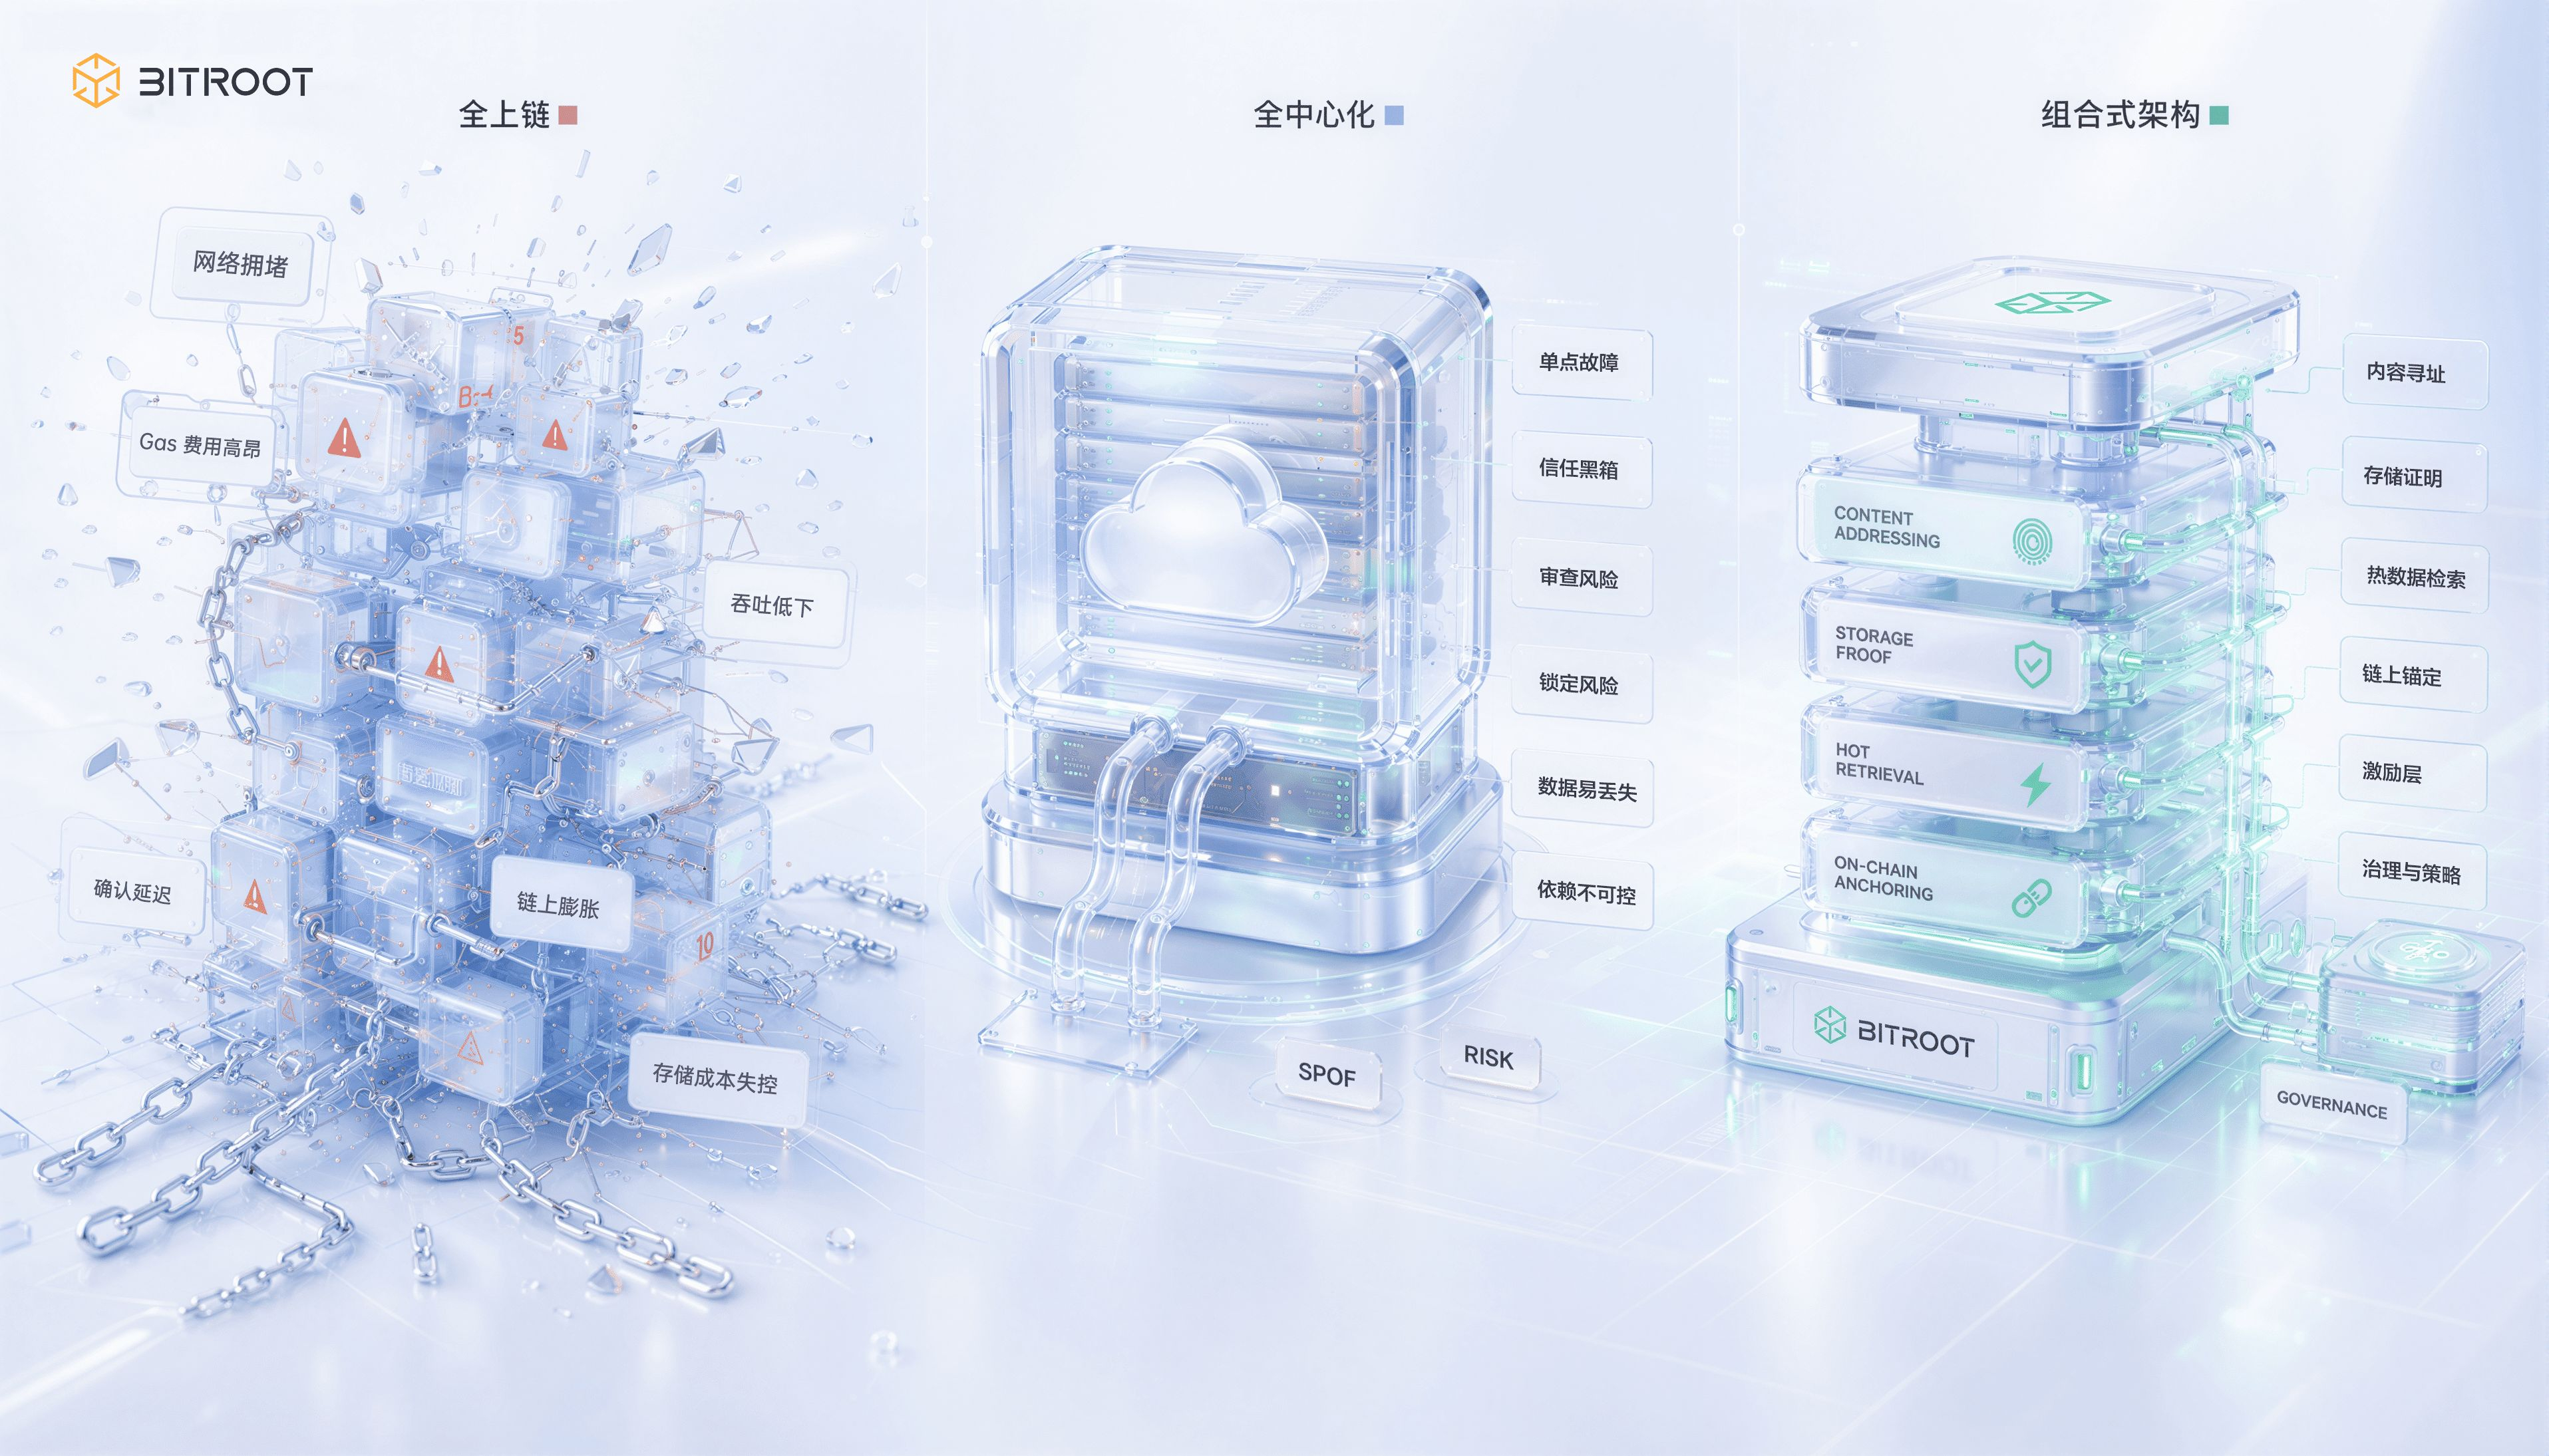
التشغيل كامل السلسلة والكامل اللامركزي في مركزية واحدة، وفي سيناريوهات AI لم يعد ذلك قابلاً للمضي. خلال السنوات الماضية، غالبًا ما تم تبسيط مشاكل التخزين إلى خيارين: إما “كلها على السلسلة” أو “كلها مركزية”. لكن هذين المسارين غير قابلين للاستمرار في سيناريوهات AI.
ضغط “كلها على السلسلة” ملموس جدًا. بيانات التدريب وأوزان النماذج وسجلات الاستدلال وفهارس المتجهات هي عادةً عالية الحجم وعالية التحديث. حتى لو بدأت بتقسيمها ثم رفعها على السلسلة، فستصطدم بنفس الوقت بسقف الإنتاجية ومنحنى التكاليف. يمكن للمركزية أن تعمل بسرعة، لكن قابلية التحقق والتتبع وسيادة البيانات وتعتمد على أساس ثقة هش، وعندما يتعلق الأمر بتقسيم الأرباح متعددة الأطراف وتثبيت الحقوق (إثبات الملكية/الحق) يصبح ذلك غير ثابت.
والأهم أن التغيير هو أن الذكاء الاصطناعي حوّل التخزين من بند تكلفة إلى عنصر إنتاج. من يدير إصدارات البيانات يحدد على من تقع المبادرة في تكرارات النموذج. وهل يمكن إثبات توفر البيانات يؤثر مباشرة على أولوية توزيع القدرة والتسوية. أما القدرة على تحويل البيانات إلى أصول، فتتعلق بما إذا كان بإمكان فريق بناء حوافز طويلة الأجل داخل النظام البيئي. عند هذه المرحلة، لم يعد التخزين مجرد نظام خدمات خلفية، بل أصبح نظام توزيع قيمة.
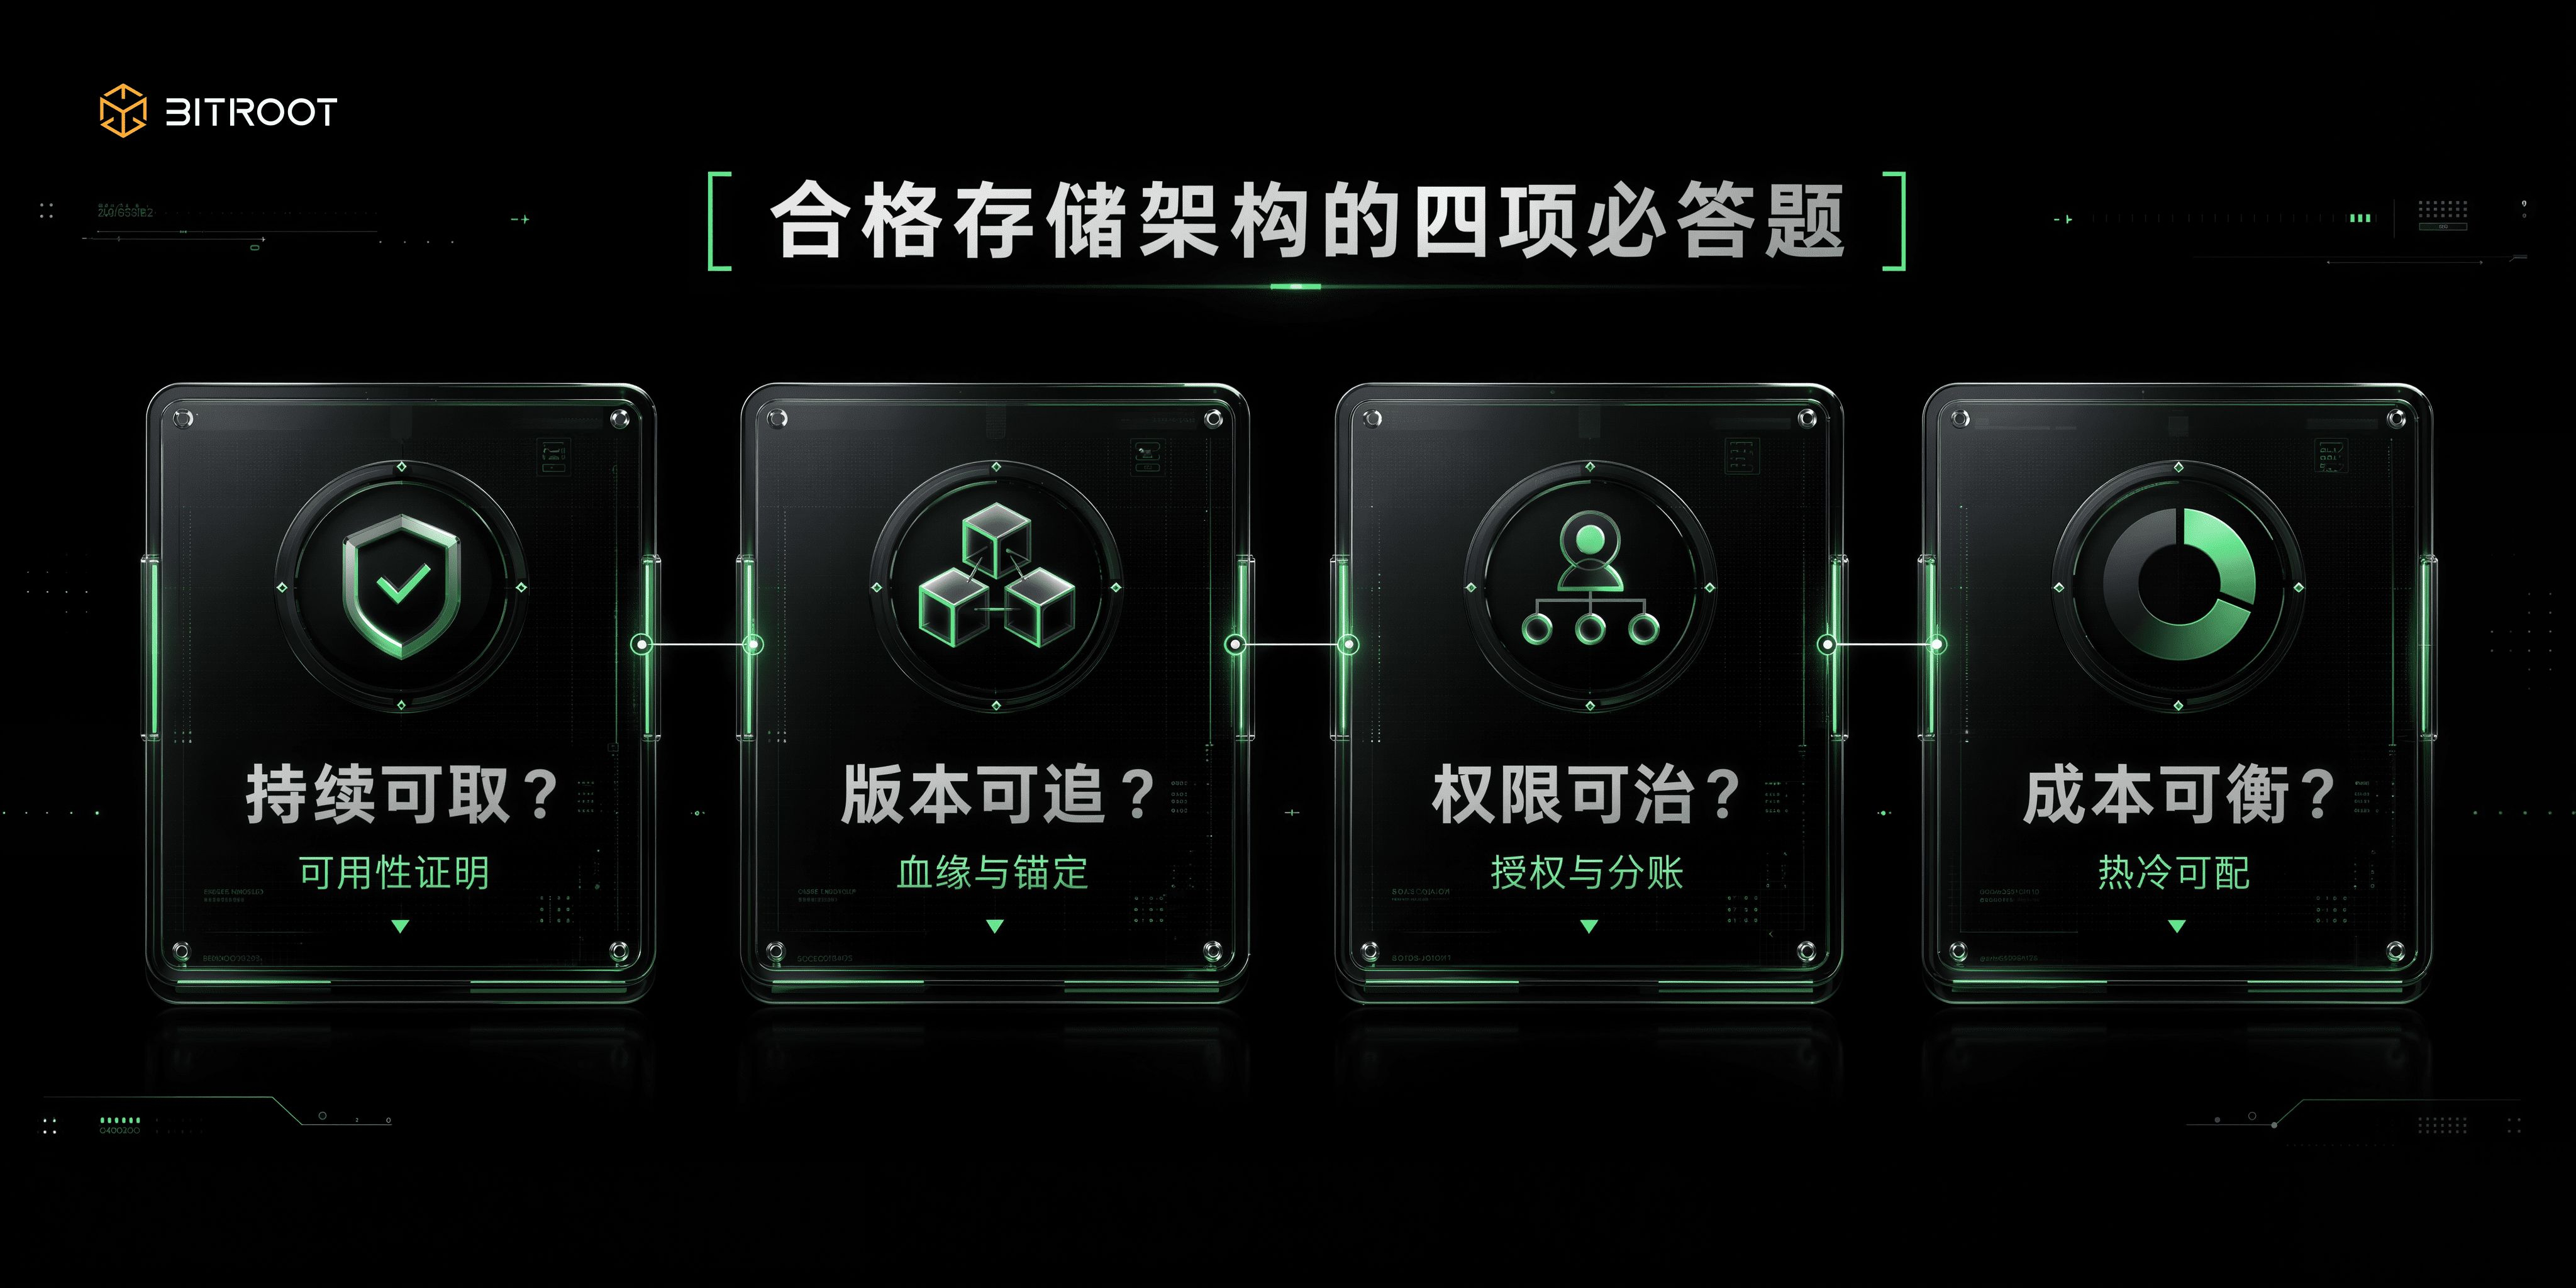
لذا يجب على أي بنية تخزين مؤهلة أن تجيب في الوقت نفسه عن أربع مسائل: هل البيانات موجودة حقًا وقابلة للاستخدام المستمر؟ هل علاقة إصدارات البيانات بالنماذج قابلة للتتبع؟ هل الصلاحيات والأرباح قابلة للحوكمة؟ وهل يمكن للنظام تحقيق توازن طويل الأمد بين التكلفة والأداء؟
نقطة دخول Bitroot: تحويل بيانات الذكاء الاصطناعي من “قابلة للتخزين” إلى “قابلة للتسوية”
هذا بالضبط هو الموضع الذي يحتاج Bitroot إلى ملئه. باعتباره سلسلة عامة Parallel EVM عالية الأداء للسيناريوهات المتعلقة بالذكاء الاصطناعي، لا ينبغي أن تتوقف قصة تخزين Bitroot عند “مكان تخزين البيانات”، بل يجب أن تجيب “كيف تُثبت البيانات؟ وكيف تُستدعى؟ وكيف تشارك في توزيع الأرباح؟”. يمكن ترك كوربُس التدريب وأوزان النماذج وفهارس المتجهات وسجلات الاستدلال في طبقة تخزين موزع أكثر ملاءمة للكائنات الكبيرة، لكن التزامات هاشها وعلاقات الإصدارات واستراتيجيات الصلاحيات وسجلات الاستدعاء وأحداث الأرباح يجب أن تتشكل كأدلة موحدة على السلسلة داخل Bitroot.
ومن هذا المنظور، فإن الأداء العالي والتأخير المنخفض لـ Bitroot ليس مجرد خدمة معاملات DeFi، بل خدمة لأحداث حوكمة أدق وأكثر تكرارًا داخل AI Stack: يجب تثبيت تحديثات مجموعة البيانات، وتسجيل إصدارات النموذج، وتسوية استدعاءات AI Agent، وتحكيم جدالات نتائج الاسترجاع، وإخضاع توفر عقد التخزين للتحدي المستمر والمكافأة. لا لن تنكسر أصول بيانات AI داخل قواعد بيانات مركزية، ولا لتصبح “صندوقًا أسود خارج السلسلة” بلا محاسبة—فقط إذا استطاعت السلسلة الأساسية حمل هذه الأحداث.
ثلاثة أنماط رئيسية، ولا يوجد واحد منها يمكنه اختراق كل السيناريوهات وحده. المنافسة في التخزين الموزع لم تكن يومًا “من هو الأكثر تقدمًا”، بل “من هو الأنسب داخل بنية بياناتك”.
شبكة العنونة بالمحتوى تحل سؤال: هل هذه هي تلك البيانات؟ وليس من يضمن أنها متاحة على الإنترنت. وفق وثائق IPFS الرسمية، يُعرَّف CID كمُعرّف مبني على تجزئة المحتوى (content hash)، ولا يعتمد على العنونة بالموقع. المحتوى نفسه يولد نفس CID ضمن نفس إعدادات الترميز/فك الترميز. إذا تغيّر بايت واحد من المحتوى، يتغير CID تبعًا لذلك. هذا يجعلها مناسبة طبيعيًا للتحقق من السلامة وإزالة التكرار والإحالات بين الأنظمة، أي كقدرة أساسية لتثبيت حقوق/هوية البيانات. لكن العنونة بالمحتوى ليست مرادفًا لتوفر اقتصادي طويل الأمد؛ CID يجيب عن سؤال الهوية فقط ولا يجيب من يضمن أنها ستبقى متصلة. وأول فخ تقع فيه الفرق بعد الإطلاق غالبًا هنا: حصلت تقنيًا على CID لكنها لم تحصل تجاريًا على التزام التوفر.
أما شبكة سوق التخزين، فهي تشتري قابلية التوفر على بُعد الزمن بآليات اقتصادية. وفق وثائق Filecoin، تنشئ الشبكة آلية التزام تخزين مع استمرار إثباته عبر Proof-of-Replication وProof-of-Spacetime. PoRep في التغليف الابتدائي يثبت أن النسخة الفريدة موجودة فعلاً، وPoSt في الدورات اللاحقة يثبت أنها ما زالت موجودة. نافذة WindowPoSt تكون عادةً منظمة على 24 ساعة، ثم تنقسم إلى عدة نوافذ إثبات مدتها 30 دقيقة. إذا لم يقدم مزود التخزين إثباتًا فعّالًا داخل النافذة، فسيتم تفعيل خصم من الضمانات (slashing/penalty) وانخفاض في سعة التخزين. في هذا النظام، القابلية للاستخدام هي عنصر تقييم مستمر وليست التزامًا لمرة واحدة بعد التوقيع. هذا النوع من العقود والقابل للتدقيق مناسب للأرشيف المتوسط إلى الطويل والنسخ الاحتياطية وأسواق البيانات، لكنه أشبه بمستودع طويل الأمد مع إثبات، وليس خدمة على الإنترنت منخفضة التأخير بشكل طبيعي. إذا دفعت الاستعلامات عالية التواتر مباشرة إلى هذا النوع، فقد تسوء التجربة بسبب تأخير ذيل (tail latency).
شبكة التخزين الدائم تسلك طريقًا مختلفًا: دفع مرة واحدة مقابل تاريخ غير قابل للتغيير. وفق بروتوكول Arweave والوثائق ذات الغلاف الأصفر، جزء من تكلفة الرفع يدخل إلى صندوق الهبات endowment لتغطية الحوافز طويلة الأجل للتخزين، أي تقديم الاستدامة طويلة الأمد إلى نموذج التسعير بدل الاعتماد على عادة التجديد لاحقًا. وهي مناسبة للأرشيف التاريخي والسجلات الرئيسية ووثائق حقوق النشر من نوع “غير قابل للتغيير”. لكن نقاط الضعف واضحة أيضًا: “التدويم” لا يساوي تلقائيًا توفرًا عالي التوازي ومنخفض التأخير؛ في الممارسة يجب تراكب ذاكرة كاش أو بوابات أو طبقة فهرس قريبة (nearline) لتلبية تجربة الاستخدام اللحظية للمستخدم.
بالإضافة إلى هذه الأنماط الثلاثة الأساسية، توجد في الهندسة مجموعتان شائعتان يجب وزنها. الأولى هي مزيج من طبقة توفر البيانات مع تخزين الكائنات: نشر البيانات وإثباتات التوفر تصبح أكثر معيارية، لكن ثمن ذلك هو تعقيد التنسيق عبر الطبقات وتكلفة حوكمة الواجهات. الثانية هي تعاون متعدد السحب مع الحافة (multi-cloud + edge): يوفر تأخيرًا منخفضًا وتعافيًا أفضل من الكوارث، لكنه أصعب في الإغلاق من ناحية حوكمة التكلفة وإدارة الاتساق.
مهما اخترنا، لا يمكن هندسيًا أن يتغذى بروتوكول واحد على كل السيناريوهات. الطريقة الفعّالة هي دمجها حسب نوع البيانات: افصل بين المتانة، وزمن التأخير في الاسترجاع، والامتثال—ثم اربط كل منها بطبقة قدرات مناسبة، واستخدم طبقة التثبيت على السلسلة وطبقة الحوكمة لتنسيقها موحدًا.
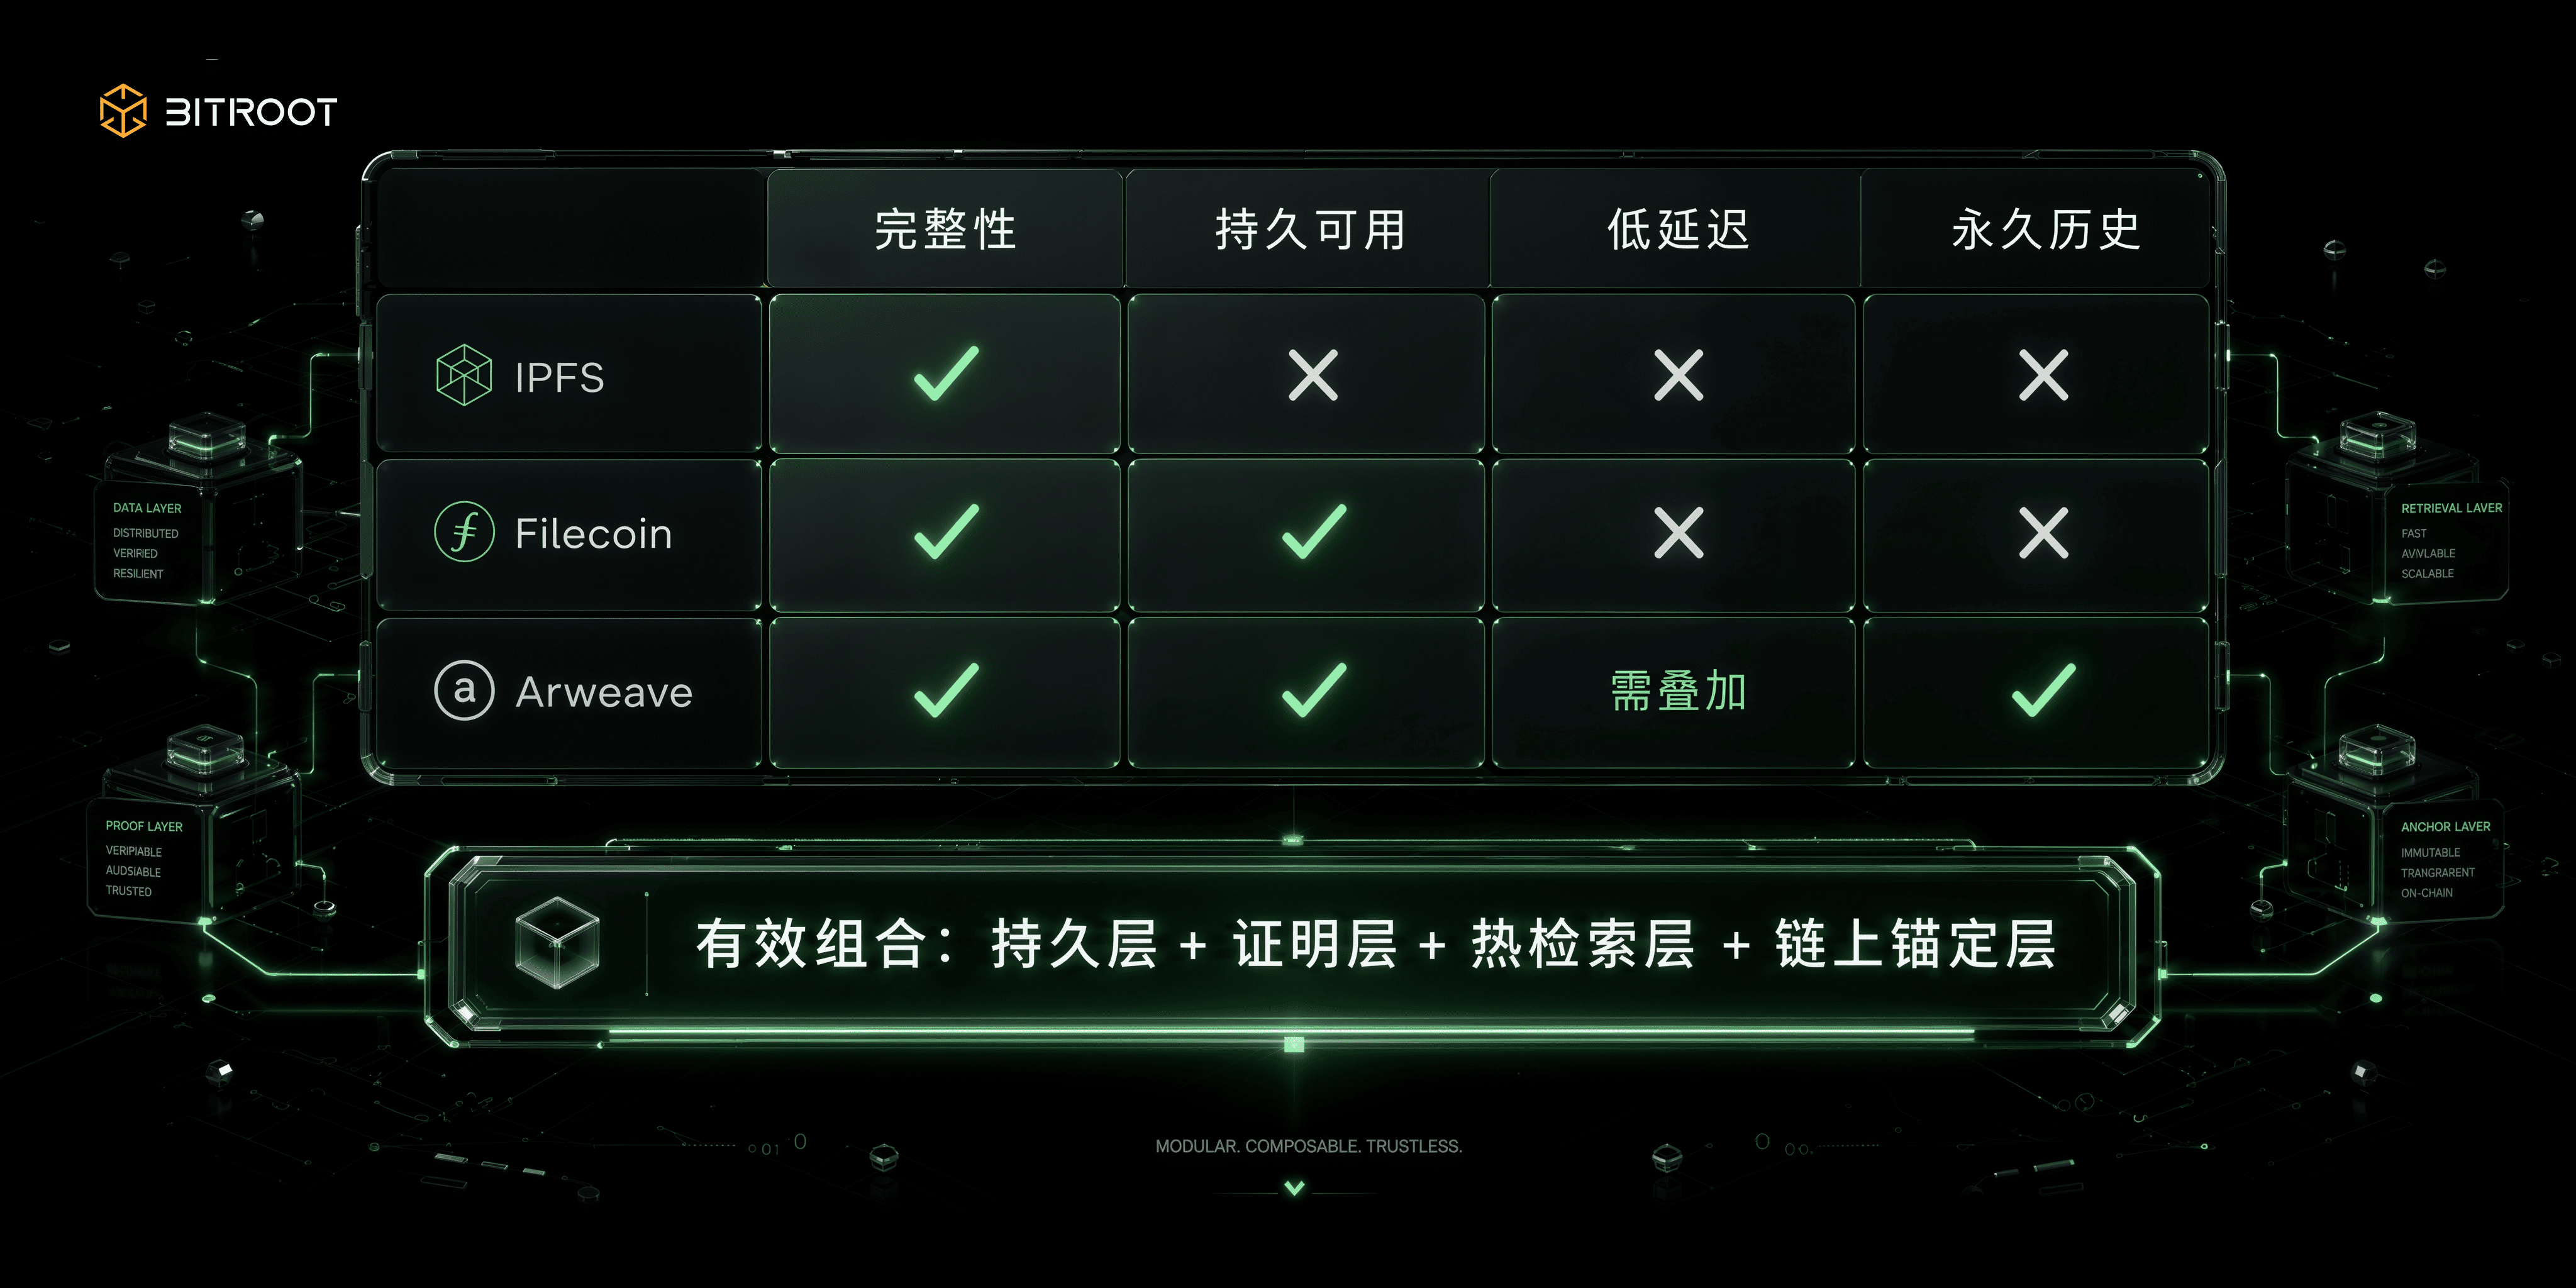
مساحة الاختيار لدى Bitroot يجب أن تُبنى أيضًا على منطق التركيب هذا: ليس المقصود استبدال IPFS أو Filecoin أو Arweave أو تخزين الكائنات ببعضها البعض، بل وضع كل منها في طبقة مسؤولية مختلفة. يُستخدم العنونة بالمحتوى لهوية البيانات وسلامتها، وتُستخدم إثباتات التخزين للدوام/التوفر طويل الأجل، والطبقة الدائمة للتاريخ الحاسم والأدلة/الوثائق، وطبقة الفهرس الساخن للاسترجاع وتجربة تطبيقات AI، بينما طبقة Bitroot على السلسلة توحد حمل تثبيت الإصدارات، واستراتيجيات الصلاحيات، وتسوية الاستدعاءات ومعالجة النزاعات. بعبارة أخرى، لا يحتاج Bitroot أن يكون مستودعًا فيزيائيًا لكل البيانات، بل يجب أن يصبح “دفترًا موثوقًا” لتدفق قيمة بيانات AI.
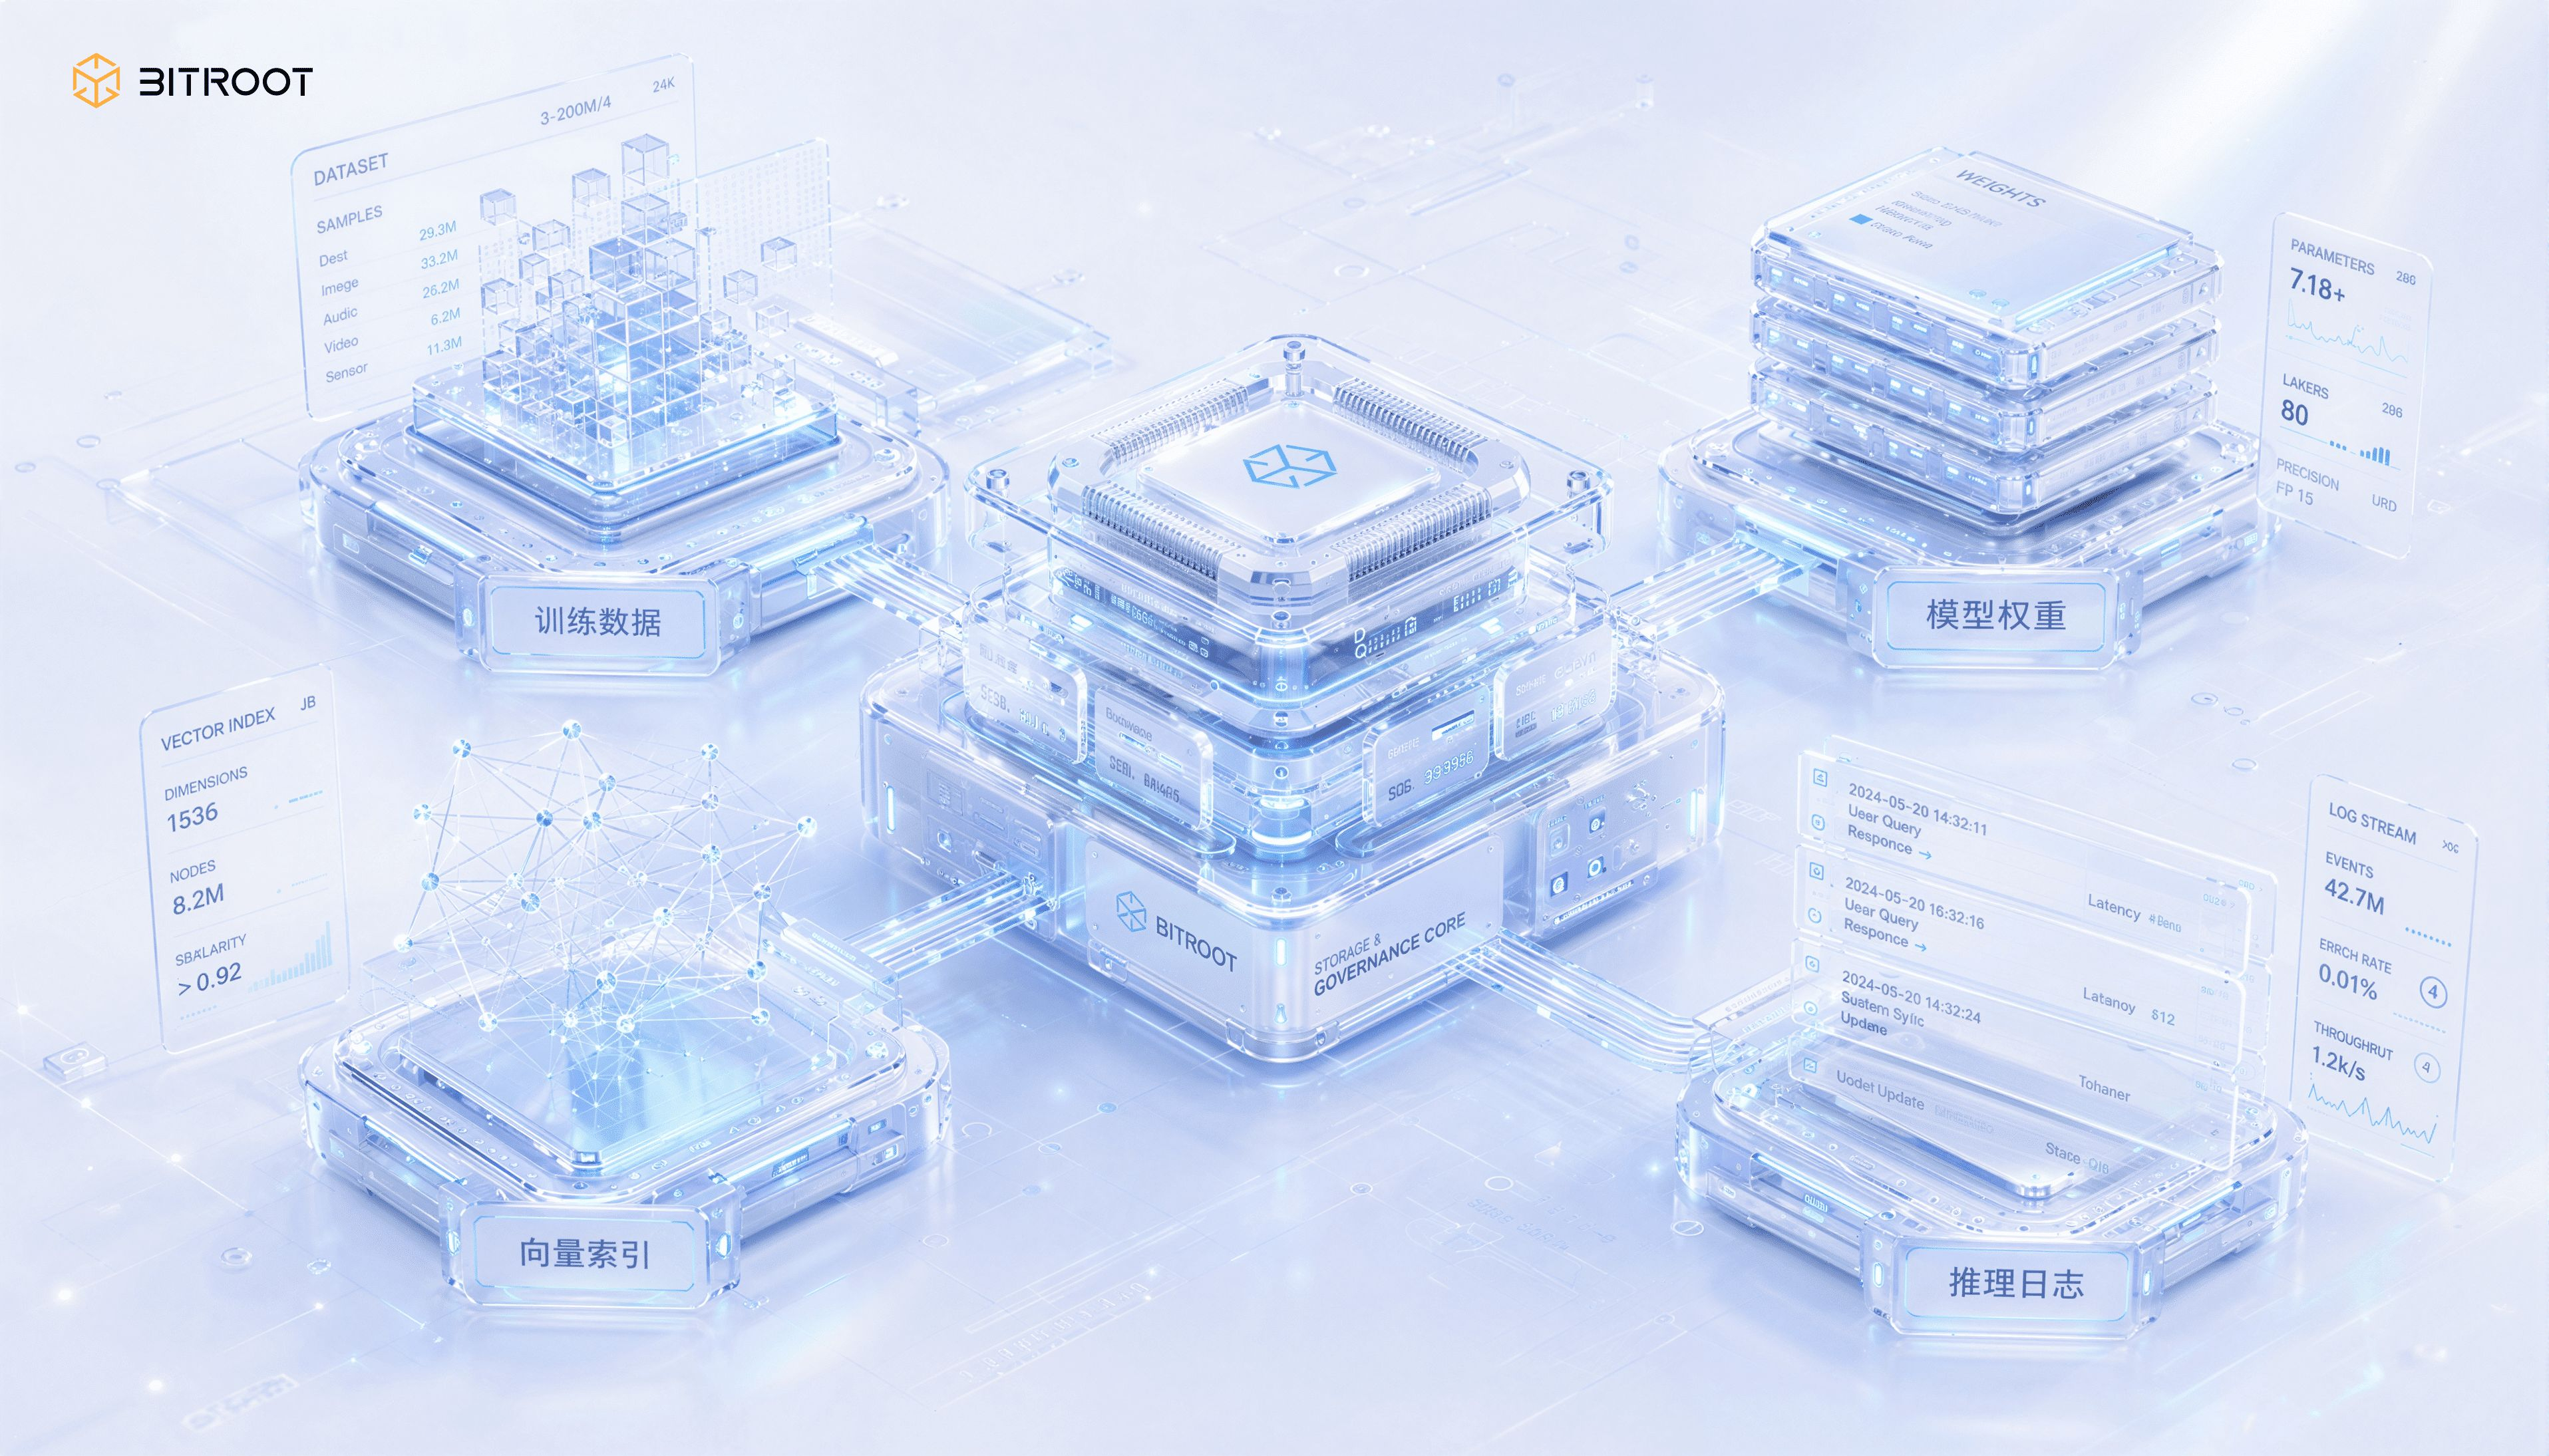
صعوبة تخزين AI ليست في حفظ الملفات، بل في إدارة سلسلة الإنتاج. في سيناريوهات AI، فإن كائنات التخزين على الأقل أربعة أنواع: بيانات التدريب، أوزان النماذج، فهارس المتجهات، وسجلات الاستدلال. تختلف دورة حياة كل نوع، وأنماط الوصول، وكثافة القيمة تمامًا. التحكم باستراتيجية واحدة لفترة قصيرة يوفر الوقت، لكن على المدى الطويل سيؤدي حتمًا إلى فقدان السيطرة على الحوكمة.
مشكلة بيانات التدريب ليست في السعة، بل في انحراف الإصدارات (version drift). كثير من الفرق تُساوي مشكلة بيانات التدريب بتكلفة تخزين على مستوى TB، لكن الأكثر تعقيدًا هو الانحراف: بمجرد تغيير قواعد التنظيف أو عتبة اختيار العينات أو صياغة الترميز، يتغير سلوك النموذج تلقائيًا. وبدون ربط بيانات الإصدار مع إصدار النموذج، يصبح التقييم دون اتصال (offline) صعبًا للتحقق/إعادة الاختبار. وبحسب ممارسات تتبع النماذج والبيانات في MLflow، فإن ربط تشغيل التدريب مع إصدارات البيانات هو شرط لإعادة إظهار التجربة. هذا المبدأ يبقى صحيحًا عند تطبيقه على السلسلة: لا يلزم رفع كل البيانات الأصلية على السلسلة، لكن يجب عمل التزام بالإصدارات والملخصات الرئيسية وبصمات المصدر على السلسلة. على الأقل اربط ثلاثة مُعرّفات في الهندسة: إصدار البيانات، تشغيل التدريب، وإصدار النموذج؛ إن غاب أحدها ستتحول عملية تتبع مشاكل الإنتاج من “فحص الأدلة” إلى مجرد “تخمين الأسباب”.
مشكلة أوزان النموذج ليست عادةً في إمكانية التنزيل أو لا، بل في من يدير حدود الاستدعاء. عندما يدخل نموذج مرحلة الإنتاج، عادة يمر بحالات مثل الإصدار الرمادي (gray), والاستخدام الأساسي (main use), والرجوع للخلف (rollback)، والإحالة للتقاعد (retirement). بدون نظام تسجيل وتفويض مُعياري، تصبح الاستدعاءات عبر الإنترنت صندوقًا أسود غير قابل للتدقيق. مركز تسجيل نماذج ناضج يسجل في آن واحد lineage/bloodline (سلسلة النسب)، وأسماء/aliases للإصدارات، وقيود التوقيع، وعلامات التدقيق. بالنسبة إلى نظام على السلسلة، لا ينبغي أن يكون إصدار النموذج مجرد تجزئة ملف، بل يجب ربطه باستراتيجية الصلاحيات وتوزيع الأرباح وحدود المسؤولية.
تتركز صعوبة فهرس المتجهات في مكان واحد: الاتساق بعد تقسيم الطبقات إلى ساخن وبارد. يوجد تناقض جوهري في الاسترجاع المتجهي: التأخير المنخفض والتكلفة المنخفضة يتنازعان؛ الطبقة الساخنة تعتمد على الذاكرة أو فهارس عالية الأداء لضمان الاستجابة المباشرة، بينما الطبقة الباردة تعتمد على تخزين الكائنات لتطويق التكلفة على المدى الطويل. بدون ميتاداتا موحدة واستراتيجيات مزامنة، ستتفرع الطبقتان بسرعة وتظهر مشكلة أن الاستعلام نفسه يُرجع دلالات مختلفة على عقد مختلفة. لذلك يجب أن يدعم نظام المتجهات أمرين: أن يكون بناء الفهرس قابلاً للتتبع، وأن يمكن مطابقة إصدار فهرس الطبقة الساخنة مع البيانات الرئيسية للطبقة الباردة. وهذا بالضبط ما ستحلّه “الاستجابة القابلة للتحقق” لاحقًا.
يجب أن تجعل سجلات الاستدلال الخصوصية والتدقيق والامتثال تعمل معًا في آن واحد، وهذا أمر صعب. فهي من جهة مادة تدقيق أمنية، ومن جهة أخرى مصدر خطر للخصوصية: حفظ النص الصريح الكامل يخلق مخاطر امتثال، وعدم حفظه تمامًا يفقد قدرة إعادة بناء حادثة (incident) واسترجاع ما حدث. الحل الممكن هو تراكب ثلاث طبقات: بعد إزالة الحساسية يتم التخزين، ويُثبت التزام التجزئة (hash commitment) على السلسلة، ويحتاج الوصول إلى تصريح تدقيق. يتحقق التقسيم إلى “غير قابل للتلاعب” و“قابل للإلغاء في الوصول” على نحو طبقي.
في AI Stack الخاص بـ Bitroot، يمكن أن تقابل هذه الأنواع الأربعة من الكائنات أربع حركات حوكمة: بيانات التدريب تُثبت بالإصدار ويتم تسجيل مصدرها، أوزان النموذج تُسجَّل كأصول ويتم تفويض الاستدعاء، فهارس المتجهات تُقسّم ساخن/بارد وتُثبت الاتساق، وسجلات الاستدلال تُخزن مع إزالة الحساسية والتزام تدقيق. لا يلزم رفعها جميعًا إلى السلسلة بنفس الطريقة، لكن يجب أن يكون لها معرف أصول موحد (asset ID)، وخط نسب للإصدارات (version lineage)، وأحداث استدعاء على Bitroot. عندها فقط يمكن أن تتشكل حلقة تجارية قابلة لإعادة الاستخدام بين أصول البيانات وأصول النماذج وتطبيقات Agent.
قابل للتحقق هو الحد الأدنى، وإثبات قابلية الاستخدام هو الفاصل. إن التزام التخزين دون إثبات قابلية الاستخدام يعادل عمليًا عدم الالتزام في بيئة الإنتاج. لكي يدخل التخزين الموزع إلى الإنتاج، يجب أن يمر على الأقل بثلاثة مراحل: سلامة قابلة للإثبات، وتوفر قابل للإثبات، وسلوك قابل للتدقيق. وعندما تدخل في سيناريو استرجاع AI، يلزم إضافة أصعب خطوة: الاسترجاع قابل للإثبات.
قابلية إثبات سلامة المحتوى تعتمد على العنونة بالمحتوى (Content Addressing) مع التزام Merkle. العنونة بالمحتوى تضمن ثبات بصمة البيانات، وMerkle الالتزام يضمن تحققًا جزئيًا. المعنى الهندسي هو أنه يمكنك التحقق من مجموعة فرعية من كائن ما عبر إثبات على مستوى الأجزاء، دون الحاجة لقراءة كل شيء في كل مرة. بالنسبة لأوزان النماذج الكبيرة، والأدبيات/الكُوربُس، والبيانات متعددة الوسائط، فإن هذه النقطة تحدد مباشرة تكلفة التحقق.
قابلية الاستخدام القابلة للإثبات تعتمد على آلية التحدي والتحقق بالعينات. تُظهر ممارسات Filecoin أن قابلية الاستخدام ليست “SLA” كلاميًا، بل تحديات دورية مع إثبات على السلسلة. يمكن تجريد هذا إلى ثلاثية معمارية: فحص سلبي، تفقد نشط، وعقوبات على الفشل. يجب أن تستجيب العقد للتحدي ضمن نافذة محددة، وإلا يُفعَّل خصم/عقوبة أو انخفاض في الوزن. تسير فكرة مماثلة خطوة أبعد في طبقة توفر البيانات. وفق تصميم عينات Celestia لإتاحة البيانات، يتم توسيع البيانات من مصفوفة k×k إلى 2k×2k؛ تُبني الثقة عالية الاحتمال عبر عينات عشوائية متعددة وتراكم احتمالي بدون تنزيل كتلة البيانات كاملة. وهذا يقدم إلهامًا قابلاً للنقل لسيناريو AI: مع كائنات ضخمة وطلبات عالية التوازي، ليس من الواقعي التحقق من كل شيء عبر تنزيل كامل—التحقق الإحصائي أكثر واقعية في الأنظمة واسعة النطاق.
قابلية السلوك للتدقيق تعتمد على التثبيت على السلسلة مع الاحتفاظ بسجل الأحداث. أصعب ما في نظام التخزين غالبًا ليس “التخزين”، بل “السلوك”: من رفع ماذا؟ من عدّل الاستراتيجيات؟ من أطلق عملية الترحيل؟ ومتى تم استدعاء نموذج حساس؟ إذا لم تتحول هذه السلوكيات إلى تدفق أحداث موحد، فعند ظهور نزاع سيعود الأمر إلى “كلام بلا دليل”. ما تحتاج إليه طبقة الحوكمة ليس نقل كل التفاصيل إلى السلسلة، بل الاحتفاظ بمجموعة أدلة دنيا وأكيدة وقابلة للتحقق عند وقوع النزاع.
الاسترجاع القابل للتحقق هو خطوة خاصة بعالم AI، وأصعب نقطة فيها تأتي من ثغرة يسهل تجاهلها: إرجاع النتائج لا يعني إرجاع النتائج الصحيحة. يمكن لعقد استرجاع متجهي أن تستخدم فهرسًا قديمًا، وحتى تتجاوز الجيران الأقرب فعلاً، ثم ترجع top-k يبدو منطقيًا، ولكن عندما تنظر فقط إلى قيمة الإرجاع فلن تستطيع تمييز الحقيقة. مخرجات الاسترجاع الدلالي (semantic) لا تحتوي بذاتها ما يبرهن صحتها؛ الأخطاء لا تُبلِّغ “خطأ”، بل تخفض جودة الاستدعاء (recall) وأداء النموذج بشكل صامت. وعندما تُستخدم نتائج الاسترجاع للتسوية أو التفويض أو قرارات على السلسلة، تصبح هذه الفجوة من مشكلة جودة إلى مشكلة ثقة.
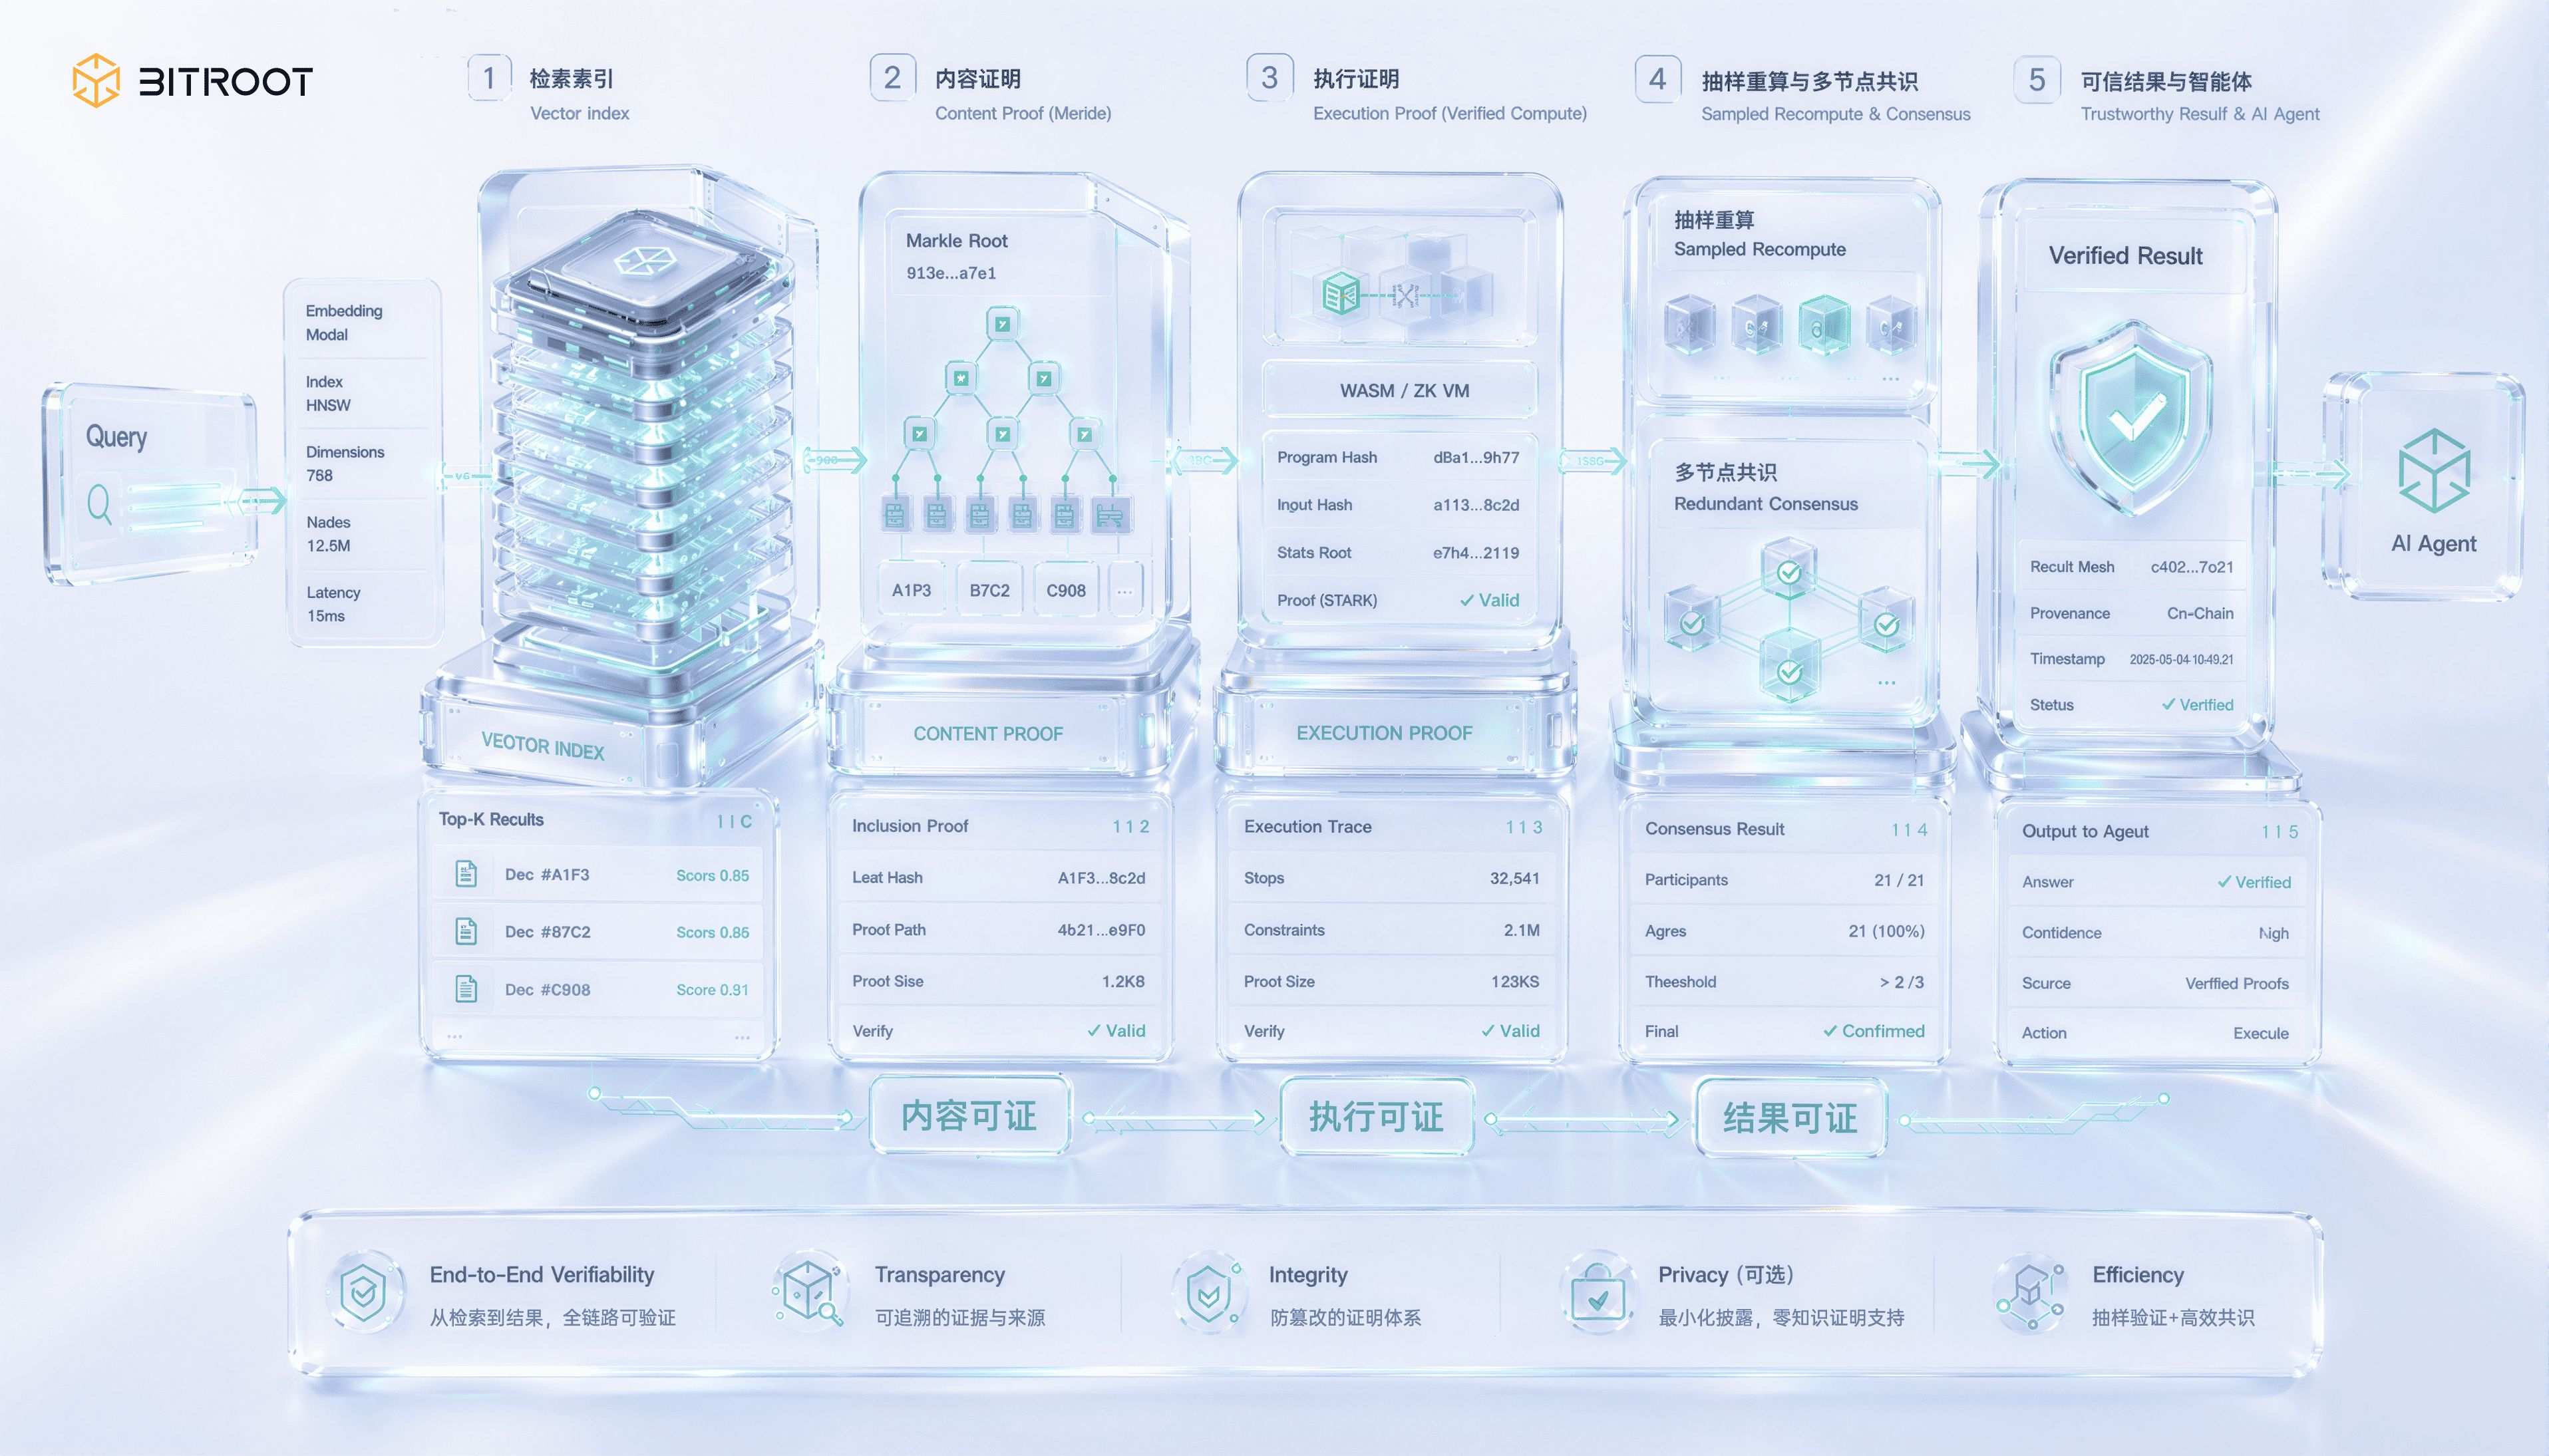
عند تفكيك “قابلية التحقق من الاسترجاع” يمكن تقسيمها إلى ثلاث طبقات تدريجيًا أصعب. الطبقة الأولى هي “محتوى قابل للتحقق”: إثبات أن المتجهات التي تم إرجاعها تنتمي بالفعل إلى نسخة فهرس مُلتزم بها. الطريقة هي بناء بنية بيانات مُصدقَة على الفهرس باستخدام التزامات Merkle: يتم تثبيت جذر الفهرس على السلسلة، وعند إرجاع النتيجة يتم إرفاق دليل تضمين (inclusion proof) لضمان عدم اختلاق العقد للبيانات أو تبديلها. الطبقة الثانية هي “تنفيذ قابل للتحقق”: إثبات أن هذا الاستعلام تم تشغيله فعلاً على النسخة المُلتزم بها، وليس على نسخة من الفهرس تم تعديلها داخليًا. هذا يتطلب إدخال عملية الاستعلام ضمن مجال الحساب القابل للتحقق. الطبقة الثالثة والأصعب هي “نتيجة قابلة للتحقق”: إثبات أن الـ top-k المرتجعة هي فعلاً الأقرب ضمن مقياس محدد، وليست مجرد الأقرب ظاهريًا مع فقد أقرب جار. هذا جوهريًا يتطلب إثبات صحة بحث الأقرب التقريبي (ANN/approximate nearest neighbor).
على مستوى الإنتاج، لتحقيق قابلية إثبات صارمة لنتائج تقريب أقرب جار عالي الأبعاد، ما زال ذلك موضوعًا بحثيًا رائدًا. تتقدم وسائل تشفير مثل الإثباتات الصفرية المعرفة، لكن تكلفة إثبات عمليات المتجهات عالية الأبعاد لم تصل بعد إلى مستوى يسمح باستخدامها على نطاق واسع بشكل مباشر عبر الإنترنت. الحل الهندسي العملي هو وجود تغطية على طبقات بدلًا من حل واحد “من البداية إلى النهاية”: أولًا، التزم بإصدار الفهرس ومعلمات البناء على السلسلة لضمان قابلية التتبع. ثانيًا، أعد الحساب بعينات من الاستعلامات: اختر عينة بنسبة محددة من الاستعلامات على الإنترنت لإعادة التشغيل على نسخة موثوقة ثم قارِن النتائج، واستبدل الإثبات التفصيلي لكل استعلام بثقة إحصائية. ثالثًا، اجعل عدة عقد مستقلة تستدعي/تبحث بشكل متكرر، واجمع الإجماع على النتائج المرتجعة لرفع تكلفة الغش على نقطة واحدة. لا تُرقّي إلى إعادة حساب شاملة واستدلال على السلسلة إلا عند ظهور تباين في المقارنة أو الإجماع. هذا الخط متسق مع فكرة إعطاء الأولوية للتحقق بالعينات في إثبات القابلية للاستخدام: في الأنظمة الكبيرة، غالبًا ما تكون “التحقق الإحصائي + ترقية النزاع” أكثر قابلية للتنفيذ من إثبات صارم لكل عنصر على حدة.
بالنسبة إلى Bitroot، فإن عملية الاستعلام القابل للتحقق ليست مجرد وظيفة تخزين معزولة، بل جزء من التنفيذ الموثوق لوكلاء الذكاء الاصطناعي (AI Agent). إذا اعتمد وكيل على سلاسل (On-chain Agent) على قاعدة معرفة خارجية أو أوزان نموذج أو فهرس متجهات لاتخاذ القرار، فعلى النظام على الأقل أن يتمكن من الإجابة عن ثلاث مسائل: ما هو إصدار البيانات الذي يقرأه؟ ما هو إصدار النموذج الذي يستدعيه؟ وهل ناتج الإرجاع مستمد من إصدار الفهرس المُسجَّل؟ يمكن لـ Bitroot ضغط هذه الأدلة في أحداث قابلة للتحقق على السلسلة، بحيث تتحول سلوكيات الوكيل من مجرد “يبدو ذكيًا” إلى “قابل للتتبع، قابل للاعتراض، وقابل للتسوية”.
المشكلة الحقيقية في اختيار التقنية: ليست اختيار بروتوكول واحد، بل عمل تركيب/توليفة. كثير من مراجعات الخيارات تفشل لأنها تطرح السؤال خطأ. الصياغة الصحيحة ليست “هل نستخدم هذا البروتوكول أم لا؟” بل: ما هي توليفة بياناتنا؟ وما هي المؤشرات الهدف؟ وما هي القيود؟ يُنصح بالتحرك وفق أربعة إجراءات.
ابدأ بعمل جرد لأصول البيانات. على الأقل ميّز بين بيانات الحالة وبيانات الكائنات وبيانات الاسترجاع وبيانات التدقيق. اجعل قالب الجرد حقولًا ثابتة، على الأقل ثمانية: نوع البيانات، الزيادة اليومية، أقصى تزامن/ذروة التزامن، نسبة القراءة/الكتابة، مدة الاحتفاظ، مستوى الامتثال، التأخير المستهدف، وسقف التكلفة. بعد توحيد الحقول ستصبح المناقشات حول الاختيار بين الفرق أسرع بكثير.
عرّف أهداف مستوى الخدمة أيضًا. اكتب حدودًا صلبة لما يلي: تأخير P95/P99، وزمن الاستعادة RTO، ونقطة الاستعادة RPO، أهداف التوفر، وسقف تكلفة كل TB، وإلا فلن يكون لأي نقاش لاحق معيار قياس.
بعد ذلك أنشئ خريطة القدرات: اربط قدرات مثل التخزين الدائم، وإثبات التوفر الدوري، والاسترجاع منخفض التأخير، وحوكمة الوصول، بكل منها إلى طبقات تقنية مختلفة بدلًا من الأمل في أن طبقة واحدة تغطي الجميع.
أخيرًا تحديد عتبة الترحيل. ما البيانات المسموح بمرورها في فترة الانتقال عبر الاستضافة المركزية؟ وما المؤشرات التي تُشغِّل الترحيل؟ ومتى يجب إكمال الاستبدال باللامركزية؟ ممارسة عملية: تعيين عتبتين مسبقًا. مثال: عندما يتجاوز متوسط تكلفة 1 TB الميزانية بشكل مستمر لدورتين إحصائيتين، أو عندما يتجاوز تأخير P95 هدفه لمدة أسبوعين متتاليين، يتم تلقائيًا تشغيل مراجعة ترحيل البنية. بدون عتبات لا توجد حوكمة، وستتحول فترة الانتقال إلى حالة دائمة.
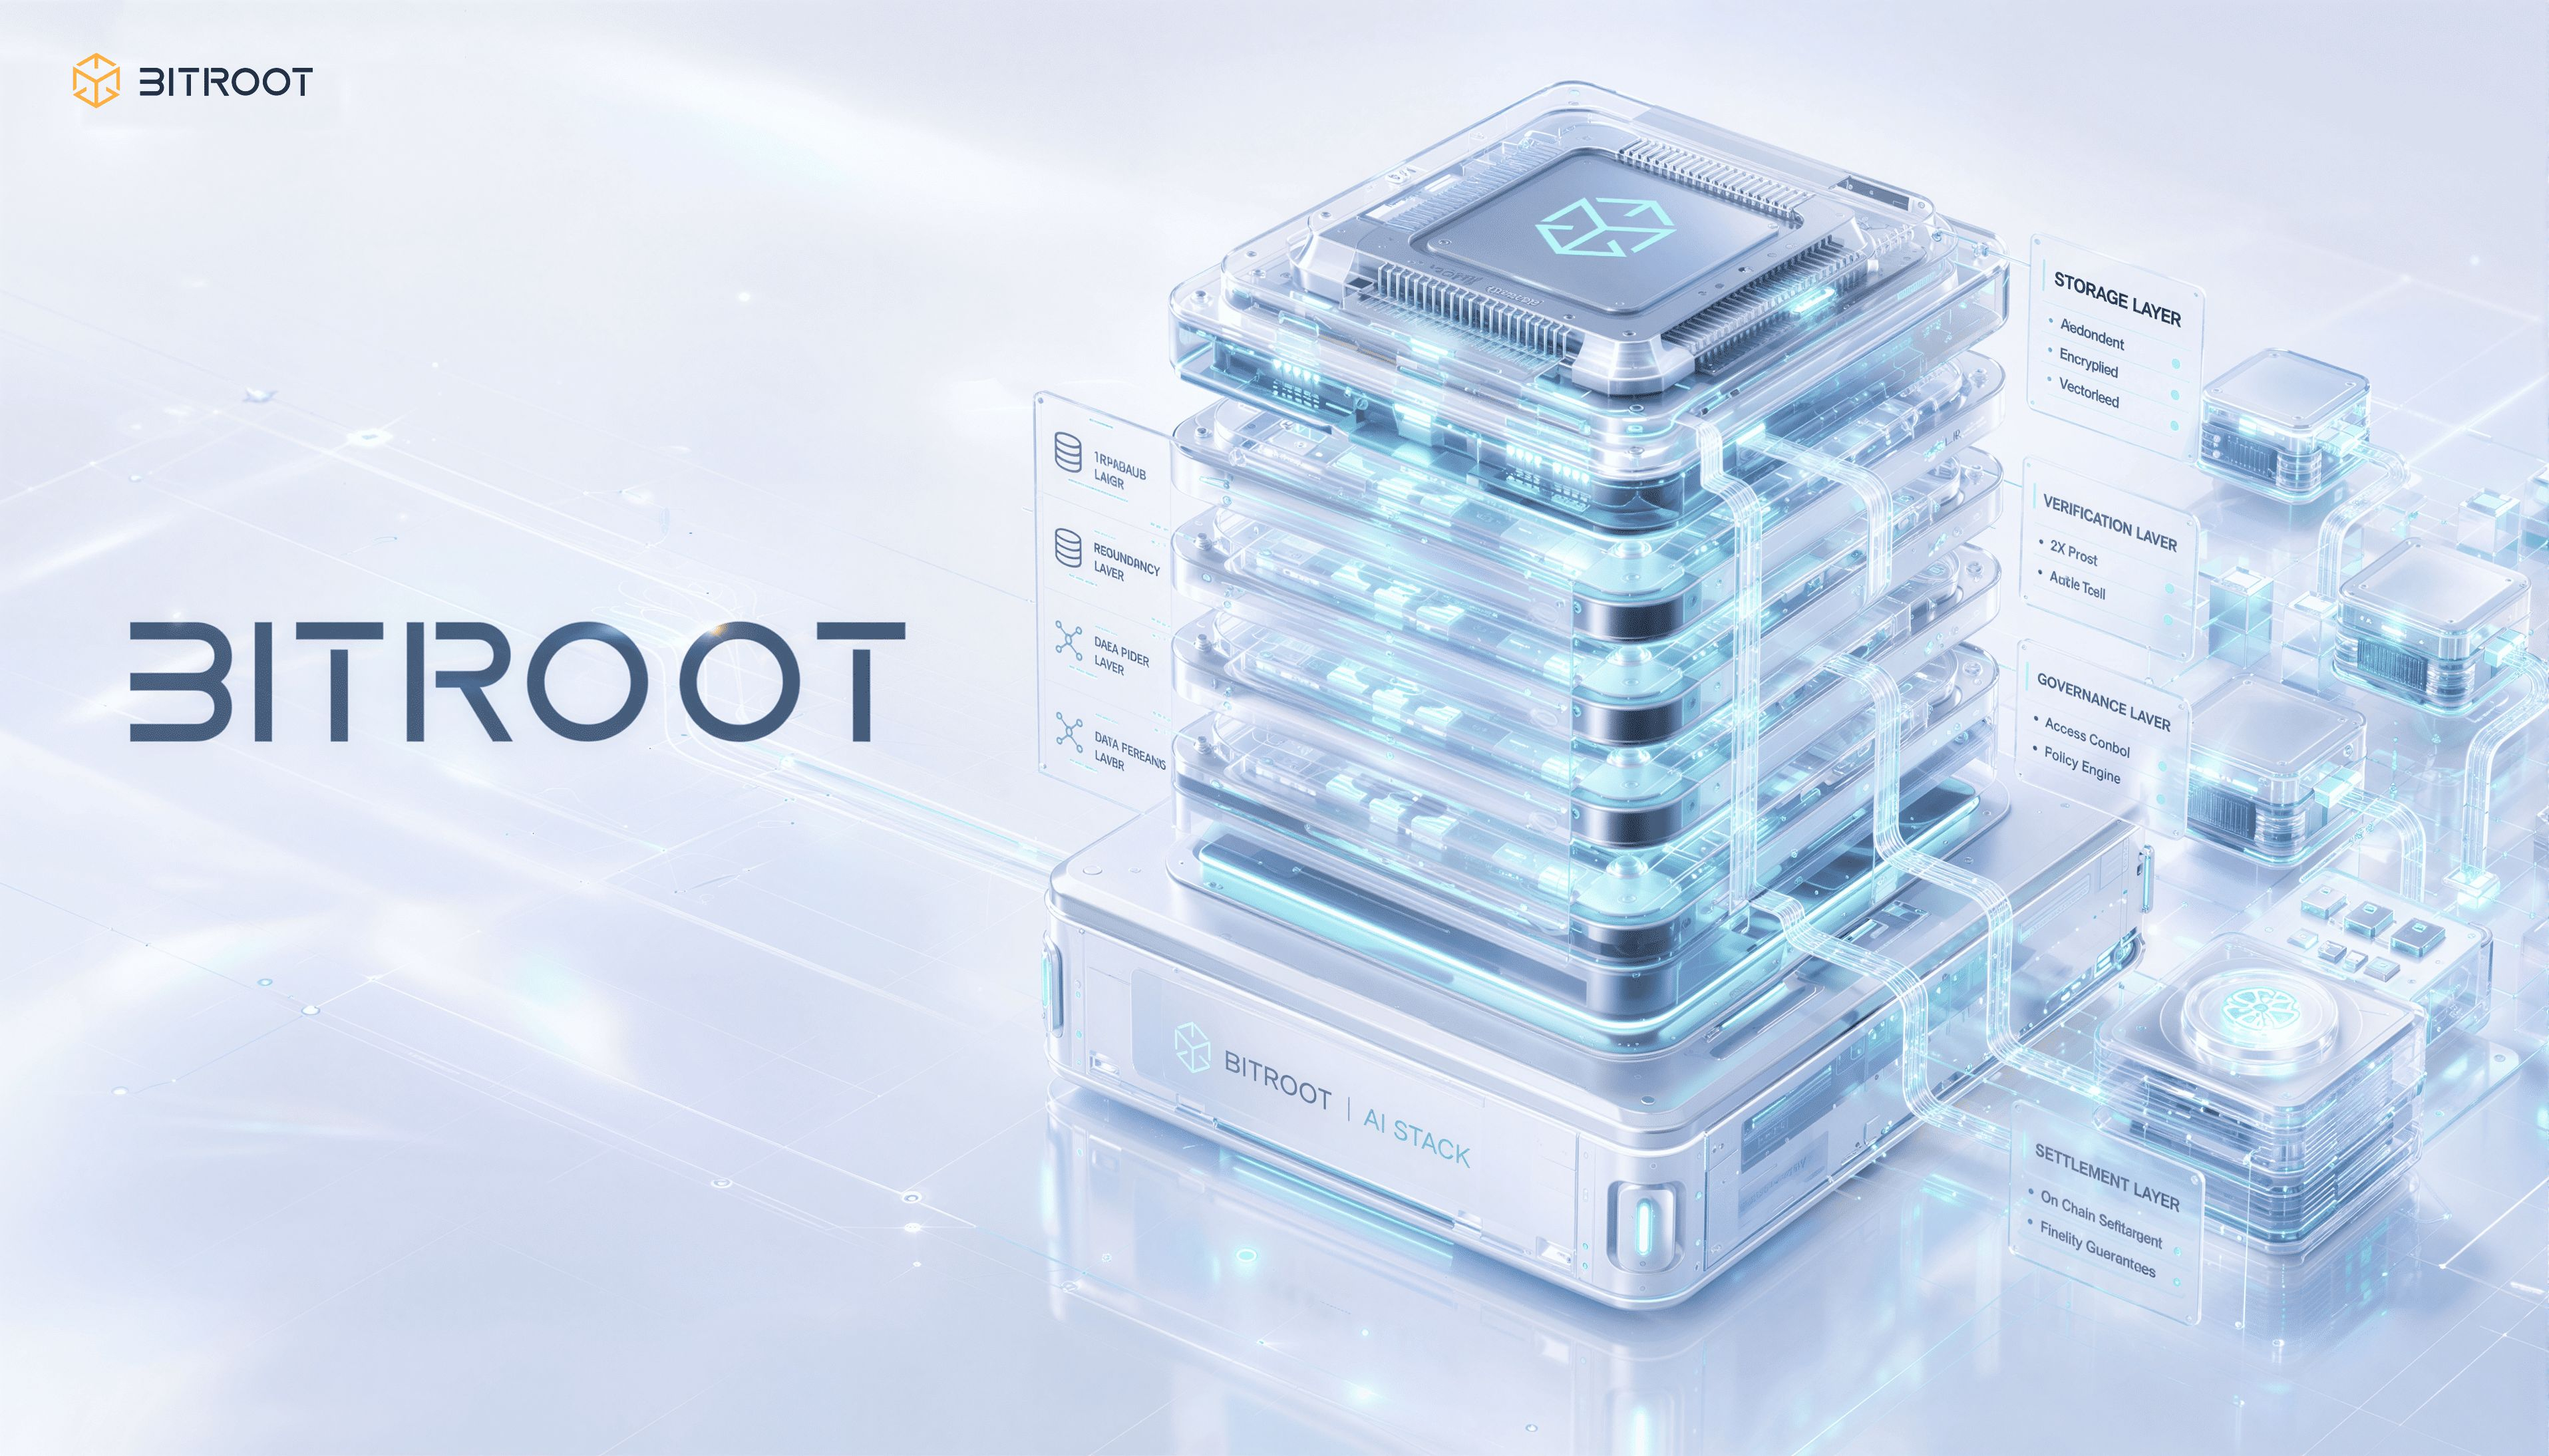
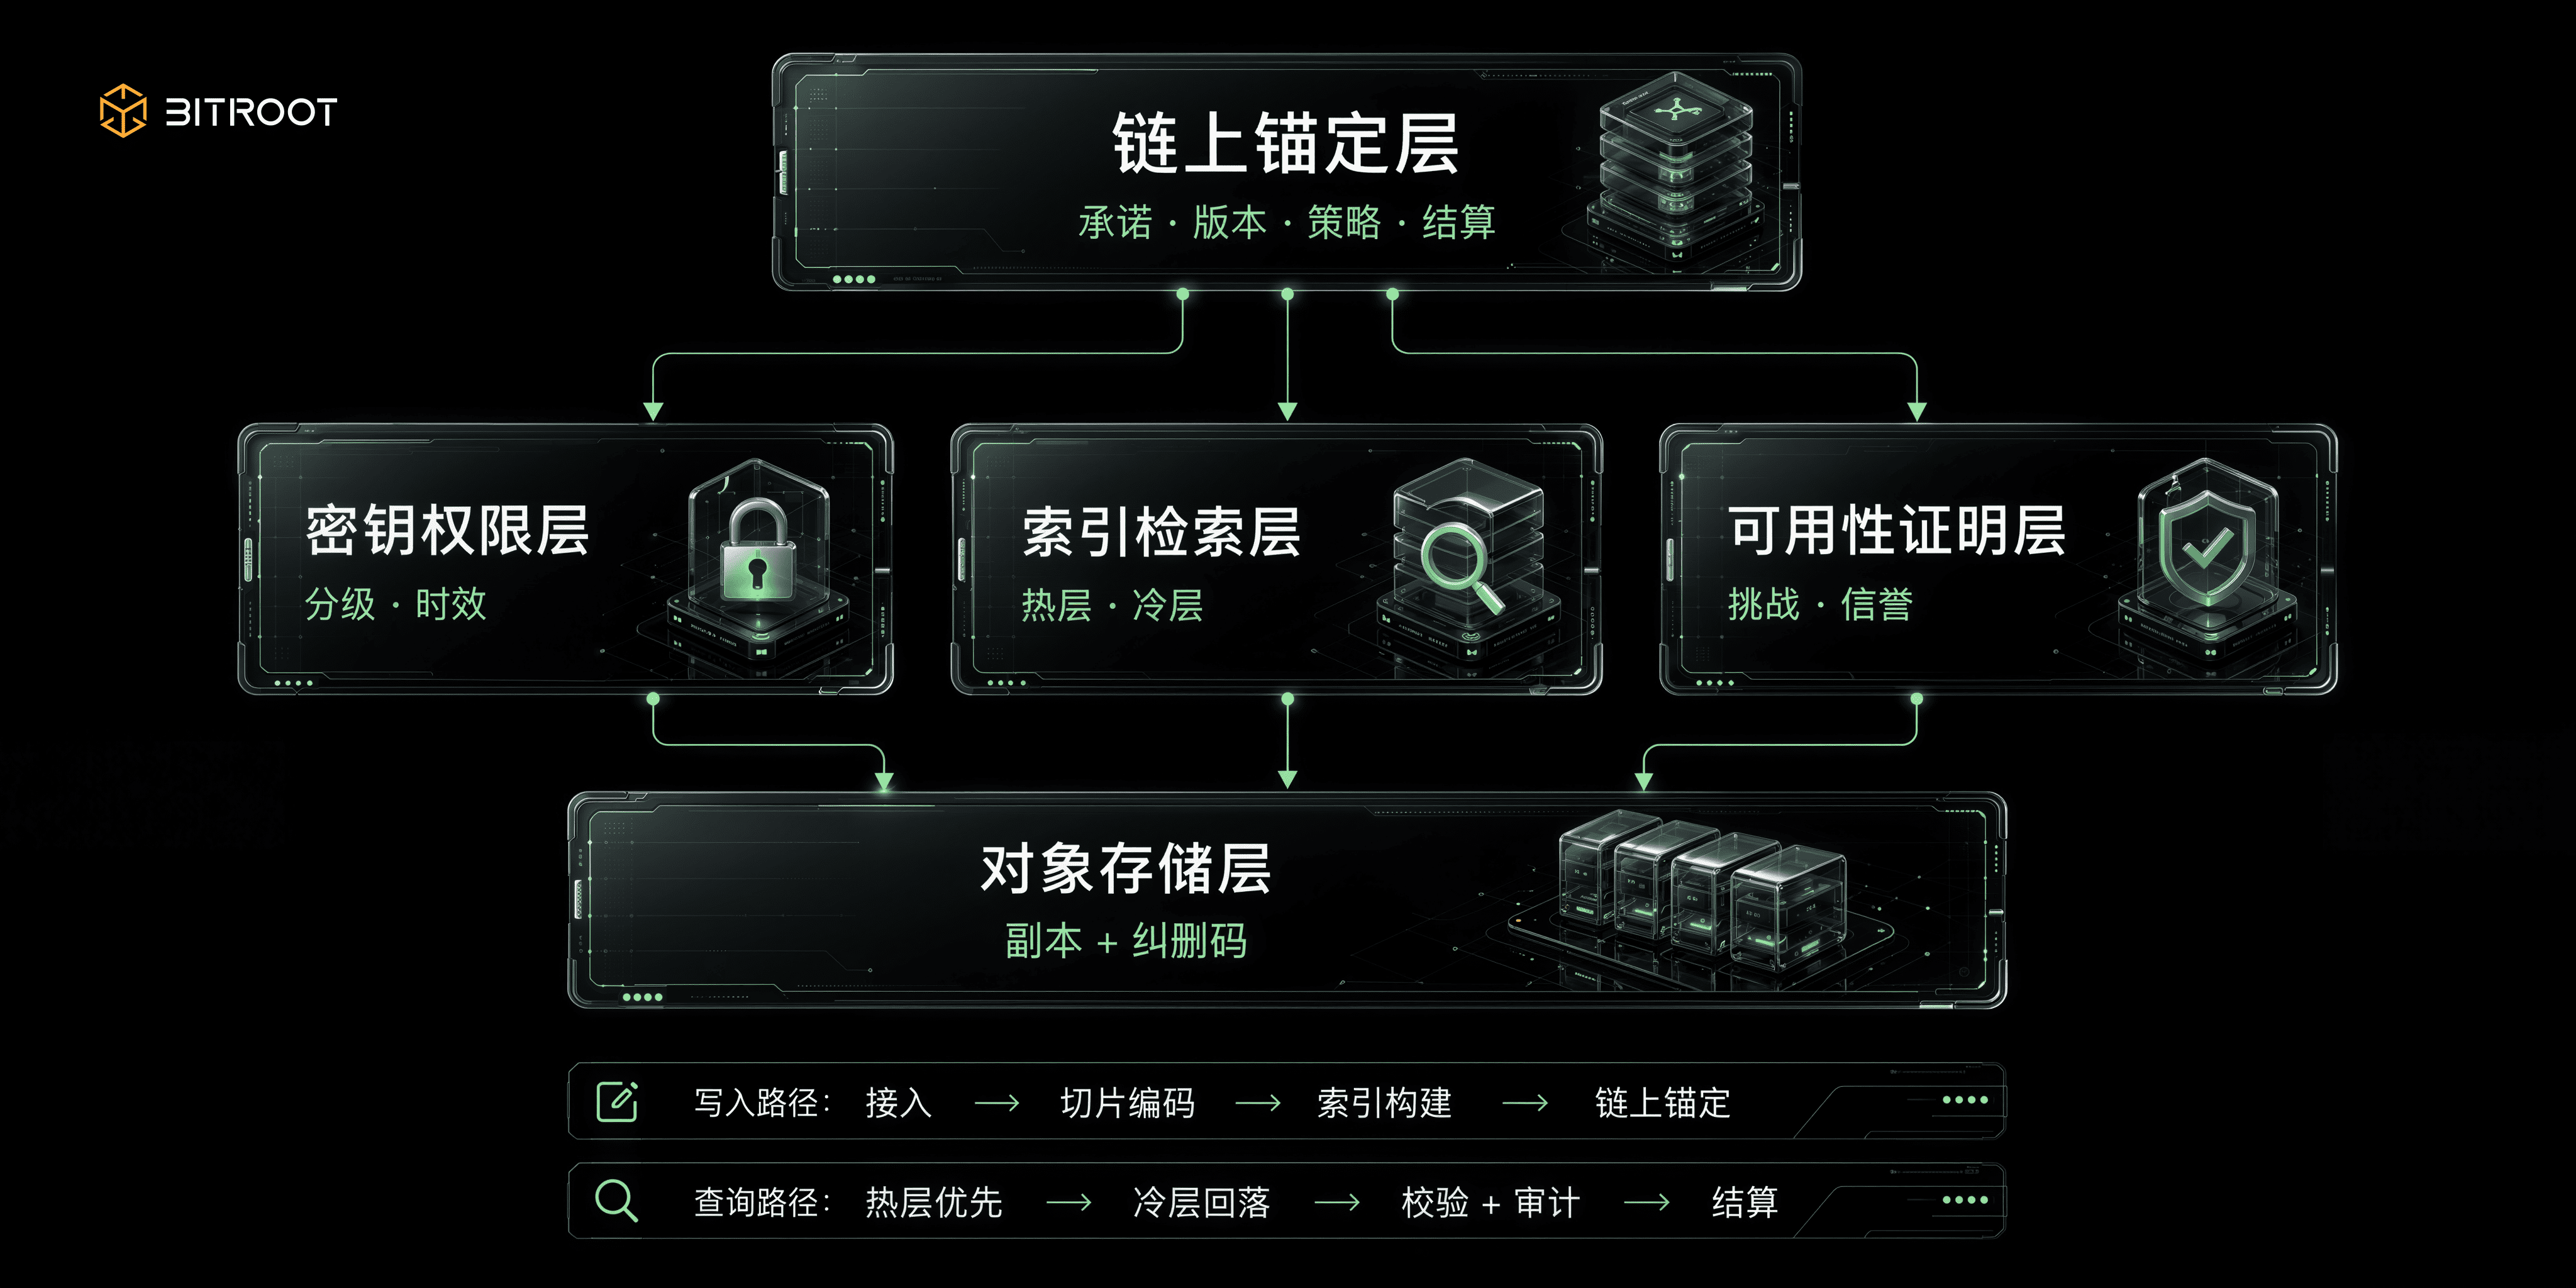
حل عملي على الأرض: بنية بخمس طبقات، ربط “قابلة للتخزين، قابلة للاسترجاع، وقابلة للإدارة” في حلقة واحدة. قيمة البنية ليست في عدد الطبقات بل في ما إذا كانت يمكن تشكيل حلقة إغلاق قابلة للتحقق. وبناءً على الإطار السابق، ينحصر الحل في خمس طبقات: طبقة تثبيت على السلسلة، طبقة تخزين كائنات، طبقة استرجاع فهرس، طبقة إثبات قابلية الاستخدام، وطبقة صلاحيات المفاتيح. الهدف هو جعل “القابل للتحقق” افتراضيًا، وتحويل “الأداء العالي” إلى قدرة قابلة للتكوين، وجعل “الحوكمة” عملية قابلة للتنفيذ.
بالنسبة إلى Bitroot، يمكن فهم هذه الطبقات الخمس كذلك على أنها وحدة حوكمة تخزين ضمن “مكدس ذكاء اصطناعي” (AI Stack): يوفر Parallel EVM قدرة على التثبيت عالي التردد والتسوية، بينما يوفر Pipeline BFT حتمية منخفضة التأخير. وتستوعب شبكة التخزين الموزعة الكائنات الكبيرة والبيانات التاريخية، وتوفر طبقة استرجاع الفهرس خدمة لوكلاء AI والاستدعاءات التطبيقية. وتحول طبقة إثبات قابلية الاستخدام جودة خدمة العقد إلى سمعة ومكافآت، بينما تربط طبقة صلاحيات المفاتيح سيادة المستخدم وحماية الخصوصية وترخيص تجارية النموذج.
طبقة التثبيت على السلسلة لا تخزن سوى الحد الأدنى الضروري من الحالة: التزام البيانات، بصمات الإصدار، ملخص استراتيجيات الصلاحيات، وأحداث التسوية. لا تُرفع الكائنات الكبيرة على السلسلة؛ الذي يُرفع هو الدليل لإثبات وجود هذا الكائن وأن إصداره صحيح. بهذا نحافظ على قابلية التحقق على السلسلة، دون أن تُسحق الإنتاجية بسبب الملفات الكبيرة.
في سياق هندسة Bitroot، فإن طبقة التثبيت على السلسلة ليست مجرد “مكان لتسجيل الهاش”، بل المدخل المشترك لتسجيل أصول AI والحوكمة الخاصة بالصلاحيات وتوزيع الأرباح وحل النزاعات. يمكن تخزين مجموعة البيانات وأوزان النموذج وفهارس المتجهات وسجلات الاستدلال خارج السلسلة بأفضل الطرق، لكن التزامات الإصدار وحالة الترخيص وسجلات الاستدعاء ونسب الأرباح يجب أن تدخل في حالة السلسلة الخاصة بـ Bitroot. بهذه الطريقة، يكون التخزين خارج السلسلة مسؤولًا عن حمل الحجم، بينما تتولى Bitroot حمل الثقة.
طبقة تخزين الكائنات تحمل البيانات الحقيقية وتستخدم استراتيجية هجينة تجمع بين erasure codes والنسخ. تميل الكائنات عالية القيمة والمنخفضة التواتر إلى توجيهها نحو تحمّل الأعطال، بينما تميل الكائنات ذات القيمة المتوسطة والوصول عالي التواتر إلى توجيهها نحو كفاءة الاسترجاع. هذه الاستراتيجية ليست إعدادًا ثابتًا؛ بل تتغير ديناميكيًا مع حرارة الوصول ومستوى الأعمال.
طبقة استرجاع الفهرس تُدرج فهرس الميتاداتا (metadata) وفهرس المتجهات في دليل موحد. تستوعب الطبقة الساخنة الاسترجاع عبر الإنترنت، بينما تستوعب الطبقة الباردة الأرشفة وإعادة البناء. يجب تسجيل جميع إصدارات الفهارس مع إصدار البيانات المصدر ومعلمات البناء، وإلا فلن يمكن محاسبة انحراف الفهرس (index drift).
طبقة إثبات قابلية الاستخدام تُحوّل سلوكيات العقد إلى أرقام. تُدمج نسب نجاح الاستجابة للتحدي، وزمن الاستجابة، ونسبة نجاح الإصلاح في درجة السمعة، ثم تُربط الدرجة بتوزيع المكافآت، لتجنب مكافأة السعة فقط دون مكافأة قابلية الاستخدام.
طبقة مفاتيح/صلاحيات للتحكم في الوصول والامتثال. تستخدم البيانات عالية الحساسية مفاتيح مُصنَّفة وترخيصًا مؤقتًا، وتُخزَّن سجلات الاستدلال مع إزالة بيانات تعريفية (de-sensitized) مع تدقيق وإعادة تشغيل (audit replay)، ويتم استدعاء النموذج بتراخيص قابلة للإلغاء. كما يجب أن تُسجَّل عمليات الصلاحيات نفسها لمنع انحراف الإعدادات (configuration drift).
هذه الخمس طبقات تشكل حلقة مغلقة على مستوى التنفيذ وليست خط أنابيب باتجاه واحد: بعد إدخال البيانات تُجزأ ثم تُشفَّر إلى طبقة الكائنات، ثم بعد الكتابة يتم إنشاء الفهرس وتثبيته على السلسلة. الاستعلامات عبر الإنترنت تمر على الطبقة الساخنة، وإذا لم تكن هناك إصابة كافية تنتقل إلى الطبقة الباردة. بالتزامن مع إرجاع النتيجة، يتم تشغيل تحقق السلامة والتحقق من الصلاحيات، وتدخل الإجراءات الرئيسية في التسوية والتدقيق. القيمة الحقيقية لهذه السلسلة هي أنه يمكن لأي عقد، وفي أي لحظة، الإجابة عن أربعة أسئلة: من أين جاءت البيانات؟ ما هو الإصدار الحالي؟ من لديه صلاحية الوصول؟ وهل يمكن للنظام أن يثبت أنها قابلة للاستخدام.
وهذا أيضًا هو السبب الرئيسي لأن Bitroot مناسب لاستضافة حوكمة تخزين AI. ليست عمليات استدعاء AI Agent، ولا تبديل إصدارات النموذج، ولا تغييرات تفويض البيانات، ولا جدالات نتائج الاسترجاع—عمليات منخفضة التواتر في الخلفية؛ بل ستكون أحداثًا على السلسلة تحدث باستمرار مع نمو التطبيقات. إذا لم توفر السلسلة الأساسية زمن تأكيد منخفضًا بما يكفي وتحملًا عاليًا بما يكفي، فستُجبر حوكمة التخزين في النهاية على العودة إلى الجداول خارج السلسلة والمطابقة اليدوية. يدمج Bitroot بين Parallel EVM وPipeline BFT؛ والقيمة ليست مجرد TPS أعلى، بل تمكين تثبيت هذه أحداث الحوكمة عالية التواتر على السلسلة بشكل لحظي وتسويتها والمحاسبة عنها.
من سيدفع؟ اجعل التوفر هو الذي يحدد المكافأة لا السعة. يجب أن يعمل التخزين لفترة طويلة، ويجب أن تكون الحوافز موجهة إلى قابلية الاستخدام وليس لتكديس السعة. المكافأة حسب السعة تعني بشكل غير مباشر تشجيع العقد على تكديس الهاردات مع خدمة خفيفة. في هذا الصدد قامت Filecoin بتصحيح الفكرة عبر آليات: أدخلت مفهوم “القوة المعدلة بالجودة” (quality-adjusted power)، بحيث تحصل القطاعات التي تنفذ طلبات تخزين حقيقية، خصوصًا القطاعات التي تم التحقق من طلباتها الفعّالة، والتي تُعد وحدة القياس الدنيا لمساحة التخزين، على وزن أعلى في قياس القدرة. وبذلك تميل المكافآت إلى السعة التي تقدم الخدمة فعلاً وليس إلى السعة الفارغة المعبأة فقط. هذه الفكرة جديرة بأن يستفيد منها أي نظام حوافز مخصص.
لتجسيدها كدالة مكافأة قابلة للتنفيذ، يجب أن تضع على الأقل أربع أبعاد في الحساب، وأن تحدد منطق كل وزن بوضوح. السعة تحدد الحصة الأساسية، أي مساحة ما وعدت به. معدل التوفر وزمن الاستجابة يحددان معامل جودة الخدمة، أي هل يمكن حقًا استرجاع تلك المساحة عند الحاجة—ويجب أن يكون له وزن أعلى، وإلا ستتحول قابلية الاستخدام إلى مجرد شعار. تحدد نسبة نجاح استعادة البيانات مصداقية التعافي من الكوارث: هل يمكن إعادة بناء النسخ بعد انقطاع العقد؟ وهذا يرتبط مباشرة ببقاء بيانات “الذيل الطويل”. كثافة القيمة في البيانات تحدد تعزيز الطلب: ضع مضاعفات مختلفة لمجموعات البيانات عالية القيمة والنماذج عالية الطلب بحيث تحصل البيانات النادرة والتي يُستدعى عليها بشكل متكرر على عائد أعلى. يجب أن تُدفع المكافآت مقابل خدمات يمكن إثباتها، لا مقابل السعة المعلنة.
الحوافز الإيجابية وحدها لا تكفي؛ يجب أن تكون آليات الضمان (staking) والعقوبات والتحكيم من جهة القيود متوفرة في نفس الوقت، مع تلبية شرط لا مساواة أساسي في الطبقة الأساسية: يجب أن تكون الأرباح المتوقعة للغش أقل من التكاليف المتوقعة التي ستقع تحت العقوبات؛ وإلا فإن أي آلية إثبات يمكن تجاوزها بمنطق الاقتصاد. يضع الضمان تكلفة على العقد مقابل التزام قابلية الاستخدام، ويجب أن تكون أحجام الضمان متناسبة مع القدرة الحسابية التي يلتزمون بها وقيمة البيانات؛ وفي تصميم Filecoin، يتعين على مزوّدي التخزين دفع ضمان مسبق وفق القدرة المُلتزم بها. وإذا انقطعوا داخل نافذة الإثبات تتولد رسوم أعطال، وإذا تم التخلي الدائم عن القطعة (sector) تُفعّل عقوبة إنهاء أشد. معنى هذه العقوبة المتدرجة هو التعامل بشكل مختلف مع الانقطاعات القصيرة وخروج الأطراف الخبيث. أما التحكيم فيعتمد على أدلة على السلسلة: عندما يدعي المستخدم أن البيانات غير متاحة، وتدعي العقد أنها تقدم خدمة طبيعية، تشكل سجلات التحدي وإثباتات أخذ العينات وسجلات الأحداث أساسًا قابلاً للقراءة آليًا للحكم، لتضغط النزاع الذي كان يحتاج تدخلًا يدويًا إلى حكم واحد يمكن التحقق منه على السلسلة.
في سيناريو AI توجد طبقة حوكمة أصعب فوق ذلك: كيف نُفصّل أرباح الأطراف الثلاثة. نموذج يُستدعى مرارًا وتكرارًا خلفه مساهمون يقدمون بياناتهم، ومساهمون بالنماذج يقدمون التدريب، وعقد التخزين تتحمل مسؤولية الاستضافة. كل طرف يساهم في قيمة الاستدعاء النهائي، لكن المساهمة لا يمكن رصدها مباشرة. الحل الممكن هو بناء إسناد القيمة على أحداث قابلة للقياس على السلسلة: تُحاسب الاستدعاءات “لكل مرة” (per-call) وتسوي تلقائيًا، وتُربط البيانات والنماذج بكل استدعاء عبر بصمات الإصدار وعلاقات النَسَب/الدم (lineage)، ثم تُفك تلقائيًا وفق نسب محاسبة قابلة للبرمجة مكتوبة مسبقًا، لتجنب النزاعات بعد وقوعها. ويترافق ذلك مع قائمة سوداء وآلية عقوبات/مصادرة: في حالات مثل رفع بيانات خبيثة، أو انتهاك حقوق النشر، أو سرقة النموذج. إذا تم الاعتراف بذلك عبر التحكيم، تُصادر الضمانات وتُجمَّد أرباح المستقبل. وإلا فسيظهر نتيجة عكسية: كلما نجحت عملية تحويل الأصول إلى أصول قابلة للتداول، زادت النزاعات على تقسيم الأرباح وتثبيت الحقوق، والتي في النهاية تُسقط ثقة النظام البيئي نفسها.
الامتثال ليس رقعة بعد الإطلاق، بل قيد من مرحلة تصميم البنية: الأساس الأمني هو التشفير من طرف إلى طرف، وإدارة مفاتيح طبقية مع تدوير دوري. ثم إضافة تحقق عبر تجزئة (hash) والتزامات Merkle لضمان إمكانية التحقق من التنزيل. وتُستخدم نسخ متعددة مع تشفير ومسح/erasure codes لتأمين التعافي من الأعطال. من ناحية الخصوصية: تُطبَّق ضوابط وصول الحد الأدنى بحسب مستوى البيانات، مع دعم تفويض قابل للإلغاء، تفويض لمرة واحدة، وتفويض مؤقت. تُترك أثر كامل لسلسلة الوصول والعمليات الرئيسية لتسهيل التدقيق وإعادة التشغيل. كما أن الامتثال هو الحلقة الأكثر قابلية لأن تؤخرها لاحقًا ولديها أعلى تكلفة: يجب أن تكون سياسات تمركز البيانات ونقل المجالات قابلة للتكوين، وأن تكون طلبات الحذف والوصول والتدقيق لها واجهات عمليات قياسية. والأصعب هو التعارض الطبيعي بين “عدم القابلية للتلاعب” و“قابلية الحذف”: الحل الممكن هو التشفير مع “المسح” (encryption erase) وتعطيل الفهرس: تدمير المفاتيح يجعل النص المشفر غير قابل للاستعادة، وتعطيل الفهرس يجعل البيانات غير قابلة للاسترجاع، مع الحفاظ على السجلات التي تُسجلها السلسلة لتلبية طلبات الحذف. من التجربة إلى الإنتاج توجد ثلاث بوابات مراحل: أولًا، بناء حلقة إغلاق موثوقة/قابلة للثقة بأقل حد، وتشغيل تخزين الكائنات والتثبيت على السلسلة والتحقق من السلامة والمراقبة الأساسية حتى تصبح جاهزة؛ يكون القبول عبر قياس التوفر، ونسبة نجاح عمليات القراءة/الكتابة، ونسبة تطابق التثبيت مع إصدار الكائن، والتدريب على التعافي من الأعطال. ثانيًا، تحويل أصول AI إلى أصول قابلة للإدارة مع حوكمة الفهارس: إدخال إدارة أصول مجموعات البيانات وأصول النماذج، وسلسلة النسب للأصدار (version lineage)، وتقسيم الفهرس إلى ساخن/بارد، واستدعاءات تفويض النموذج، وتسجيل مصدر بيانات التدريب؛ يكون القبول عبر التتبع القابل للتدقيق لبيانات التدريب، وأن النموذج يمكن الرجوع/الرجوع للخلف (rollback) ويمكن تدقيقه، وأن زمن الطبقة الساخنة ضمن الهدف، وأن تأثير إعادة بناء الفهرس يمكن التحكم فيه. أخيرًا، إطلاق استرجاع قابل للتحقق وحوكمة آلية: إدخال إثباتات التحدي، ونقل الاستراتيجية وأتمتة المكافآت والعقوبات؛ يكون القبول عبر تغطية إثباتات التوفر، وزمن التعامل مع المخاطر، وانخفاض تكلفة الوحدة، وأن تغييرات الاستراتيجية قابلة للتتبع ويمكن الرجوع. نظام المؤشرات هو نظام للسياسات وليس مجرد لوحة عرض. إن كتابة “الأجزاء التقنية” فقط دون نتائج الأعمال ستجعل حل التخزين ينهار إلى مركز تكلفة خالص. يُنصح بتقسيم ثلاث طبقات: مؤشرات تقنية أساسية (التوفر، تأخير P95/P99، الإنتاجية، RTO/RPO، معدل الأخطاء) تجيب إن كان النظام سليمًا، مؤشرات AI خاصة (نسبة تتبع بيانات التدريب، نسبة إعادة إنتاج النموذج، تغطية تحقق الاستدلال، اتساق الفهارس) تجيب هل يمكن حوكمة جودة النموذج، ومؤشرات نتائج الأعمال (نمو إمداد البيانات، انخفاض تكاليف الاستدعاء، نشاط العقد، حجم تداول الأصول) تجيب هل النظام يخلق قيمة. يجب أن تكون هناك علاقة بين الطبقات، وأن تكون الغاية الحقيقية للمؤشرات هي إدخال تحسينات للسياسات لا مجرد تقارير عرض. أكثر نقاط الفشل الخمس شيوعًا يمكن تجنبها مبكرًا: عمل تخزين فقط دون حوكمة إصدارات، أو اعتبار “غير قابل للتمثيل يعني غير قابل للتوفر” والعكس؛ التركيز على السعة دون إثباتات التوفر، لأن المكافآت حسب السعة تحفّز على “تكديس السعة” وخدمة خفيفة؛ تطبيق تقسيم ساخن/بارد لكن بدون استراتيجية مزامنة، لأن مزامنة إصدارات الفهرس والتعامل مع الإبطال لا يتم إغلاقها؛ تأخير سياسات الامتثال، فكلما تأخر التنفيذ (الصلاحيات والسجلات وإزالة الحساسية والاستجابة للحذف) زادت التكلفة؛ عدم وجود آلية خروج للانتقال، فبعد تمركز ثم لا تمركز هو مسار منطقي، لكن غياب عتبة انتقال يجعل حالة الانتقال تتجمد ويخون الهدف الأولي.
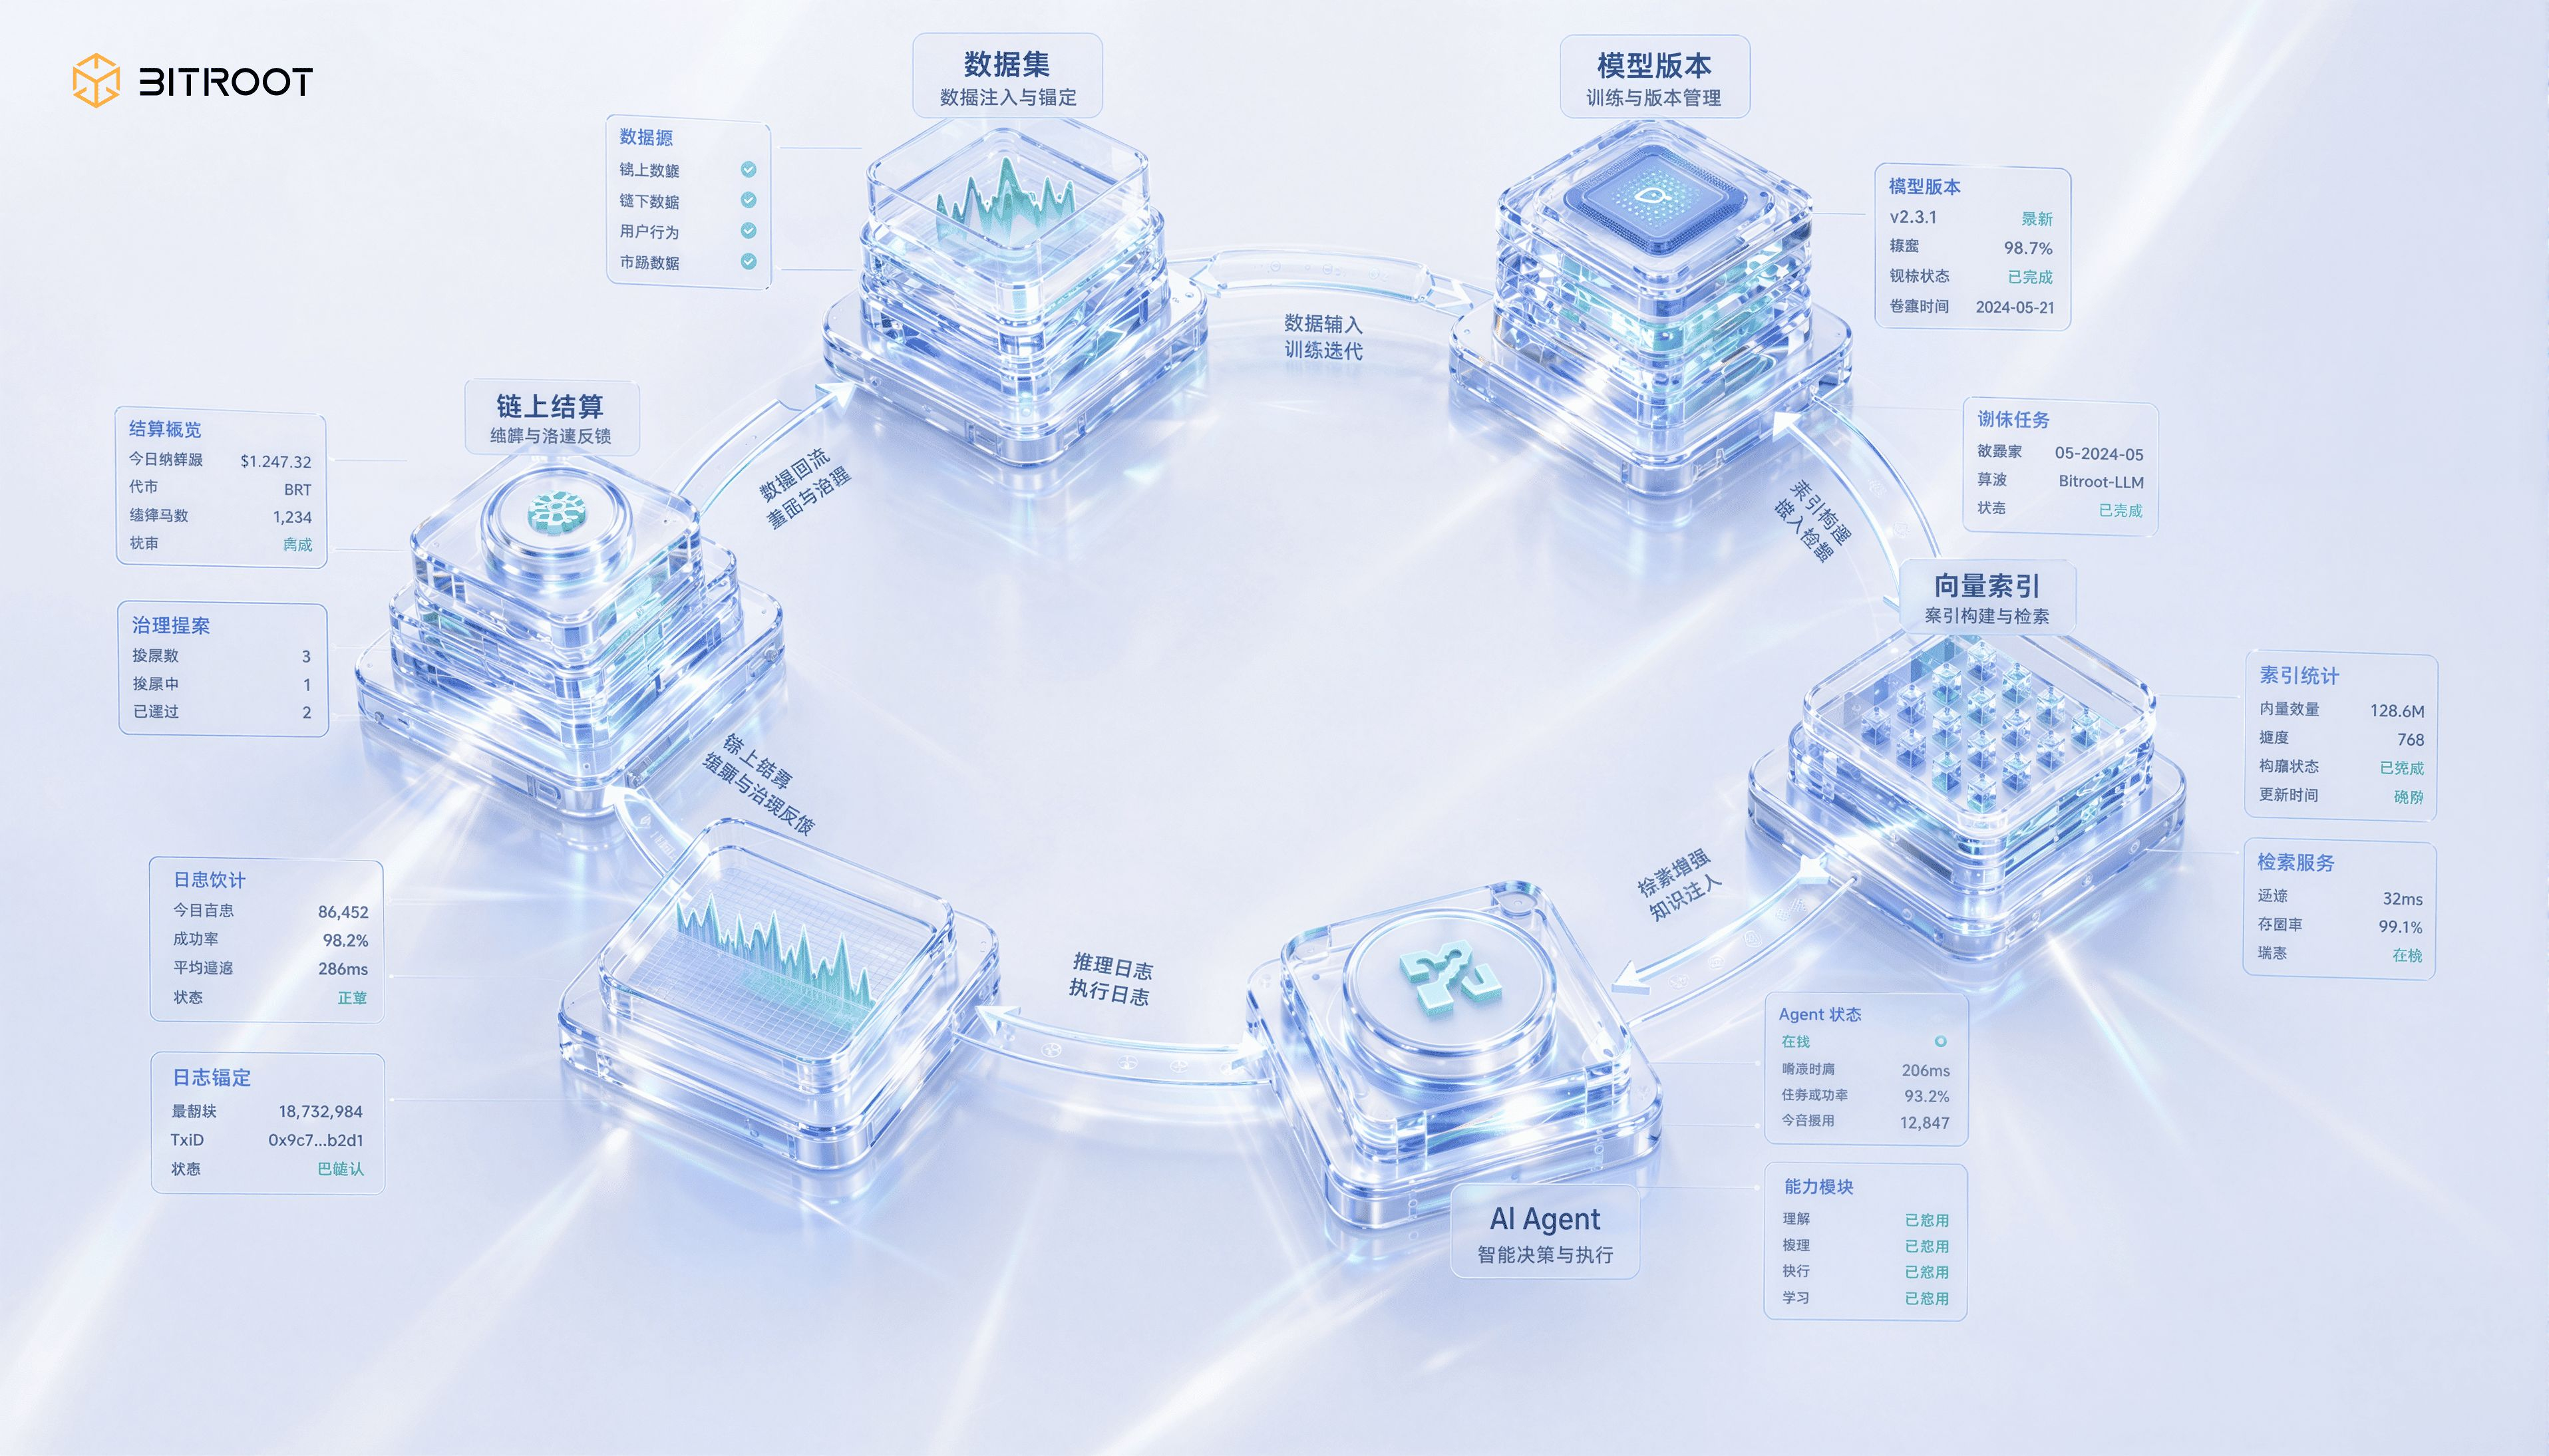
الإغلاق الكامل لـ Bitroot: من البيانات إلى النماذج ثم إلى AI Agent ضمن هذه الحلقة. يمكن لـ Bitroot تحويل كل سلوك محوري لأصول الذكاء الاصطناعي إلى أحداث قابلة للتسوية: تسجيل مجموعة بيانات، إصدار نسخة نموذج، إعادة بناء فهرس متجهات، استدعاء AI Agent، تثبيت سجل الاستدلال على السلسلة، تفويض الصلاحيات والإلغاء، وتحديات النزاع ونتائج التحكيم. لا تحتاج السلسلة إلى حمل كل البيانات، لكن يجب أن تحمل الدليل الأدنى لتلك السلوكيات. وبهذه الطريقة فقط لا تبقى علاقة القيمة بين البيانات والنماذج والحوسبة والتطبيقات مجرد وعود شفهية، بل تدخل في محاسبة قابلة للبرمجة وحوكمة قابلة للتدقيق.
وضع هذه الآلية داخل تشغيل Bitroot وتوسع النظام البيئي يجعل حوافز التخزين لا ينبغي تصميمها كدعم مادي منفصل للأجهزة، بل كجزء من تدفق قيمة AI Stack: يحصل مساهم بيانات على العائد لأن بياناته تُستخدم للتدريب أو الاستدعاء، ويحصل مساهم النموذج على العائد لأن نموذجه يقدم خدمة، وتحصل عقد التخزين والاسترجاع على العائد بسبب التوفر المستمر وتأخر منخفض، وتحصل عقد التحقق والتحدي على المكافأة بسبب اكتشاف عدم التوفر أو انحراف الفهرس أو حالات غير طبيعية في الصلاحيات. بذلك لا تكافئ منظومة Bitroot الاقتصادية “من رفع البيانات مرة واحدة”، بل “من ثبت أنه مفيد بشكل قابل للتحقق باستمرار”.
التخزين ليس مركز تكلفة، بل نظام لتوزيع الثقة والقيمة. ما يجب حله في عصر AI ليس استبدال منتج تخزين بعينه، ولا السعي لسردية لامركزية فقط، بل أربع مسائل أصعب: إثباتات موثوقة مستمرة لقابلية الاستخدام، نظام حوكمة من أجل التعاون عبر الأطراف، سلسلة مسؤولية البيانات والنماذج، وحوافز اقتصادية مستدامة.
لا يمكن لبنية معماريّة أحادية البروتوكول وطبقة واحدة أن تغطي هذه الأهداف. المسار الأكثر واقعية هو بنية تركيبية: العنونة بالمحتوى تضمن سلامة المحتوى، إثباتات التخزين تضمن بعدًا زمنيًا لتوفر قابل للإثبات، والطبقة الدائمة تضمن التاريخ/المرجع الحاسم، والطبقة الساخنة تضمن تجربة استخدام عبر الإنترنت، والتثبيت على السلسلة يضمن الحوكمة والتسوية مع قابلية إثبات. وهذا ليس “تنازلًا”، بل عقلانية هندسية. التركيز في التنفيذ لا يكون على اكتمال الوظائف بل على أن الحلقة المغلقة تتحقق أولًا: تشغيل حلقة موثوقة بأقل حد أولًا، ثم إضافة أتمتة حوكمة البيانات وتحويل الأصول إلى أصول قابلة للتحقق والاسترجاع طبقة طبقة.
ضغط هذه المنهجية في أسبوع من العمل، في الواقع لديه ثلاث خطوات فقط: اليوم الأول لإنجاز جدول جرد بيانات ذو ثمانية حقول، اليوم الثالث لتشغيل مرة واحدة على مجال أعمال حقيقي مسارًا حدًا أدنى من القبول، التخزين، الاسترجاع إلى التحقق، واليوم السابع لإجراء مراجعة لعتبة الترحيل مرة واحدة مع استخدام P95 للتأخير وتكلفة الوحدة. عند إنجاز هذه الخطوات الثلاث، ستنتقل الفرقة من إجماع المفهوم إلى إجماع هندسي.
كما يجب أن نقر بحد واقعي: مهما استخدمنا توليفة بروتوكولات، توجد دائمًا مفاضلات بين التكلفة وزمن التأخير والمتانة؛ لا توجد إجابة واحدة مثالية لكل الأعمال. تأتي الحلول المستدامة من التكرار والتحسين ضمن حدود واضحة، لا من قرار نهائي ثابت بعد الموافقة.
غالبًا عند “تصفية/إقصاء” مشروع ما، لا يكون السبب أن TPS غير كافٍ، بل أن سلسلة مسؤولية البيانات لا يمكن شرحها. في عصر السلاسل العامة لـ AI، ليس التخزين مجرد وضع البيانات في مكان ما، بل جعل البيانات قابلة للإثبات في أي لحظة.
خاتمة
المنافسة الحقيقية لسلاسل AI العامة لن تقف في النهاية عند مقارنة TPS أو Gas أو وقت تأكيد. الأداء هو بوابة الدخول لكنه ليس النهاية. في عصر التطبيقات الأصلية لـ AI، يجب أن تتحمل الأنظمة على السلسلة ليس فقط المعاملات، بل أيضًا إصدارات البيانات، واستدعاءات النموذج، وتوزيع القدرة، وسجلات الاستدلال، وسلوكيات Agent، وتوزيع أرباح الأطراف المتعددة.
هذا أيضًا حكم Bitroot على طبقة التخزين: التخزين ليس مجرد وحدة تابعة، بل هو الأقرب لطبقة مصدر القيمة داخل AI Stack. هل يمكن إثبات البيانات؟ هل يمكن إعادة إنتاج النموذج؟ هل يمكن تدقيق الاستدعاءات؟ وهل يمكن توزيع الأرباح تلقائيًا؟ هذه تحدد ما إذا كانت شبكة AI لامركزية تمتلك حياة طويلة الأمد فعلًا.
ما تريد Bitroot بناؤه ليس سلسلة تسعى فقط لتنفيذ أسرع، بل بنية تحتية تمكّن أصول AI من أن تُؤكَّد وتُستدعى وتُسوى وتُحكم. يحل Parallel EVM وPipeline BFT مشكلة قدرة السلسلة على حمل أحداث متكررة؛ كما يحل التخزين الموزع والآليات القابلة للتحقق أساس الثقة لبيانات AI والنماذج؛ أما المحاسبة القابلة للبرمجة والحوكمة على السلسلة فحوّلان المساهمة إلى حوافز اقتصادية مستمرة.
عندما يبدأ AI Agent بالعمل نيابة عن المستخدم، وعندما تصبح النماذج والبيانات أصولًا قابلة للتداول، وعندما تدخل قدرات الحوسبة والتخزين وخدمات الاستدلال في نفس شبكة القيمة، لن يعود التخزين مشكلة “مكان وضع الملفات” فقط.
سيصبح قاعدة الثقة لسلسلة AI العامة، وسيصبح كذلك نظام توزيع القيمة للشبكة الذكية القادمة.
ترى Bitroot أن المستقبل الحقيقي للأهمية ليس “من يملك أكبر قدر من البيانات”، بل “من يمكنه جعل البيانات في أي لحظة قابلة للإثبات وقابلة للاستدعاء وقابلة للمحاسبة”، وأخيرًا المشاركة في تسوية القيمة.
حول Bitroot: Bitroot هو مشروع سلسلة عامة Layer 1 يركز على التنفيذ المتوازي والبنية الأصلية للذكاء الاصطناعي. يعتمد Bitroot مسار تقني متوافقًا مع EVM، ويستكشف بيئة تنفيذ على السلسلة عالية الأداء ومنخفضة التكلفة لوكلاء AI وDeFi وتطبيقات Web3 عبر آليات التنفيذ المتوازي وتحسينات الإجماع وتصميم واجهات مرتبطة بالذكاء الاصطناعي.
انضم إلينا:
الموقع الرسمي: https://bitroot.co/
تويتر: https://twitter.com/Bitroot_
تيليجرام: https://t.me/bitroot_official