معظم الناس يعتقدون أن الجزء الصعب من دمج الذكاء الاصطناعي في البلوكشين هو جعل النماذج أكثر ذكاءً. بعد النظر في #HACA و OpenGradient، بدأت أعتقد أن التحدي الحقيقي أقل جاذبية بكثير: التوسع.
في البداية، كنت مرتبكًا بشأن الفكرة. تم تصميم البلوكشين حول التحقق والتوافق، بينما يزدهر الذكاء الاصطناعي على الحوسبة والسرعة. تبدو تلك الأهداف غير متوافقة تقريبًا. كلما قرأت أكثر، شعرت كأنني أحاول تشغيل مركز بيانات من خلال نظام تصويت.
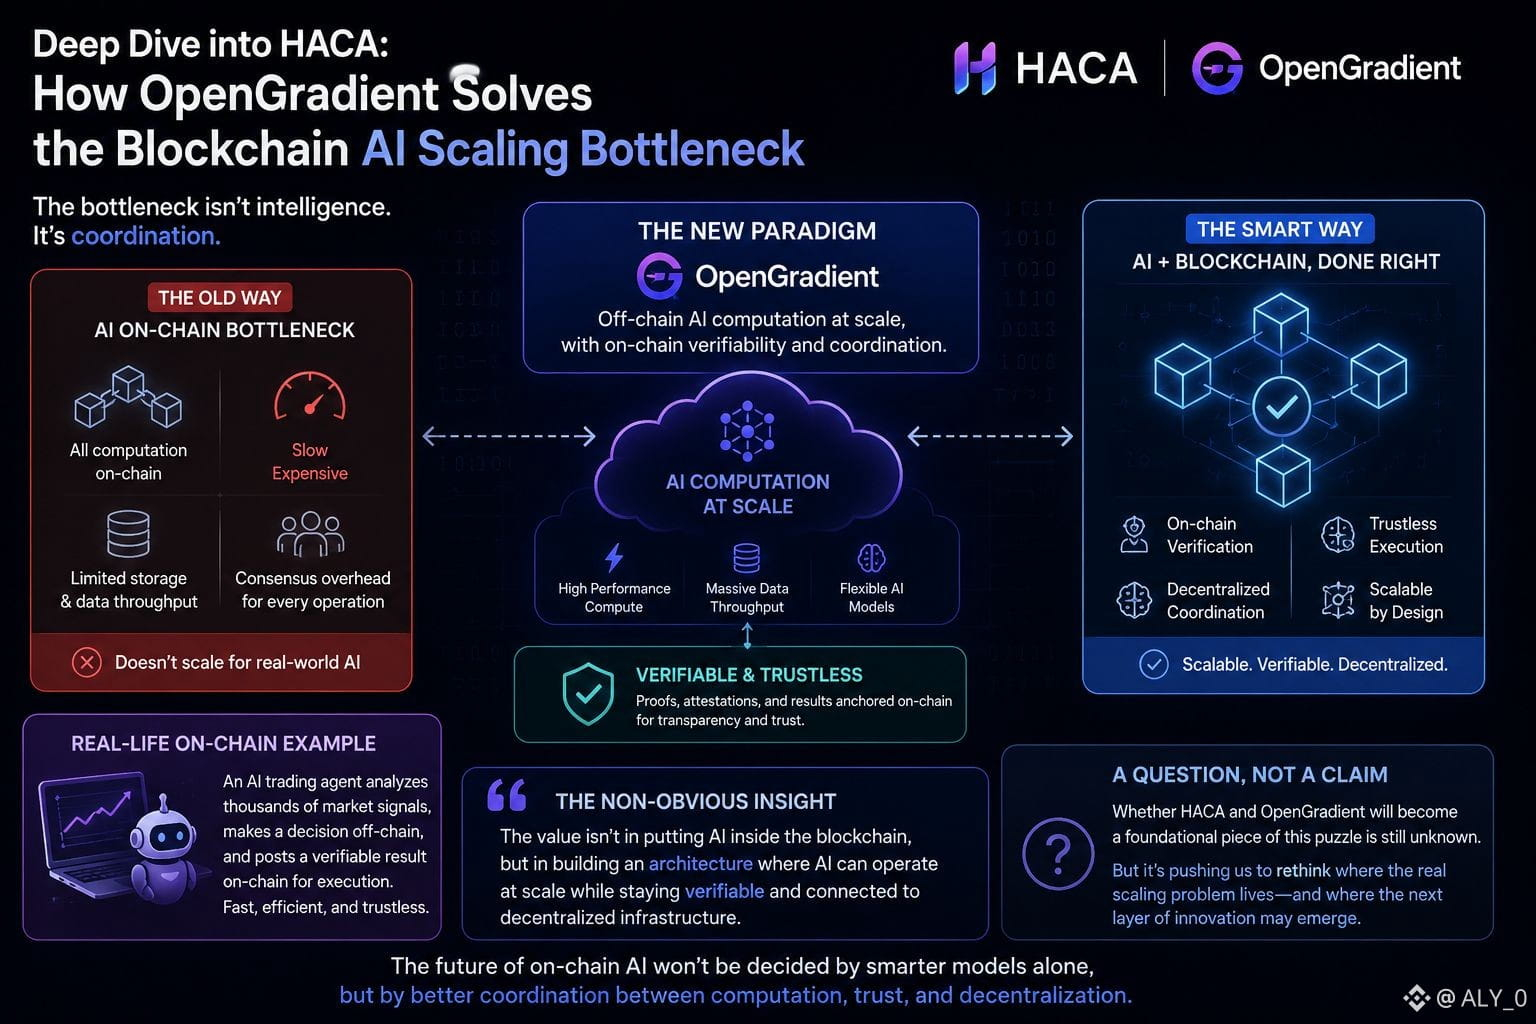
ما غير وجهة نظري هو التفكير في مثال بسيط على السلسلة. تخيل وكيل ذكاء اصطناعي يقوم بتحليل آلاف إشارات السوق قبل اتخاذ قرار تداول. تخزين أو حساب كل ذلك مباشرة على السلسلة سيكون غير فعال بشكل مؤلم. نقطة الاختناق ليست الذكاء - بل التنسيق.
هنا أصبحت مقاربة OpenGradient مثيرة للاهتمام بالنسبة لي. الرؤية غير الواضحة هي أن القيمة قد لا تأتي من وضع الذكاء الاصطناعي داخل البلوكشين، ولكن من إنشاء إطار حيث يمكن للذكاء الاصطناعي العمل على نطاق واسع بينما لا يزال قابلًا للتحقق ومتصلًا بالبنية التحتية اللامركزية. بعبارة أخرى، قد تكون الاختراقات في الهندسة المعمارية، وليس في النموذج.
أعتقد أن العديد من الناس يفتقدون هذا التمييز. يركزون على أداء النموذج، بينما السؤال الأعمق هو كيف يتفاعل الثقة والحوسبة والتنسيق عندما تصبح أنظمة الذكاء الاصطناعي مشاركين في الشبكة بدلاً من مجرد أدوات.
سواء أصبحت HACA في النهاية قطعة ذات معنى من هذه الأحجية لا تزال سؤالًا مفتوحًا. لكنها جعلتني أعيد التفكير في مكان وجود مشكلة التوسع الحقيقية - وربما حيث تحدث الطبقة التالية من الابتكار بهدوء.
#opg $OPG @OpenGradient $OPG
في البداية، كنت مرتبكًا بشأن الفكرة. تم تصميم البلوكشين حول التحقق والتوافق، بينما يزدهر الذكاء الاصطناعي على الحوسبة والسرعة. تبدو تلك الأهداف غير متوافقة تقريبًا. كلما قرأت أكثر، شعرت كأنني أحاول تشغيل مركز بيانات من خلال نظام تصويت.
ما غير وجهة نظري هو التفكير في مثال بسيط على السلسلة. تخيل وكيل ذكاء اصطناعي يقوم بتحليل آلاف إشارات السوق قبل اتخاذ قرار تداول. تخزين أو حساب كل ذلك مباشرة على السلسلة سيكون غير فعال بشكل مؤلم. نقطة الاختناق ليست الذكاء - بل التنسيق.
هنا أصبحت مقاربة OpenGradient مثيرة للاهتمام بالنسبة لي. الرؤية غير الواضحة هي أن القيمة قد لا تأتي من وضع الذكاء الاصطناعي داخل البلوكشين، ولكن من إنشاء إطار حيث يمكن للذكاء الاصطناعي العمل على نطاق واسع بينما لا يزال قابلًا للتحقق ومتصلًا بالبنية التحتية اللامركزية. بعبارة أخرى، قد تكون الاختراقات في الهندسة المعمارية، وليس في النموذج.
أعتقد أن العديد من الناس يفتقدون هذا التمييز. يركزون على أداء النموذج، بينما السؤال الأعمق هو كيف يتفاعل الثقة والحوسبة والتنسيق عندما تصبح أنظمة الذكاء الاصطناعي مشاركين في الشبكة بدلاً من مجرد أدوات.
سواء أصبحت HACA في النهاية قطعة ذات معنى من هذه الأحجية لا تزال سؤالًا مفتوحًا. لكنها جعلتني أعيد التفكير في مكان وجود مشكلة التوسع الحقيقية - وربما حيث تحدث الطبقة التالية من الابتكار بهدوء.
#opg $OPG @OpenGradient $OPG