كلما قضيت وقتًا أطول مع الذكاء الاصطناعي، زادت قناعتي بأننا نركز على الشيء الخطأ.
الجميع يتحدث عن نماذج أفضل.
نماذج أذكى.
نماذج أقوى.
لكن ماذا يحدث عندما يصبح الذكاء نفسه وفيرًا؟
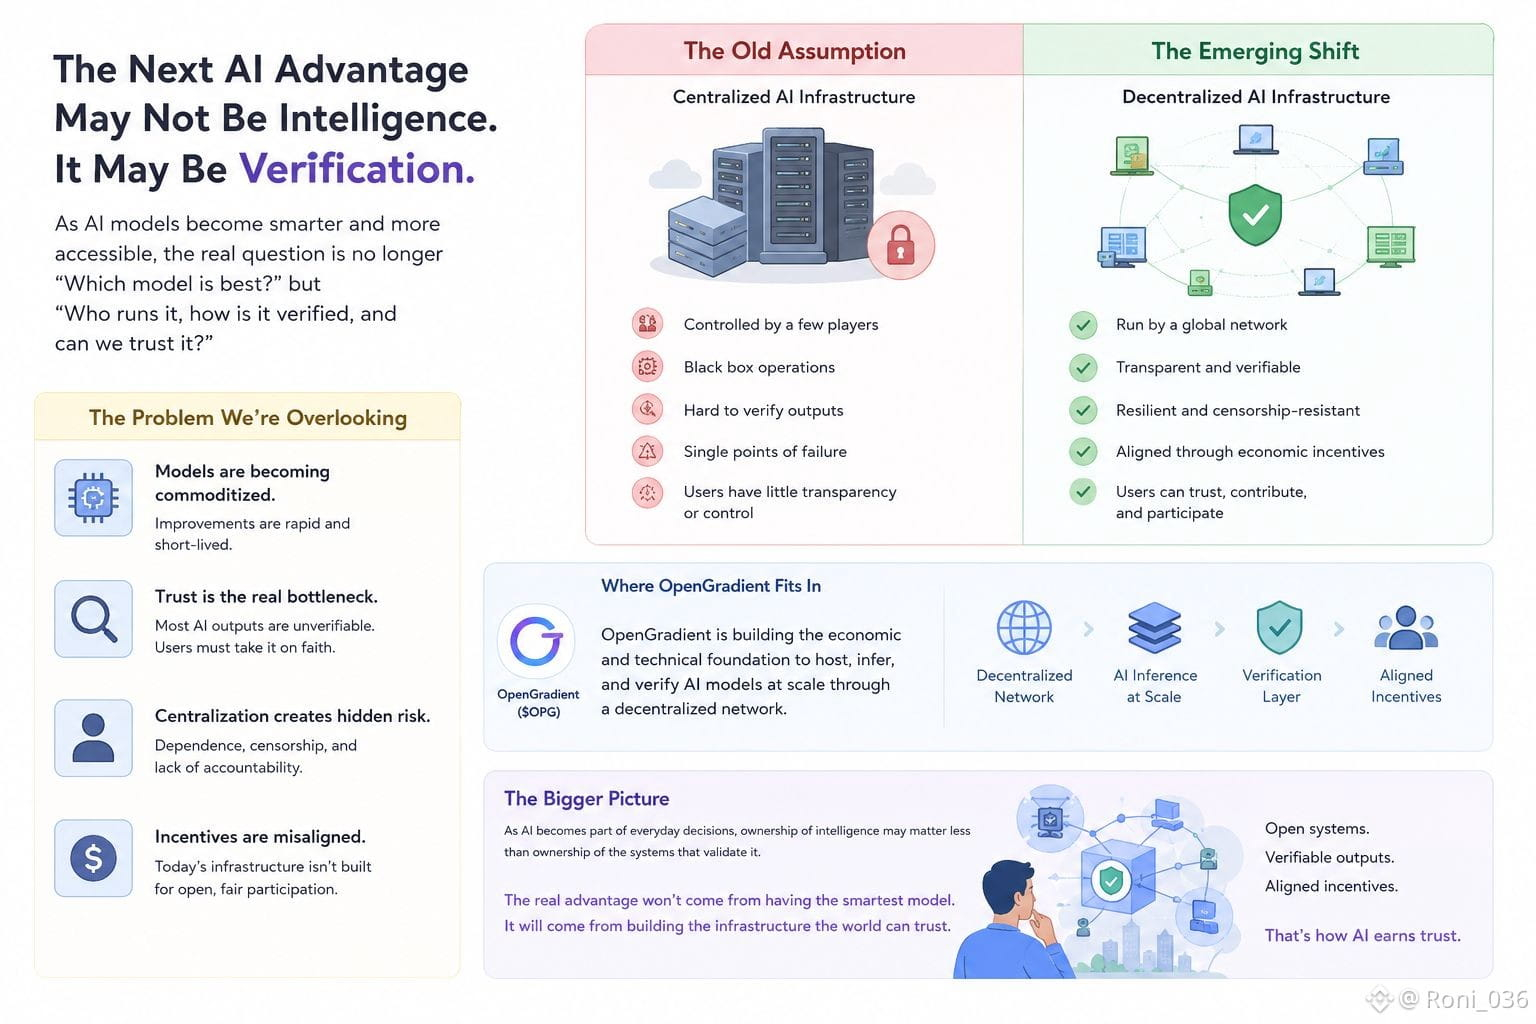
قبل بضع سنوات، كان الوصول إلى الذكاء الاصطناعي المتقدم يبدو كميزة. اليوم، تظهر نماذج جديدة تقريبًا كل أسبوع. الفجوة بينها تبدو تتقلص أسرع مما توقعه معظم الناس.
لذلك بدأت أبحث في سؤال مختلف.
ليس "أي نموذج هو الأفضل؟"
لكن "كيف نعرف ما الذي يمكن أن نثق به؟"
رد الذكاء الاصطناعي موثوق به فقط بقدر موثوقية البنية التحتية خلفه. إذا لم يستطع المستخدمون التحقق من مصدر المخرجات، أو من يدير الأنظمة، أو كيف تُتخذ القرارات، فإن الذكاء وحده لا يحل شيئًا.
ما لفت انتباهي حول @OpenGradient ($OPG ) هو أنه يجعل هذه القضية أكثر وضوحًا. يدفع الحديث إلى ما هو أبعد من أداء النموذج نحو الشبكات المسؤولة عن استضافة وتشغيل والتحقق من الذكاء الاصطناعي على نطاق واسع.
يبدو أن هذه مناقشة أكبر بكثير.
يمكن أن تقلل البنية التحتية المفتوحة من الاعتماد على عدد قليل من المزودين، لكنها تخلق أيضًا تحديات جديدة حول التنسيق، والحوافز، والمساءلة.
الفرصة واضحة.
الجزء الصعب هو بناء أنظمة تبقى مفتوحة دون التضحية بالثقة.
بينما يستمر الذكاء الاصطناعي في الانتشار في كل مكان، قد لا تكون الميزة التنافسية الحقيقية هي الذكاء نفسه.
قد تكون القدرة على التحقق منه.
#opg $OPG @OpenGradient