أغلب الفرق التي تبني وكلاء الذكاء الاصطناعي تعمل على تحسين الطبقة الخاطئة
الجميع يتبادل النماذج من GPT-4، كلود، جيميني، وعاد مرة أخرى بحثاً عن دفعة من التفكير قد تحرك المؤشر بنسبة 5-8%. بينما المشاكل الحقيقية تكمن في مكان آخر.
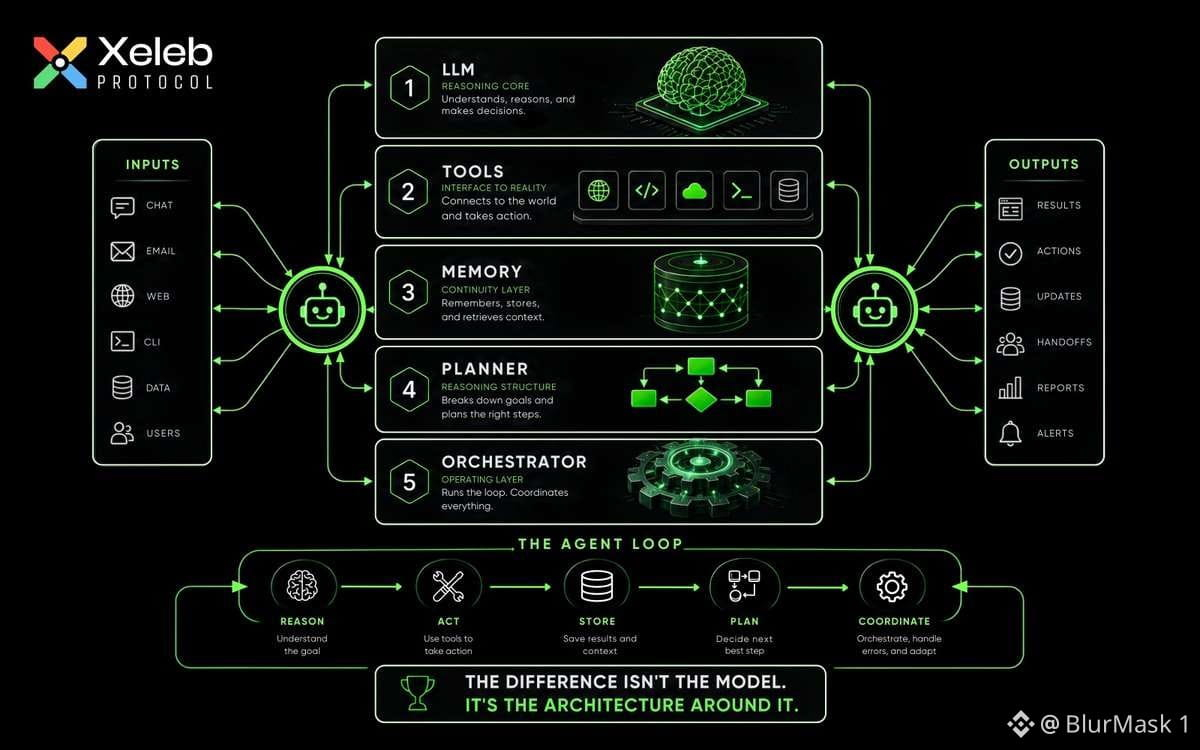
الذاكرة تت resets في كل جلسة. المخطط يتعطل عندما تتغير الظروف أثناء المهمة. المنظم ليس لديه استرداد حقيقي للأخطاء عندما يفشل شيء ما بعد ثلاث خطوات.
النموذج هو الجزء الذي يراه الجميع وهو الجزء الذي يهم أقل بمجرد أن تتجاوز عتبة القدرة الأساسية. معظم الفرق تجاوزت تلك العتبة منذ أشهر دون أن تلاحظ. التفكير جيد بما فيه الكفاية لكن البنية التحتية حوله ليست كذلك.
ما يميز الوكلاء الذين يعملون بشكل موثوق في الإنتاج عن الوكلاء الذين بدوا رائعين في عرض توضيحي ليس اختيار النموذج. بل هو ما إذا كان الوكيل يتذكر ما تعلمه الأسبوع الماضي، يسترد عندما تفشل مكالمة الأداة وسط المهمة، وينسق بشكل نظيف عندما يعمل عدة وكلاء على نفس المشكلة.
للإجابة على سؤال @xeleb_protocol بشكل مباشر، الذاكرة هي الطبقة الأقل بناءً في معظم مجموعات الوكلاء اليوم. معظمهم يتعاملون معها كفكرة لاحقة. الوكلاء الذين يتراكمون في القيمة يعاملونها كأساس يجلس عليه كل شيء آخر.
#AIAgents #BNBChain #Xeleb $BEAT $BNB
الجميع يتبادل النماذج من GPT-4، كلود، جيميني، وعاد مرة أخرى بحثاً عن دفعة من التفكير قد تحرك المؤشر بنسبة 5-8%. بينما المشاكل الحقيقية تكمن في مكان آخر.
الذاكرة تت resets في كل جلسة. المخطط يتعطل عندما تتغير الظروف أثناء المهمة. المنظم ليس لديه استرداد حقيقي للأخطاء عندما يفشل شيء ما بعد ثلاث خطوات.
النموذج هو الجزء الذي يراه الجميع وهو الجزء الذي يهم أقل بمجرد أن تتجاوز عتبة القدرة الأساسية. معظم الفرق تجاوزت تلك العتبة منذ أشهر دون أن تلاحظ. التفكير جيد بما فيه الكفاية لكن البنية التحتية حوله ليست كذلك.
ما يميز الوكلاء الذين يعملون بشكل موثوق في الإنتاج عن الوكلاء الذين بدوا رائعين في عرض توضيحي ليس اختيار النموذج. بل هو ما إذا كان الوكيل يتذكر ما تعلمه الأسبوع الماضي، يسترد عندما تفشل مكالمة الأداة وسط المهمة، وينسق بشكل نظيف عندما يعمل عدة وكلاء على نفس المشكلة.
للإجابة على سؤال @xeleb_protocol بشكل مباشر، الذاكرة هي الطبقة الأقل بناءً في معظم مجموعات الوكلاء اليوم. معظمهم يتعاملون معها كفكرة لاحقة. الوكلاء الذين يتراكمون في القيمة يعاملونها كأساس يجلس عليه كل شيء آخر.
#AIAgents #BNBChain #Xeleb $BEAT $BNB