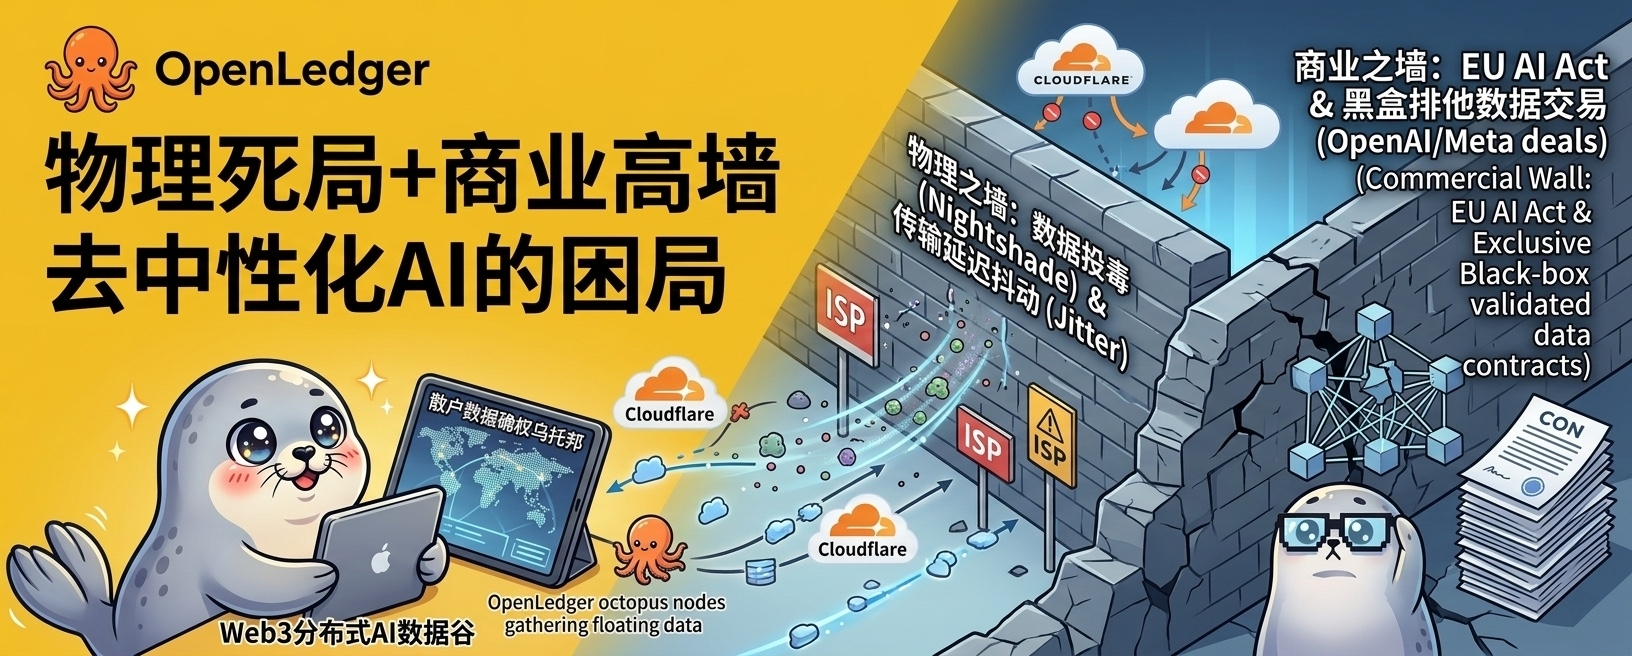

يونيو في الشمال الشرقي هو موسم الأمطار، والهواء الرطب واللزج والمطر الذي لا يتوقف في الخارج يجعل الشخص يشعر بالقلق دون سبب. بالصدفة، اليوم هو اللحظة الأخيرة لمهمة $OPEN #CreatorPad ، والجو من حولي مشبع بشعارات تدعو للركوب وتصرخ "عصر الذكاء الاصطناعي وحقوق البيانات المتساوية". قمت بتحضير فنجان من القهوة السوداء المرّة، وتحدقت في شاشة الكمبيوتر حيث كانت الأخبار القديمة عن التعاون المثير بين OpenLedger وStory Protocol لإطلاق "التأكيد الآلي لحقوق الملكية"، وغرقت في رحلة عاطفية طويلة ومؤلمة.
اليوم، عندما أجبرت نفسي على الخروج من وجهة نظر قانونية ضيقة، بالإضافة إلى النظر من منظور هندسة الشبكات والمنطق الأساسي للتعلم الآلي، عدت لأعيد تقييم المخطط التكنولوجي الكامل والدائرة التجارية المغلقة. تلك الدهشة الأولية كانت مثل فقاعة انفجرت، تاركةً وراءها شعوراً بالبرد في القلب - اكتشفت أن هذه الرواية الضخمة، أمام القوانين الفيزيائية الأساسية، وأمن البيانات، والجدران العالية للقوانين التجارية الواقعية، هشة كقطعة من الورق المنقوعة في الماء.
بداية مبهرة: كنت أنا أيضًا أصفق واقفًا ذات مرة
لا بد من الاعتراف أن @OpenLedger ، حين تتحد مع Story Protocol في رسم هذه الرؤية، فإنها تمتلك على مستوى المنطق الخالص قدرة إقناع عالية جدًا. ففي سلسلة صناعة الذكاء الاصطناعي التقليدية، يظل المبدعون، ومنظفو البيانات، والعقد الطرفية في أسفل السلم الغذائي دائمًا. أما عمالقة مثل OpenAI وGoogle، وبفضل القوة الحاسوبية الهائلة والفرق القانونية الضخمة، فيستنزفون بلا اكتراث البيانات المجانية من العالم لتدريب النماذج. وهنا تأتي Datanets التي طرحها #OpenLedger (مجموعات بيانات مملوكة للمجتمع) وModelFactory لتصيب جوهر المشكلة مباشرة. إن دمجها مع Story Protocol خلق حلقة مغلقة تبدو شبه مثالية: يساهم المستخدمون عبر العقد بالبيانات، وتستخدم OpenLedger إثبات الإسناد (Proof of Attribution) لتسجيل كل جزء من مساهمتك في نموذج الذكاء الاصطناعي على السلسلة؛ وبمجرد أن يبدأ هذا النموذج بتحقيق الاستخدام التجاري (Inference)، فإن البروتوكول الأساسي لـ Story Protocol سيُفعَّل تلقائيًا، ليتم تسوية الإتاوات على شكل مدفوعات دقيقة (Micro-transactions) عبر رمز OPEN إلى المساهمين الأصليين في البيانات في الوقت الحقيقي.
أليس هذا هو اليوتوبيا التي نحلم بها، وهي ذكاء اصطناعي موزع Web3 عادل بالكامل؟ بصراحة، عندما رأيت هذا التصميم لأول مرة، كدت أصفق له واقفًا. لكن على وجه التحديد لأن هذا البناء متماسك منطقيًا إلى هذا الحد، وجدت نفسي في الأيام التالية، كلما كشفت طبقة جديدة من المخاطر، أشعر بألم أشد، كأنني أُحرق من الداخل.
“الظل الليلي” وما يكشفه من ثغرة قاتلة: الإجماع اللامركزي عاجز عن صدّ “تسميم البيانات”
لطالما أكدت OpenLedger أن Datanets الخاصة بها قادرة على إنتاج مواد تدريب عالية الجودة. لكن هنا توجد مفارقة منطقية هائلة، تكاد تكون مستعصية على الحل: فآلية الإجماع في الشبكات اللامركزية لا تستطيع سوى التحقق مما إذا كانت البيانات قد “توافقت” أم لا، لكنها لا تستطيع أبدًا التحقق من “الصحة المطلقة” للبيانات في العالم الفيزيائي.
في وقت مبكر من عام 2023، أحدثت أداة التسميم العدائي للذكاء الاصطناعي المعروفة باسم Nightshade (الظل الليلي)، والتي أُطلقَت من قبل فريق في جامعة شيكاغو، ضجة كبيرة في أوساط المهوسين. انظر الصورة أدناه. تكمن رعب هذه الأداة في قدرتها على إجراء تعديلات على مستوى البكسل في الصور أو النصوص بطريقة لا يمكن للعين المجردة ملاحظتها. أنت ترى قطة، لكن المتجهات الداخلية للنموذج تعرّفها على أنها كلب.
والآن، إذا أدخلنا هذه الأداة المرعبة إلى الشبكة الموزعة لـ OpenLedger، فماذا سيحدث؟
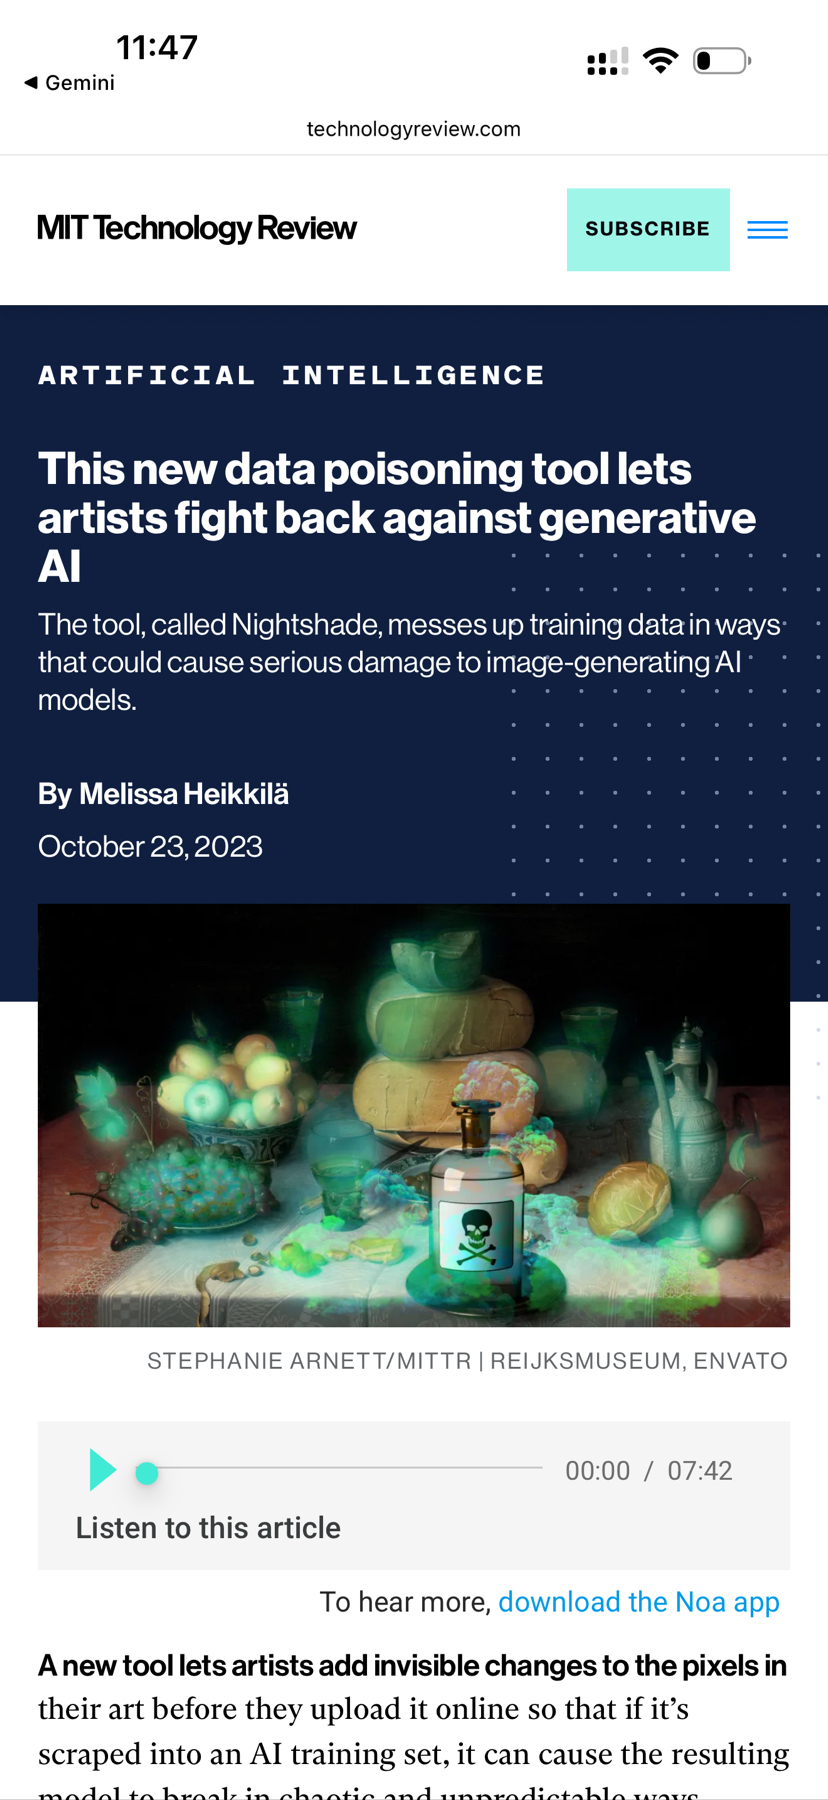
في شبكة لامركزية بلا إذن، يمكن لأي عقدة أن ترسل بيانات. وإذا قام تنظيم هاكر خبيث، أو منافس، باستخدام أداة شبيهة بـ Nightshade لتسميم كميات هائلة من البيانات “تسميمًا خفيًا”، ثم رفعها عبر عشرات الآلاف من العقد المجهولة إلى شبكة OpenLedger، فإن خوارزمية الإجماع في الشبكة لن تفعل سوى مقارنة بصمة هذه البيانات أو توافق تنسيقها مع القواعد، وقد تصوّت العقد نفسها لهذه “البيانات السامة” لصالحها لأنها تتفق في المصلحة. فما النتيجة؟ حالما يشتري نموذج الذكاء الاصطناعي المؤسسي B هذه البيانات الملوثة الموزعة، ستتعرض أوزان الشبكة العصبية بأكملها لضرر مدمّر، وهذا ما يُسمى في تعلم الآلة “انهيار النموذج (Model Collapse)”.
في الشركات المركزية التقليدية العملاقة، تكون عملية تنظيف البيانات محاطة بآليات صارمة للعزل الداخلي وتحديد المسؤولية؛ أما في هذه الشبكة الموزعة بالكامل، فمن سيتحمل مسؤولية “التسميم”؟ إذا لم يكن بإمكاننا ضمان “نقاء” البيانات بنسبة 100% على المستوى الهندسي، فأي يونيكورن ذكاء اصطناعي بقيمة عشرات المليارات سيجرؤ على إيداع شريان حياته، أي نموذجه الضخم، لدى شبكة مجهولة قد تُسمَّم في أي لحظة؟ عندما أفكر في ذلك، ألتقط أنفاسي فعلًا. ما يسمى بـ“تحديد ملكية البيانات” يفترض أولًا أن تكون البيانات أصلًا “بيانات جيدة”. وإذا لم نتمكن من صدّ التسميم العدائي، فكل ما تنتجه هذه الشبكة ليس سوى نفايات رقمية باهظة الثمن.
اللعنة الفيزيائية لتذبذب الكمون (Jitter): كابوس خطوط الذكاء الاصطناعي المؤسسية
النقطة الثانية التي حطمت دفاعي النفسي كانت الجدار المادي الصلب والواقعي للغاية الخاص بالعتاد. فإذا كنت تتابع ديناميات وادي السيليكون مؤخرًا، فستعرف أن أنظمة مثل Groq، المصممة خصيصًا لاستدلال الذكاء الاصطناعي، أي LPU (وحدة معالجة اللغة)، أو معمارية Blackwell الأحدث من Nvidia، كلها تتسابق بجنون على مؤشر واحد: الكمون المنخفض جدًا والتماسك العالي جدًا في تدفق البيانات. إن خط معالجة البيانات (Pipeline) في الذكاء الاصطناعي التجاري الحديث يتطلب أن يصل زمن النقل بين قاعدة البيانات المتجهية ووحدات الحوسبة إلى مستوى الميكروثانية. فما نوع الشبكة التي تحاول OpenLedger بناءها؟ إنها تريد الاعتماد على أطراف منتشرة في أنحاء العالم، تختلف بيئاتها الشبكية اختلافًا شاسعًا، لتنفيذ التنظيف الموزع للبيانات ومعالجتها إلى متجهات.
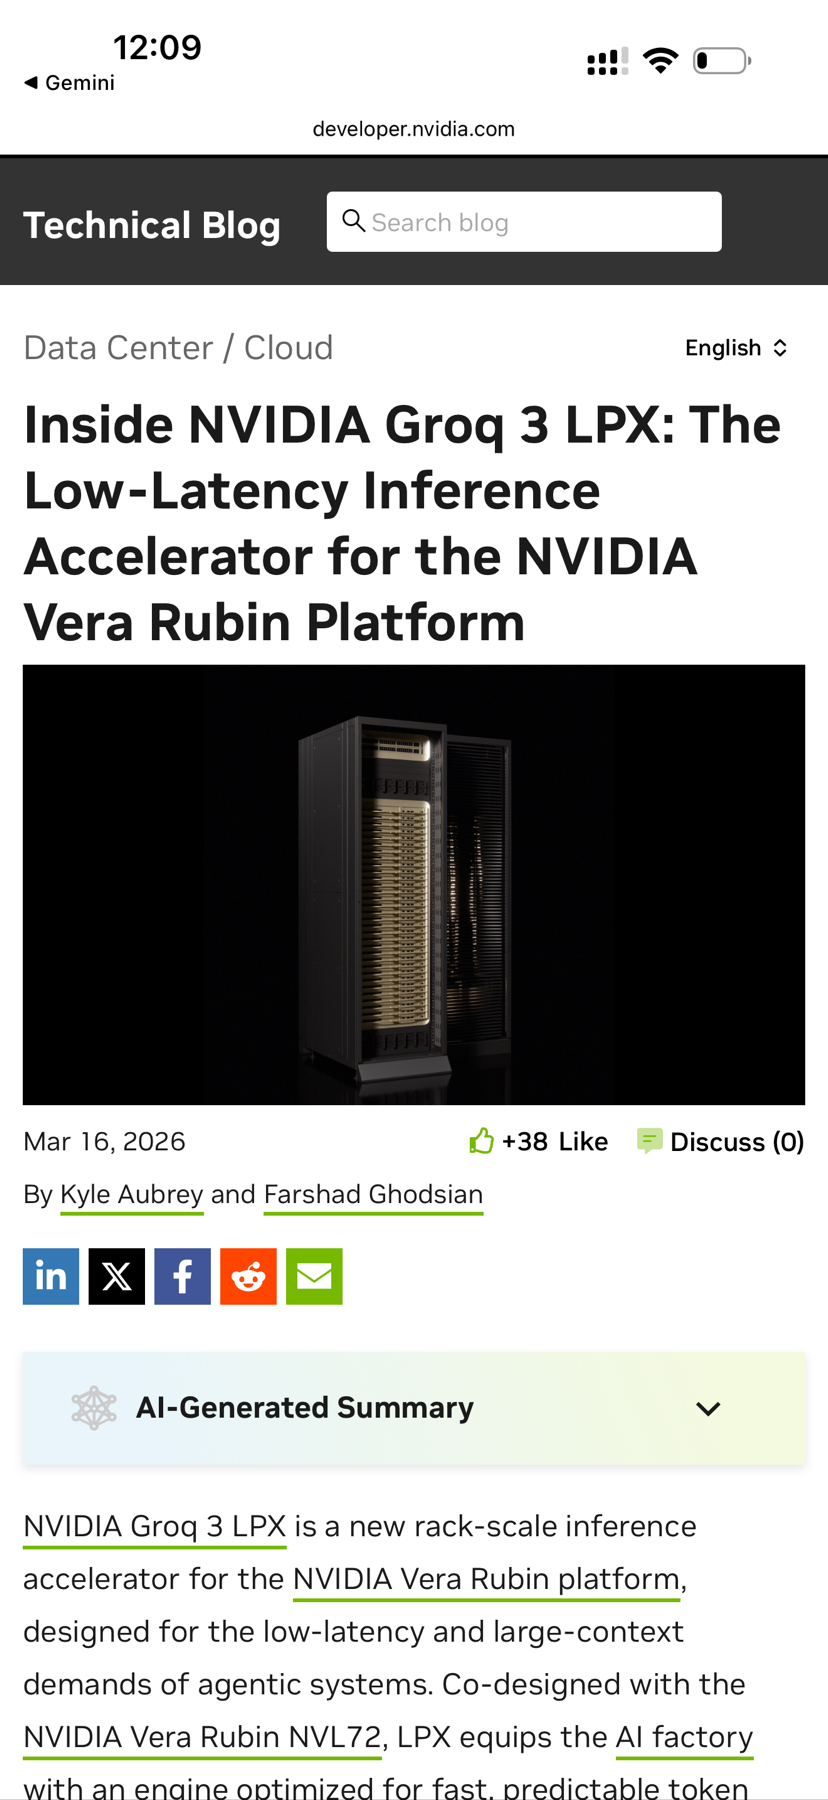
لقد ناقشت هذا المجال بعمق مع زميل سابق في العمليات لديه خبرة فعلية في النشر السحابي الأصلي، وعندما رأيت هذه المعمارية شعرت بأنها عبثية بحق. إذا صادف أن عقدتك في اليابان واجهت ازدحامًا شبكيًا، أو إذا انخفضت سرعة النطاق الترددي لعقدة في الشرق الأوسط اليوم، فإن “تذبذب الكمون (Jitter)” في سلسلة معالجة البيانات سيقفز فورًا. وبالنسبة لتطبيقات الذكاء الاصطناعي المؤسسية من الفئة B التي تتطلب استقرارًا مطلقًا واستجابة آنية، فإن مثل هذه التأخيرات في النقل وفقدان الحزم، التي قد تصل إلى مئات المللي ثانية أو حتى ثوانٍ، هي كارثة غير مقبولة هندسيًا على الإطلاق. إنهم يحاولون، باسم “اللامركزية” و”الصواب السياسي”، تحدّي قوانين الفيزياء الخاصة بسرعة الانتشار وطوبولوجيا الشبكات. هذا يشبه تمامًا أن تصر على سحب محرّك بوينغ 747 يحتاج إلى معدل تزامن بالغ الارتفاع بواسطة عشرة آلاف جرار يدوي مُركّب معًا. الفكرة مثيرة، لكن التنفيذ قاسٍ ومخيب.
عندما جمعت هذين المأزقين الفيزيائيين معًا، اختفت حالة الإعجاب الأولى وحلّت محلها عقلانية باردة إلى حدٍّ يكاد يكون متجمّدًا.
الكلفة الخفية لعناوين IP الخاصة بالمستخدمين العاديين
في أثناء تحوّل المشاعر تدريجيًا نحو الهدوء، هناك بُعد آخر لا بد أن أذكره مجددًا، وهو الحصار على المستوى الفيزيائي الذي وقع بالفعل في العالم الحقيقي ضد جمع البيانات اللامركزية.
باختصار، عندما تلامس عقدة النطاق المنزلي جدار حماية الموقع المستهدف دون علمها، فإن عنوان IP السكني يُوسَم فورًا من قبل شبكات CDN الدولية باعتباره “مصدر هجوم خبيث”. وهذه الضربة القاسية أصابت مباشرةً الشعيرات الدموية التي تعتمد عليها شبكة OpenLedger للبقاء، وألقت بظلال كثيفة على السردية القائلة بأن “الجميع يساهم والجميع يستفيد”.
غياب الحلقة التجارية المغلقة: من سيدفع ثمن “الاستعراض على السلسلة” تحت ظل قانون الاتحاد الأوروبي للذكاء الاصطناعي؟
والأكثر إحباطًا أن آلية الإتاوات التلقائية هذه منفصلة تمامًا عن منطق القانون والشراء التجاري في العالم الواقعي. يجب أن نعترف بحقيقة قاسية للغاية: إن “حقوق النشر” و”الإتاوات” التي تعرّفها الشبكات اللامركزية لا تمتلك، داخل المجال القانوني لعمالقة الذكاء الاصطناعي في Web2، أي قدرة إلزامية على استرداد الرسوم أو أي قدرة على حمل الامتثال. وفي عام 2026، كانت الاستراتيجية القانونية الأساسية لشركات مثل OpenAI وMeta قد تطورت بالفعل إلى رفع راية “الاستخدام العادل (Fair Use)” عاليًا، أو إلى توقيع اتفاقيات ترخيص بيانات سوداء الصندوق وحصرية مع مجموعات إعلامية كبرى. هؤلاء العمالقة من فئة B، الذين يملكون الكلمة الفصل في الصناعة، لا يجدون أي دافع تجاري للتعامل مع بروتوكول لتسوية الإتاوات اللامركزية، مكوّن من مستخدمين عاديين مجهولين من جميع أنحاء العالم ويقع ضمن منطقة رمادية قانونيًا. ومن دون انضمام هؤلاء المشترين الأكبر، لن تتحول آلية دفع الإتاوات التلقائية في OpenLedger في النهاية إلا إلى “استعراض على السلسلة” يمارسه المطورون داخل المنظومة مع أنفسهم فقط.
وعلى سبيل المثال، ووفقًا لتغطية موثوقة من رويترز (Reuters)، فقد أبرمت Google وReddit أيضًا في عام 2024 اتفاقية بيانات ذكاء اصطناعي بقيمة 60 مليون دولار سنويًا.
ثم إن ستار التنظيم الأوروبي الحديدي جعل هذا الطريق الضيق أصلًا شبه مغلق بالكامل. ومع التنفيذ التدريجي لـ قانون الذكاء الاصطناعي في الاتحاد الأوروبي (EU AI Act)، ارتفع “نقاء” بيانات تدريب النماذج الضخمة إلى مستوى سياسي وقانوني غير مسبوق. ووفقًا لمتطلبات التنفيذ المرحلية، فمنذ أغسطس 2025 يجب على مزوّدي النماذج العامة للذكاء الاصطناعي نشر ملخص “تفصيلي بما يكفي” لمحتوى بيانات التدريب، مع تطبيق صارم لاستراتيجيات حوكمة البيانات والامتثال لحقوق النشر؛ أما أنظمة الذكاء الاصطناعي عالية المخاطر فيُطلب أن تكون مدخلات بياناتها قابلة للتتبع، وخالية من التحيز، وخالية من الانتهاكات. ومؤخرًا، طلبت المفوضية الأوروبية بوضوح من جميع شركات النماذج الأساسية العاملة داخل الاتحاد تقديم تقارير تدقيق عن مصادر جمع البيانات وعمليات التنظيف، وأي بيانات مجهولة المصدر أو تنطوي على مخاطر انتهاك محتملة قد تؤدي إلى سحب النموذج بالكامل من السوق.
في ظل هذا المطلب الصارم تقريبًا المتعلق بسلسلة نسب البيانات (Data Lineage)، وقعت Datanets الخاصة بـ OpenLedger في فخ كل مطب تقريبًا. فأنبوبها الموزع يعتمد على آلاف العقد المنتشرة عالميًا وغير الموثقة عبر KYC للتحميل والتنظيف الأولي، وحتى لو خلطت عقدة واحدة فقط كمية صغيرة من “البيانات السامة” المحمية عمدًا، فإن امتثال مجموعة البيانات بأكملها على السلسلة سينهار فورًا. لا توجد شركة ذكاء اصطناعي تجارية واحدة ستجازف بنموذجها الضخم، الذي استثمرت فيه مئات الملايين ويحمِل أعمالها الأساسية، عبر المراهنة على نقاء البيانات في شبكة مجهولة. مهما كانت مثالية اللامركزية نبيلة، فإن أي “إجماع مجتمعي” لا يمكنه، أمام تقارير التدقيق الامتثالي الباردة، أن يحل محل الحجية القانونية لتحديد الملكية عبر القوائم البيضاء.
الخاتمة | نُبقي الشعلة حيّة، لكننا لن ندفع بعد الآن ثمن المآزق الفيزيائية والوهم التجاري
لا يزال المطر يتساقط خارج النافذة، وقد برد القهوة في الكوب منذ زمن. أنا لا أكره فريق OpenLedger، بل على العكس، أنا من أشدّ الداعمين لـ DeAI، وأعترف أيضًا بأن معمارية OpenLoRA حققت اختراقًا هندسيًا في كفاءة النشر على بطاقة GPU واحدة، فضلًا عن استشراف المؤسس Pryce Adade-Yebesi في الرؤية. لكن حين نزيل كل هذه الأغطية اللامعة، أرى إجماعًا هشًا عاجزًا تمامًا أمام تسميم البيانات العدائي، وبنية تحتية لا تصمد أمام متطلبات الكمون الفائق لتطبيقات الذكاء الاصطناعي المؤسسية، ونموذجًا تجاريًا لا يجد أي نقطة ارتكاز بين قوانين حقوق النشر الواقعية واستراتيجيات الشراء لدى العمالقة. هذا ليس نابعًا من يأسٍ تجاه مسار DeAI+DePIN، بل على العكس تمامًا؛ فأنا أتمنى لهذا المسار أن ينجو إلى حدّ أنني لم أعد أحتمل أن يقف أي مشروع، في غياب مشترٍ تجاري، وغياب الإعفاء القانوني، وغياب حماية حقيقية للملكية الفكرية، ليجعل عقد المنازل للمستخدمين وعناوين IP الخاصة بهم في الصف الأول لصدّ غضب العمالقة.
قبل أن تتمكن الجهة الرسمية من تقديم تقرير حقيقي، خضع لتدقيق من مؤسسة أمنية مستقلة تابعة لطرف ثالث، يثبت بوضوح “مقاومة تسميم البيانات (Anti-Data Poisoning)” عبر اختبار ضغط، ويثبت أن زمن تأخير الشبكة يمكنه تلبية احتياجات الاسترجاع المتجهي الصناعي، ويقدم أيضًا تقريرًا ماليًا حقيقيًا يثبت التوصل إلى أوامر شراء متوافقة مع كبرى شركات الذكاء الاصطناعي من عالم Web2، فسأخفض مستوى توقعاتي إلى الصفر تقريبًا. أي مخطط عن “إتاوات تلقائية بقيمة تريليونات” يجب، في نظري، أن يُخصم منه هامش المخاطر المستحق. حافظ على الحد الأدنى من المشاركة، وأبقِ الشعلة حيّة، لكن لا توسّع أبدًا نطاق تعرّض الأصول للمخاطر بشكل أعمى — ففي هذا الشهر المليء بشراك السرديات، قد يكون الاحتفاظ بقدرٍ من قسوة وعقلانية الرجل التقني هو الكرامة الوحيدة التي يمكن أن نمنحها لأنفسنا.
أغلقت الشاشة، لكن ذلك البرد لم يزُل طويلًا.