

فيه شي تقريبًا ما حدا عم يسأل عنه لحد هلا:
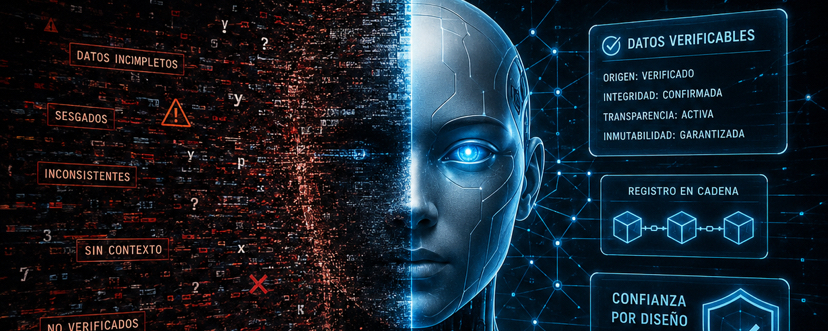
شو الفايدة من وجود ذكاء اصطناعي متقدم إذا ما منعرف من وين جايبين بياناته؟
اليوم عايشين في زمن غريب.
منشوف صور بتبين حقيقية، بس هي مش هيك.
منقرأ أخبار ممكن تكون متلاعب فيها.
منسمع آراء يمكن جاي من بوتات.
ومنستخدم أدوات ذكاء اصطناعي من دون ما نعرف بالضبط شو المعلومات وراها.
المشكلة ما بقت بس خلق تكنولوجيا أقوى.
المشكلة هي الثقة فيها.
وهنا تحديدًا تبدأ مشاريع مثل @OpenLedger بإيجاد معنى.
لا يبدو لي OpenLedger غير مثير للاهتمام فقط بسبب خلطه بين الذكاء الاصطناعي والبلوك تشين. تلك العبارة يستخدمها الجميع.
المثير للاهتمام هو الفكرة الكامنة في العمق:
👉 إذا كان الذكاء الاصطناعي يتغذى على بيانات، إذن البيانات تحتاج إلى طبقة ثقة.
لأن الذكاء الاصطناعي المُدرَّب على معلومات خاطئة قد يتخذ قرارات سيئة.
قد يعيد الذكاء الاصطناعي دون إمكانية تتبع الأخطاء.
قد يبدو الذكاء الاصطناعي دون شفافية ذكيًا… حتى لو كان مبنيًا على بيانات ضعيفة.
وفي عالم نعتمد فيه أكثر فأكثر على الذكاء الاصطناعي، قد يصبح ذلك مشكلة كبيرة جدًا.
السؤال الحقيقي ليس:
“أي ذكاء اصطناعي سيكون أسرع؟”
قد يكون السؤال الحقيقي:
“أي ذكاء اصطناعي يمكنه إثبات أن معلوماته موثوقة؟”
وهنا يمكن للبلوك تشين أن يلعب دورًا مهمًا:
التحقق، إمكانية التتبع، ملكية البيانات والشفافية.
لا أقول إنه @OpenLedger لديه كل شيء محلول. لا توجد أي مشاريع في كريبتو لديها ذلك.
لكن نعم، أعتقد أنه يلامس نقاشًا قد يكبر جدًا:
الثقة في الذكاء الاصطناعي.
ربما بعد بضع سنوات لن نقيم فقط النماذج الأكثر قوة.
ربما سنقيّم النماذج التي يمكنها إثبات من أين تأتي معرفتها.
وإذا حدث ذلك، فقد تتحول المشاريع التي تعمل على بيانات قابلة للتحقق من كونها مُتجاهَلة إلى أن تصبح أساسية.
لأن الذكاء الاصطناعي دون بيانات موثوقة ليس ذكاءً.
ضجيج بمظهر جيد.