🤔 هل تبني OpenLedger طبقة المساءلة التي ستحتاجها وكلاء الذكاء الاصطناعي في المستقبل؟
الجميع متحمس لوكلاء الذكاء الاصطناعي.
يمكن لوكلاء الذكاء الاصطناعي أن يتداولوا.
يمكن لوكلاء الذكاء الاصطناعي أن يحللوا.
يمكن لوكلاء الذكاء الاصطناعي أن يقوموا بأتمتة المهام.
لكن هناك سؤال غير مريح يتزايد:
عندما يتخذ وكيل الذكاء الاصطناعي قرارًا، من يحصل على الفضل، من يتقاضى الأجر، ومن يتحمل المسؤولية؟ 🤨
هذا بالضبط هو المكان الذي تتبنى فيه OpenLedger نهجًا مختلفًا جدًا عن معظم مشاريع الذكاء الاصطناعي.
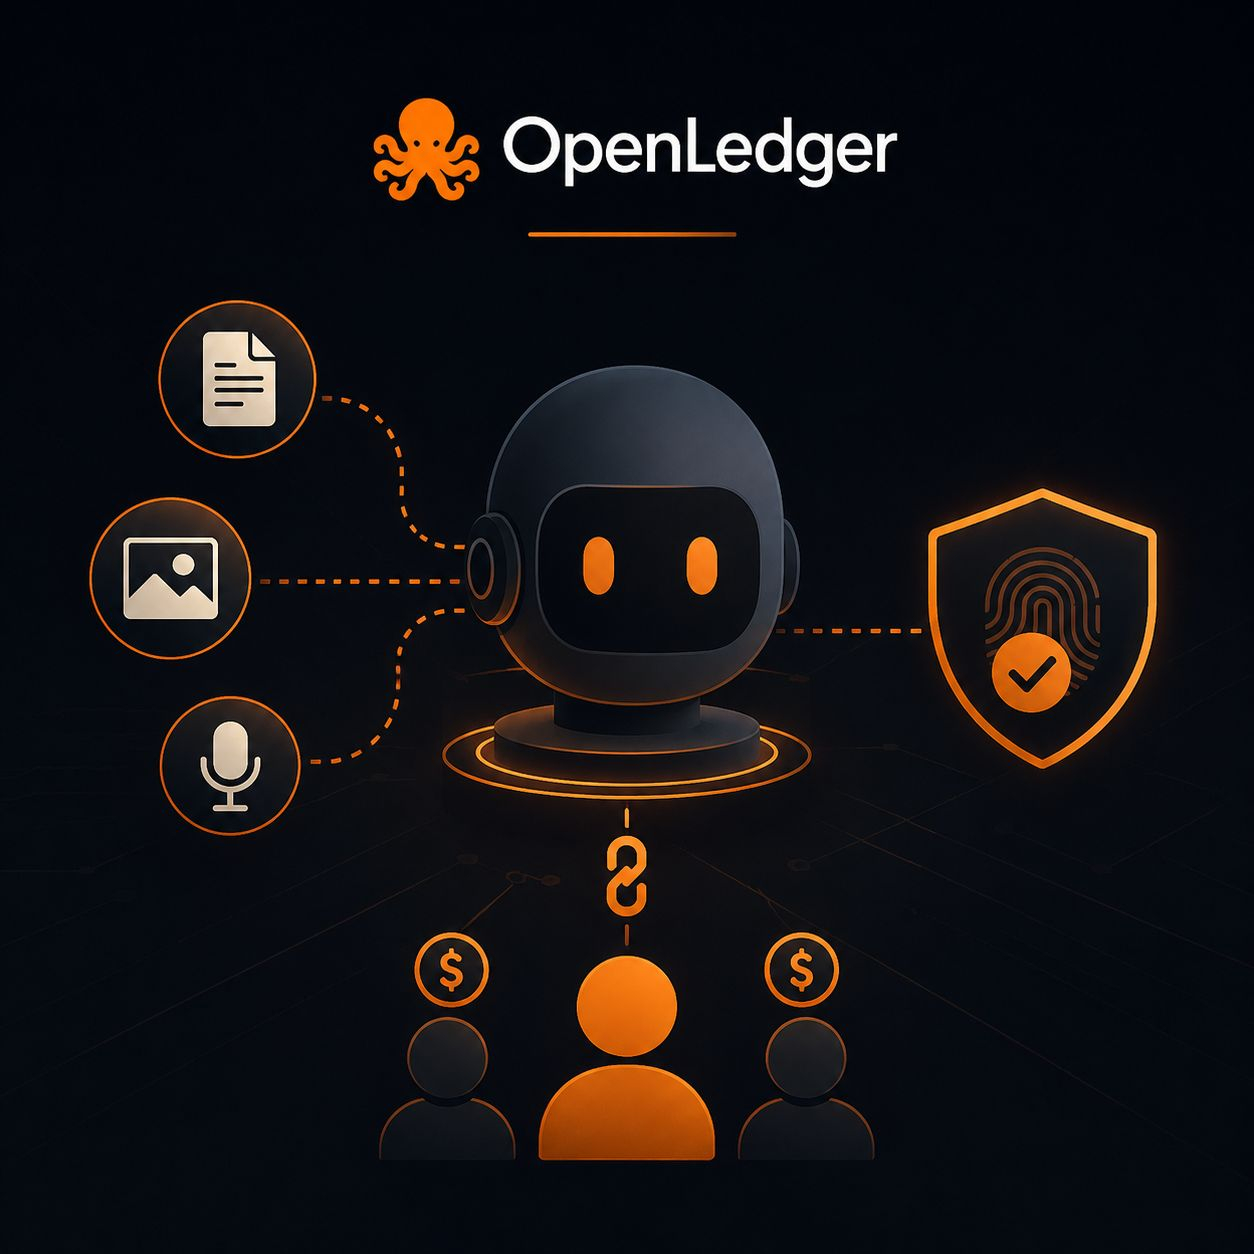
بدلاً من التركيز فقط على بناء ذكاء اصطناعي أكثر ذكاءً، تقوم OpenLedger ببناء البنية التحتية التي تجعل الذكاء الاصطناعي شفافًا وقابلًا للتتبع وقابلًا للمساءلة اقتصاديًا من خلال إطار عملها لإثبات النسبة. 🚀
فكر في نظام الذكاء الاصطناعي اليوم.
تدخل البيانات إلى نموذج.
ينتج النموذج مخرجات.
يتم إنشاء قيمة.
لكن المساهمين الذين قدموا البيانات غالبًا ما يختفون من القصة.
تغير OpenLedger هذه السردية.
من خلال إثبات النسبة، يمكن لـ OpenLedger تتبع كيفية مساهمة البيانات في مخرجات الذكاء الاصطناعي وإنشاء سجلات نسبة قابلة للتحقق على السلسلة. هذا يعني أن المساهمين لم يعودوا مجرد مشاركين مجهولين بعد الآن—they become visible parts of the AI economy. ⚡
يصبح هذا أكثر أهمية مع بدء وكلاء الذكاء الاصطناعي في العمل بشكل مستقل.
تخيل وكيل ذكاء اصطناعي ينفذ صفقات، يقدم توصيات، أو ينفذ مهام تجارية.
بدون النسبة، يصبح تدقيق تلك القرارات أمرًا صعبًا.
بدون المساءلة، يصبح الثقة أمرًا صعبًا.
رؤية OpenLedger هي إنشاء نظام يصبح فيه الذكاء نفسه قابلاً للتتبع.
ليس فقط المخرجات.
الرحلة الكاملة وراء المخرجات.
وهنا يصبح مفهوم الذكاء الاصطناعي القابل للدفع مثيرًا للاهتمام.
إذا كانت البيانات تخلق قيمة، يجب أن يكون للمساهمين طريق إلى المكافآت.
إذا كانت حركة الذكاء الاصطناعي تولد إيرادات، يجب أن تساعد النسبة في تحديد من شارك في إنشاء تلك القيمة.
بطرق عديدة، لا تبني OpenLedger مجرد بنية تحتية للذكاء الاصطناعي.
😂 لأن دعنا نكون صريحين...
إذا أصبح وكيل الذكاء الاصطناعي مليونيرًا بينما الأشخاص الذين ساعدوا في تدريبه يحصلون على مكافأة إبهام افتراضي، فهناك شيء ما معطل على الأرجح.
@OpenLedger #OpenLedger $OPEN
الجميع متحمس لوكلاء الذكاء الاصطناعي.
يمكن لوكلاء الذكاء الاصطناعي أن يتداولوا.
يمكن لوكلاء الذكاء الاصطناعي أن يحللوا.
يمكن لوكلاء الذكاء الاصطناعي أن يقوموا بأتمتة المهام.
لكن هناك سؤال غير مريح يتزايد:
عندما يتخذ وكيل الذكاء الاصطناعي قرارًا، من يحصل على الفضل، من يتقاضى الأجر، ومن يتحمل المسؤولية؟ 🤨
هذا بالضبط هو المكان الذي تتبنى فيه OpenLedger نهجًا مختلفًا جدًا عن معظم مشاريع الذكاء الاصطناعي.
بدلاً من التركيز فقط على بناء ذكاء اصطناعي أكثر ذكاءً، تقوم OpenLedger ببناء البنية التحتية التي تجعل الذكاء الاصطناعي شفافًا وقابلًا للتتبع وقابلًا للمساءلة اقتصاديًا من خلال إطار عملها لإثبات النسبة. 🚀
فكر في نظام الذكاء الاصطناعي اليوم.
تدخل البيانات إلى نموذج.
ينتج النموذج مخرجات.
يتم إنشاء قيمة.
لكن المساهمين الذين قدموا البيانات غالبًا ما يختفون من القصة.
تغير OpenLedger هذه السردية.
من خلال إثبات النسبة، يمكن لـ OpenLedger تتبع كيفية مساهمة البيانات في مخرجات الذكاء الاصطناعي وإنشاء سجلات نسبة قابلة للتحقق على السلسلة. هذا يعني أن المساهمين لم يعودوا مجرد مشاركين مجهولين بعد الآن—they become visible parts of the AI economy. ⚡
يصبح هذا أكثر أهمية مع بدء وكلاء الذكاء الاصطناعي في العمل بشكل مستقل.
تخيل وكيل ذكاء اصطناعي ينفذ صفقات، يقدم توصيات، أو ينفذ مهام تجارية.
بدون النسبة، يصبح تدقيق تلك القرارات أمرًا صعبًا.
بدون المساءلة، يصبح الثقة أمرًا صعبًا.
رؤية OpenLedger هي إنشاء نظام يصبح فيه الذكاء نفسه قابلاً للتتبع.
ليس فقط المخرجات.
الرحلة الكاملة وراء المخرجات.
وهنا يصبح مفهوم الذكاء الاصطناعي القابل للدفع مثيرًا للاهتمام.
إذا كانت البيانات تخلق قيمة، يجب أن يكون للمساهمين طريق إلى المكافآت.
إذا كانت حركة الذكاء الاصطناعي تولد إيرادات، يجب أن تساعد النسبة في تحديد من شارك في إنشاء تلك القيمة.
بطرق عديدة، لا تبني OpenLedger مجرد بنية تحتية للذكاء الاصطناعي.
😂 لأن دعنا نكون صريحين...
إذا أصبح وكيل الذكاء الاصطناعي مليونيرًا بينما الأشخاص الذين ساعدوا في تدريبه يحصلون على مكافأة إبهام افتراضي، فهناك شيء ما معطل على الأرجح.
@OpenLedger #OpenLedger $OPEN