
الشيء الذي أدركته أثناء مشاهدة نمو الذكاء الاصطناعي هو أن المنافسة الحقيقية قد لا تتعلق بنموذج أكثر ذكاءً، أسرع، أو لديه المزيد من المعلمات.
هذه ببساطة هي الطبقة الأكثر وضوحًا.
يبدو أن السؤال الأعمق هو كيف يعيد الذكاء الاصطناعي تشكيل العلاقة بين البشر والمعرفة.
لسنوات، كانت الإنترنت بمثابة مستودع ضخم للمعلومات. كان الناس يبحثون عن المعرفة، وتساعدهم الأدوات في الوصول إليها، وتبقى القرارات النهائية في أيدي البشر.
لا تزال معظم منصات الذكاء الاصطناعي تتبع هذا النموذج.
يركزون على الإجابة عن الأسئلة وتحسين الدقة وتجميع المعلومات من مجموعات بيانات ضخمة. وفي كثير من النواحي، يحاولون أن يصبحوا محركات معرفة أقوى على نحو متزايد.
لكن كلما راقبت اقتصاد الذكاء الاصطناعي أكثر، شعرت أكثر بأن الذكاء نفسه ليس الاختناق الأساسي.
يبدو أن الجزء الناقص هو السياق.
لا تنشأ المعرفة بمعزل. بل تأتي من السلوك البشري والخبرات المعيشة، ومن لا حصر له من التفاعلات اليومية. قد يعرف النموذج تقريبًا كل ما هو متاح على الإنترنت، لكنه لا يفهم تلقائيًا كيف يصل الناس إلى قراراتهم.
وهنا تبرز OpenLedger بالنسبة لي.
بدلًا من التعامل مع الذكاء الاصطناعي كمسألة حسابية فقط، يبدو أن OpenLedger تركز على أصول الإشارات التي تشكل الذكاء.
قد يبدو هذا التمييز دقيقًا، لكنه يمس قضية أكبر بكثير.
لا يعاني عالم اليوم من نقص في البيانات. نحن نعيش في عصر وفرة بيانات ساحقة.
ما هو نادر حقًا هو البيانات ذات المعنى.
ينتج كل يوم مليارات من التفاعلات وعددًا لا يحصى من الإشارات الرقمية، ومع ذلك لا يعكس جزء صغير منها حقًا التفكير البشري. معظم الإشارات تلتقط ردود فعل أكثر من كونها تفكيرًا.
وهذا فرق مهم.
التفكير بطيء ومشروط بالسياق. أما ردود الفعل فهي سريعة وغالبًا ما تكون اندفاعية.
إذا تم تدريب أنظمة الذكاء الاصطناعي بشكل أساسي على ردود الفعل الجماعية، يظهر سؤال مثير للاهتمام: هل تتعلم الذكاء، أم أنها تتعلم فقط تكرار الأنماط الشائعة؟
قد يكون هذا أحد المفارقات المركزية لذكاء اصطناعي حديث.
لا يؤدي المزيد من البيانات تلقائيًا إلى فهم أكبر. ففي بعض الأحيان يؤدي ازدياد الحجم إلى تضخيم الضجيج أسرع من المعرفة.
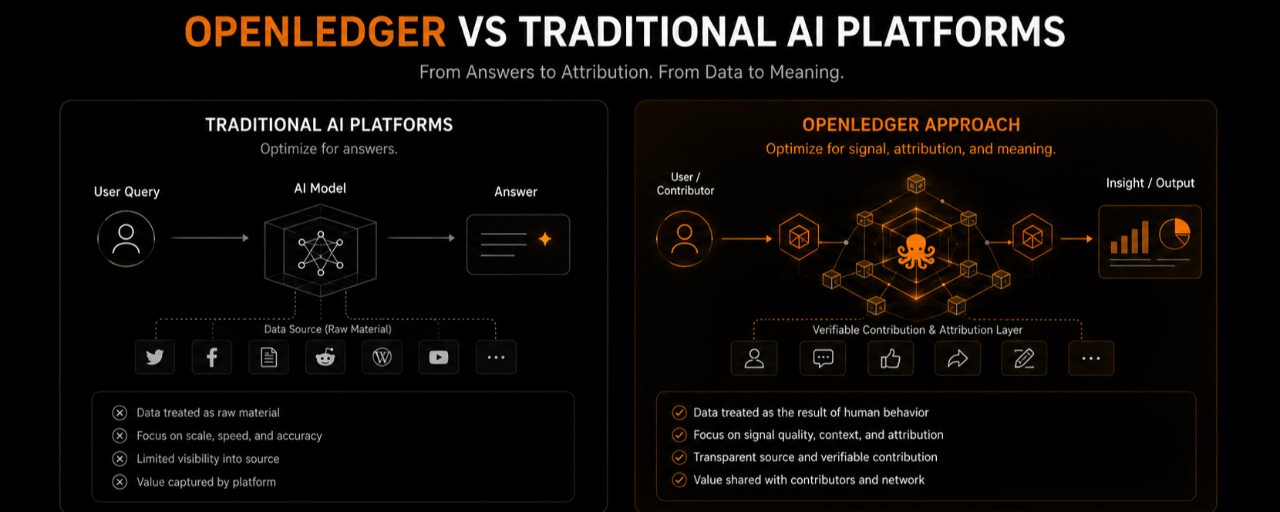
تقوم منصات الذكاء الاصطناعي التقليدية في الغالب بتحسين الوصول إلى المعلومات على نطاق واسع.
يبدو أن OpenLedger تستكشف كيفية تحديد وتتبّع وتقييم الإشارات التي تخلق تلك المعلومات في المقام الأول.
ومن خلال هذه العدسة، لا يتمثل الفرق في الجانب التقني فحسب—بل في الجانب الاقتصادي أيضًا.
يركز أحد الأساليب على الإجابات.
يركز الآخر على الأشخاص والسلوكيات التي تولد الإشارات خلف تلك الإجابات.
يرى أحدهم البيانات كمادة خام.
يرى الآخر البيانات ناتجة عن النشاط البشري والمشاركة الاقتصادية.
وعندما يبدأ اعتبار البيانات أصلًا يُنشئه الأفراد بدلًا من مورد يتم استخراجه بحرية، تبدأ كذلك بنية الحوافز المحيطة بالذكاء الاصطناعي في التغير.
تُظهر لنا التاريخ أن التحولات التكنولوجية الكبرى نادرًا ما تحدث فقط لأن الأدوات تصبح أقوى.
يحدث ذلك عندما يتغير سلوك الإنسان.
لم تحوّل الإنترنت المجتمع ليس فقط لأن المعلومات تحركت بسرعة أكبر. لم تُعد وسائل التواصل الاجتماعي تشكيلًا للثقافة لمجرد أن الناس صاروا قادرين على التواصل. وبالمثل، قد لا يغيّر الذكاء الاصطناعي العالم لمجرد أن النماذج تصبح أذكى.
السؤال الأكثر إثارة للاهتمام هو كيف يغيّر الذكاء الاصطناعي خلق القيمة وملكية القيمة وتوزيعها.
ما إذا كانت OpenLedger ستنجح في نهاية المطاف لا يزال غير معروف. ما زالت الصناعة في بداياتها، ويتم اختبار نماذج كثيرة منافسة.
لكن يبدو أن هناك اتجاهًا واحدًا واضحًا بشكل متزايد:
قد يعتمد مستقبل الذكاء الاصطناعي بدرجة أقل على من يملك أقوى نموذج، وأكثر على من يفهم أصول الذكاء الذي تتعلمه تلك النماذج.