

بينما كنت أتابع ارتفاع وكلاء الذكاء الاصطناعي، أدركت أن المنافسة الحقيقية قد لا تتعلق ببناء ذكاء أذكى على الإطلاق. يبدو أن التحدي الأكبر هو معرفة كيفية تنسيق البشر والتفاعل مع تلك الذكاء بشكل فعال.
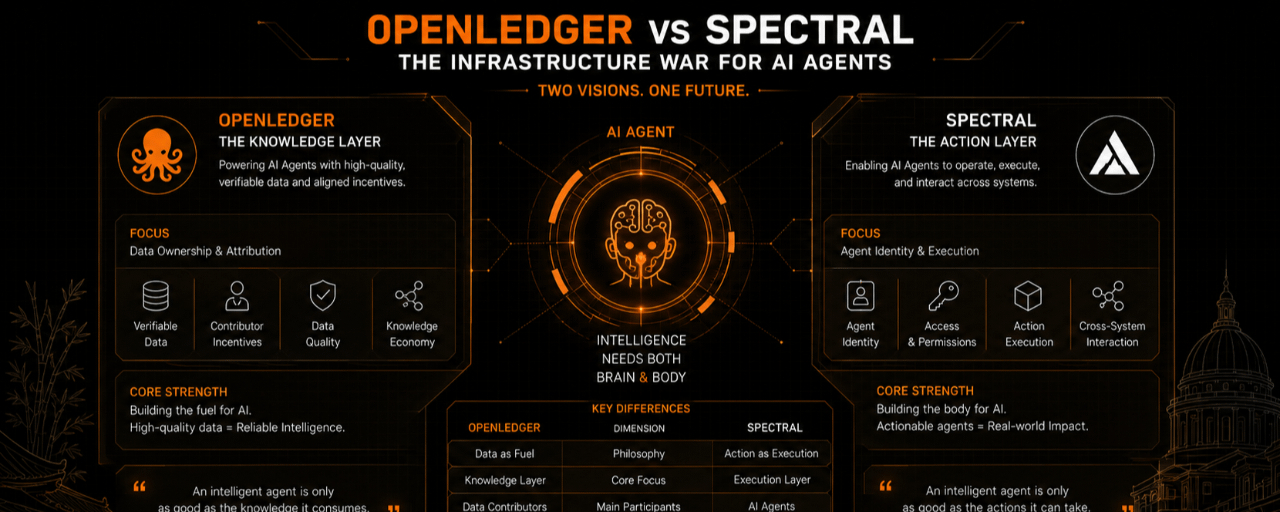
لهذا السبب أجد المقارنة بين OpenLedger و Spectral أكثر إثارة من المحادثات المعتادة حول النماذج أو الأداء أو اقتصاديات الرموز. يبدو أن كلا المشروعين يتعاملان مع بنية الذكاء الاصطناعي، ولكن من زوايا مختلفة تمامًا.
عند النظر إلى دورات التكنولوجيا السابقة، غالبًا ما يركّز الناس على الطبقة الأكثر وضوحًا. كان يُنظر إلى الإنترنت يومًا ما على أنه مجموعة من المواقع الإلكترونية، وإلى البلوكشين على أنه شبكة من الرموز، وغالبًا ما يُختزل الذكاء الاصطناعي اليوم في روبوتات الدردشة. ومع ذلك، فإن أكثر التغييرات تحولًا تحدث عادةً تحت السطح، داخل البنية التحتية التي نادرًا ما يلاحظها المستخدمون.
يبدو أن OpenLedger تنطلق من فكرة أن أكبر قيود الذكاء الاصطناعي ليست نقص النماذج، بل نقص البيانات المتخصصة عالية الجودة. ومن هذا المنظور، فإن التحدي أمام وكلاء الذكاء الاصطناعي يتعلق بدرجة أقل بالتفكير وبدرجة أكبر بجودة المعرفة ومصدرها.
حتى أكثر الوكلاء تقدمًا قد ينتج نتائج ضعيفة إذا اعتمد على بيانات مشوشة أو غير موثوقة أو سيئة التحفيز. فالاستخبارات وحدها لا يمكنها تعويض المدخلات الضعيفة.
ما يبرز في OpenLedger هو تركيزها على خلق حوافز اقتصادية حول المساهمة بالبيانات وملكيتها. ومن نواحٍ كثيرة، يبدو أنها تتعامل مع طبقة الوقود في الذكاء الاصطناعي.
أما Spectral، فمن ناحية أخرى، فتبدو وكأنها تركز على مشكلة مختلفة تمامًا: التنفيذ.
مع تطور وكلاء الذكاء الاصطناعي، يُتوقع منهم تنفيذ أفعال نيابةً عن المستخدمين. ولتحقيق ذلك، يحتاجون إلى الهوية، والصلاحيات، والسياق السلوكي، والقدرة على التفاعل عبر أنظمة وبيئات مختلفة.
إذا كانت OpenLedger ترى الذكاء الاصطناعي كعقل يتطلب معرفة، فإن Spectral تبدو وكأنها ترى الذكاء الاصطناعي ككيان رقمي يحتاج إلى الأدوات والاستقلالية ليعمل.
وعلى الرغم من أن هذه المقاربات قد تبدو متشابهة على السطح، فإنها تعكس رؤيتين مختلفتين جذريًا للمستقبل. إحداهما تعطي الأولوية للجودة المعرفية، بينما الأخرى تعطي الأولوية لقدرة التنفيذ.
هذا يسلّط الضوء على مفارقة مألوفة في التكنولوجيا. فنحن نفترض غالبًا أن القرارات الجيدة تؤدي طبيعيًا إلى نتائج جيدة، لكن كثيرًا من الأنظمة تفشل بسبب الفجوة بين معرفة ما ينبغي فعله وبين فعله بالفعل.
قد يفهم وكيل الذكاء الاصطناعي المسار الصحيح للعمل لكنه يواجه صعوبة في تنفيذه. وعلى العكس، قد يمتلك الوكيل قدرات تشغيلية واسعة لكنه يفتقر إلى الفهم الكافي لاتخاذ القرارات الصحيحة.
ربما يكون هذا هو التوتر الأساسي الذي يظهر داخل مشهد وكلاء الذكاء الاصطناعي.
قد لا تكون المنافسة حول إنشاء أذكى وكيل. بل قد تكون حول بناء البنية التحتية التي تجعل الذكاء مفيدًا حقًا في البيئات الواقعية.
ما يثير اهتمامي هو أن كلاً من OpenLedger وSpectral تعملان على طبقات لا يلاحظها معظم المستخدمين إلا نادرًا. تاريخيًا، كانت هذه الطبقات الخفية غالبًا هي المكان الذي تبدأ فيه أكبر التحولات التكنولوجية.
ليس عند الواجهة.
ليس في الميزات.
بل في عمق الأنظمة الأساسية التي تشكّل بصمت كيف يفكر الناس ويقررون ويتصرفون.
هل سيُفضّل المستقبل المنصات التي تحل ملكية البيانات ونِسبة المعرفة، أم تلك التي تمكّن الوكلاء من تنفيذ الأفعال بفاعلية أكبر؟
في الوقت الحالي، يبقى الجواب غير محسوم.
لأن وكلاء الذكاء الاصطناعي قد يحتاجون إلى أكثر من مجرد عقل.
قد يحتاجون أيضًا إلى جسد.
ولا يزال السوق يحاول تحديد أيٍّ من هذين يشكّل عنق الزجاجة الأكبر.