


لما بشوف OpenLedger، بفكر أقل في البلوكشين وأكثر في مشكلة عم تكبر بهدوء تحت سطح الاقتصاد الرقمي لسنين.
أعتقد إننا وصلنا لنقطة صار فيها البيانات واحدة من أغلى الموارد بالعالم، ومع ذلك العلاقة بين اللي بيخلقوا البيانات واللي بيستفيدوا منها لا تزال مفصولة بشكل مفاجئ. كل يوم، الناس يولدوا كميات هائلة من المعلومات من خلال المحادثات، التطبيقات، المعاملات، البحث، والنشاطات على الإنترنت. هالبيانات بتغذي أنظمة الذكاء الاصطناعي، وبتحسن النماذج، وبتساعد الشركات على بناء منتجات أقوى بشكل متزايد. ومع ذلك، معظم المساهمين نادراً ما يشاركوا في القيمة اللي بتظهر من مساهماتهم.
ما يثير اهتمامي هو أن هذه الفجوة لم تحدث لأن شخصًا ما صممها عمدًا بهذه الطريقة. من نواحٍ عديدة، هي ببساطة نتيجة لكيفية تطور الإنترنت. أصبحت المنصات المركزية أماكن فعالة لجمع وتنظيم وتحقيق المعلومات. مع مرور الوقت، أصبحت ملكية البيانات، وملكية البنية التحتية، والتقاط القيمة مركزة في نفس الأماكن.
بينما يصبح الذكاء الاصطناعي أكثر أهمية، أعتقد أن هذه المشكلة تصبح أكثر صعوبة في التغاضي عنها.
تعتمد النماذج الذكية على مجموعات بيانات ضخمة. تأتي تلك المجموعات من عدد لا يحصى من الأفراد والشركات والتطبيقات والأنظمة. يساهم مطوروا النماذج بالخبرة والابتكار. يقدم المستخدمون ملاحظات تحسن الأداء. ومع ذلك، على الرغم من عدد المشاركين المعنيين، غالبًا ما يشعر الهيكل الاقتصادي بأنه ضيق بشكل مدهش.
كلما درست هذا المجال أكثر، شعرت أن التحدي ليس تقنيًا فقط. إنه أيضًا اقتصادي.
السؤال لم يعد فقط كيف نبني ذكاءً صناعيًا أفضل. السؤال هو كيف نبني أنظمة تنسق بشكل عادل بين الناس والبيانات والنماذج والجهات التي تجعل الذكاء الاصطناعي ممكنًا في المقام الأول.
هنا حيث لفتت OpenLedger انتباهي.
بدلاً من التركيز حصريًا على أداء النموذج أو القوة الحاسوبية، أرى أن OpenLedger تحاول معالجة قضية هيكلية أعمق. يبدو أن المشروع يبدأ بفكرة بسيطة نسبيًا: إذا كانت البيانات، والنماذج الذكية، والجهات المستقلة تصبح أصولًا رقمية منتجة، فربما تحتاج إلى بنية تحتية قادرة على تتبع المساهمات وتوزيع القيمة بشكل أكثر شفافية.
أجد أن هذه النظرة مثيرة للاهتمام لأنها تحول المحادثة بعيدًا عن التكنولوجيا البحتة نحو تصميم الحوافز.
في معظم مناقشات الذكاء الاصطناعي، تُعتبر البيانات مادة خام. تدخل النظام، تساهم في التدريب، ثم تختفي بشكل كبير من العرض. غالبًا ما يصبح الاتصال بين المساهم الأصلي والقيمة المستقبلية الناتجة عن تلك البيانات غير ممكن قياسه.
يبدو أن OpenLedger تستكشف نهجًا بديلًا.
عندما أقرأ عن المشروع، لا أرى أنه يحاول وضع البيانات كمدخل سلبي. بدلاً من ذلك، أرى محاولة لمعالجة البيانات كأصل اقتصادي يمكن أن يستمر في توليد القيمة ضمن شبكة أوسع. الفكرة تبدو أنه إذا كانت المساهمات يمكن تحديدها ونسبها، فإن المكافآت يمكن توزيعها بشكل أكثر فعالية.
للوهلة الأولى، يبدو أن هذا بسيط.
كلما فكرت في الأمر، أصبح أكثر تعقيدًا.
قياس المساهمة داخل أنظمة الذكاء الاصطناعي ليس سهلًا. نادرًا ما تخلق البيانات قيمة بمفردها. قد يعتمد النموذج على آلاف مجموعات البيانات. قد يؤثر العديد من المساهمين على النتائج في وقت واحد. غالبًا ما تتغير فائدة المعلومات مع مرور الوقت.
بسبب ذلك، أعتقد أن التحدي الحقيقي الذي يواجه OpenLedger ليس ما إذا كان يمكن للبلوكشين تسجيل المعاملات. التحدي الحقيقي هو ما إذا كان يمكن قياس المساهمة نفسها بطريقة ذات مغزى.
هذا التمييز مهم.
تركز العديد من مشاريع البلوكشين على إنشاء البنية التحتية. يبدو أن OpenLedger تطرح سؤالًا مختلفًا: كيف يمكن أن تدعم البنية التحتية نسبة الاقتصاد عبر نظم الذكاء الاصطناعي؟
أجد أن هذا السؤال مثير للاهتمام بشكل ملحوظ.
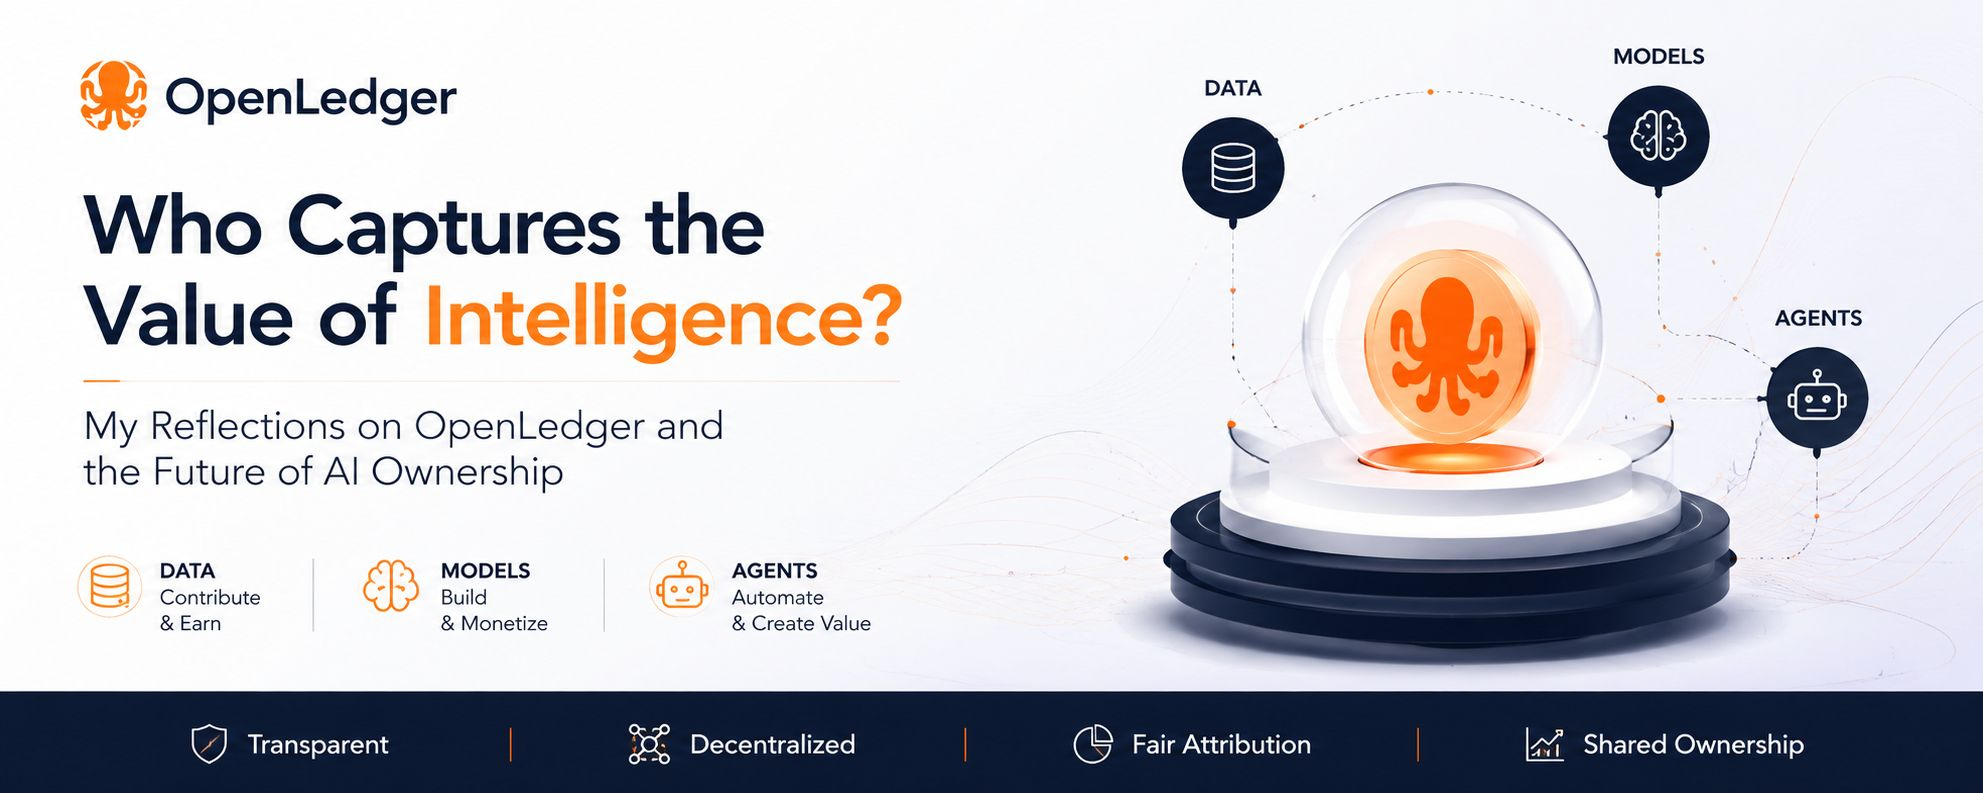
عندما أعود خطوة وأنظر إلى الصورة الأكبر، أرى أن تطوير الذكاء الاصطناعي هو عملية مترابطة للغاية. يقوم مزودو البيانات بإنشاء الموارد. يبني المطورون النماذج. تقدم التطبيقات الفائدة. يولد المستخدمون الملاحظات. تؤدي الجهات المستقلة بشكل متزايد مهامًا نيابة عن الأشخاص والمنظمات.
لا تعمل أي من هذه المكونات بشكل مستقل.
تظهر القيمة التي ينتجها النظام من التفاعلات بينهم.
ما أعتقد أن OpenLedger تحاول القيام به هو خلق بيئة حيث تصبح تلك التفاعلات مرئية اقتصاديًا. بدلاً من معالجة البيانات والنماذج والجهات كعوالم منفصلة، يبدو أن المشروع يستكشف طرقًا لربطها من خلال إطار مشترك.
إذا نجح الأمر، فقد يقلل ذلك من واحدة من أكبر عدم الكفاءة في اقتصاد الذكاء الاصطناعي اليوم: الانفصال بين المساهمة والتعويض.
بالطبع، أعتقد أيضًا أنه من المهم أن نكون واقعيين.
تظهر التاريخ أن أنظمة الحوافز صعبة التصميم بشكل لا يصدق. من السهل إنشاء المكافآت. لكن إنشاء مكافآت مستدامة أصعب بكثير.
كلما تم تقديم حوافز اقتصادية، يتكيف المشاركون بطبيعتهم مع سلوكهم حولها. يساهم البعض بقيمة حقيقية. بينما يقوم الآخرون بتحسين مكافآتهم. مع مرور الوقت، يجب على الأنظمة أن توازن باستمرار بين الانفتاح والجودة والعدالة والكفاءة.
هذه هي الأسباب التي تجعل مستقبل OpenLedger يعتمد على الاقتصاد بقدر ما يعتمد على التكنولوجيا.
قد تعمل البنية التحتية بشكل مثالي، ولكن إذا تشوهت الحوافز، فقد يكافح النظام. بالمقابل، إذا ظلت الحوافز متوافقة، فقد يجذب الشبكة مساهمات ذات قيمة متزايدة مع مرور الوقت.
جانب آخر يبقيني أفكر هو فكرة السيولة.
غالبًا ما أشعر أن الكثير من اقتصاد الذكاء الاصطناعي يحتوي على أصول قيمة ولكن يصعب تحقيقها مباشرة. تمتلك البيانات قيمة ولكن غالبًا ما تفتقر إلى الأسواق الفعالة. تنشئ النماذج فائدة ولكن قد تكافح لالتقاط المشاركة الاقتصادية المستمرة. يمكن للجهات المستقلة أداء عمل مفيد ولكن غالبًا ما تعمل ضمن أطر اقتصادية محدودة.
يبدو أن OpenLedger تستكشف طرقًا لجعل هذه الأصول أكثر نشاطًا اقتصاديًا.
أفكر في الأمر وكأنه تحويل الموارد الخاملة إلى رأس مال منتج.
مجموعة بيانات جالسة غير مستخدمة تحتوي على قيمة محتملة. نموذج جالس غير نشط يحتوي على قيمة محتملة. جهة مستقلة تنتظر المهام تحتوي على قيمة محتملة. التحدي هو ربط تلك الموارد بأنظمة قادرة على التعرف على مكافآتها ومكافأة مساهماتها.
يبدو أن هذه واحدة من الأفكار المركزية وراء OpenLedger.
لا أستطيع التنبؤ بثقة ما إذا كان المشروع سينجح في النهاية.
ما يمكنني قوله هو أنني أجد الاتجاه مثيرًا من الناحية الفكرية.
لسنوات، كانت المناقشات حول الذكاء الاصطناعي تركز بشكل أساسي على الذكاء نفسه - كيف تتعلم النماذج، كيف تفكر، وكيف تتحسن. بشكل متزايد، أعتقد أن المحادثة تتحول نحو الملكية، والنسبة، وتوزيع القيمة.
من يستفيد عندما يخلق الذكاء الاصطناعي قيمة؟
من يجب أن يُكافأ عندما تساهم البيانات في نتيجة ناجحة؟
كيف ينبغي أن تشارك الجهات المستقلة في الاقتصاد الرقمي؟
تزداد أهمية هذه الأسئلة مع قدرة أنظمة الذكاء الاصطناعي.
عندما أنظر إلى OpenLedger، لا أرى مشروعًا يحاول ببساطة دمج الذكاء الاصطناعي والبلوكشين لأن كلاهما تقنيات شائعة. أرى محاولة لمعالجة مشكلة هيكلية موجودة بينهما. يبدو أن المشروع يدرك أن الذكاء وحده ليس كافيًا. التنسيق الاقتصادي مهم أيضًا.
بطرق عديدة، تبدو OpenLedger كأنها تجربة في إعادة تصميم كيفية تحرك القيمة عبر نظم الذكاء الاصطناعي.
الجزء الأكثر إثارة للاهتمام، على الأقل من وجهة نظري، ليس ما إذا كانت التكنولوجيا تعمل. يمكن تحسين التكنولوجيا بمرور الوقت. ما يهمني أكثر هو ما إذا كان يمكن لنظام أن ينجح في مواءمة الحوافز بين المساهمين في البيانات، وبناة النماذج، والمطورين، والجهات المستقلة دون خلق تعقيد مفرط.
هذا تحدٍ صعب.
ومع ذلك، أعتقد أنها بالضبط نوع التحديات التي ستحدد المرحلة التالية من اقتصاد الذكاء الاصطناعي.
بينما أتابع OpenLedger، أجد نفسي أعود إلى نفس الفكرة. قد لا يتحدد مستقبل الذكاء الاصطناعي فقط من خلال من يبني أذكى النماذج. قد يتشكل أيضًا من خلال من يخلق الأنظمة الأكثر فعالية لتوزيع القيمة التي تولدها تلك النماذج.
تحاول OpenLedger استكشاف هذه الإمكانية.
سواء أصبحت جزءًا رئيسيًا من البنية التحتية المستقبلية أو مجرد تجربة مهمة، أعتقد أن الأسئلة التي تثيرها أكثر أهمية بكثير من الإجابات المتاحة حاليًا. وفي مشهد الذكاء الاصطناعي المتطور بسرعة، أحيانًا تكون المشاريع الأكثر قيمة ليست تلك التي أراها.
أعتقد أننا وصلنا إلى نقطة أصبحت فيها البيانات واحدة من أكثر الموارد قيمة في العالم، ومع ذلك تبقى العلاقة بين أولئك الذين يخلقونها وأولئك الذين يحققون منافع منها مفصولة بشكل مدهش. كل يوم، يولد الناس كميات هائلة من المعلومات من خلال المحادثات والتطبيقات والمعاملات والبحث والنشاطات عبر الإنترنت. تغذي تلك البيانات أنظمة الذكاء الاصطناعي، وتحسن النماذج، وتساعد الشركات على بناء منتجات أكثر قوة. ومع ذلك، نادرًا ما يشارك معظم المساهمين في القيمة الناشئة من مساهماتهم.
ما يثير اهتمامي هو أن هذه الفجوة لم تحدث لأن شخصًا ما صممها عمدًا بهذه الطريقة. من نواحٍ عديدة، هي ببساطة نتيجة لكيفية تطور الإنترنت. أصبحت المنصات المركزية أماكن فعالة لجمع وتنظيم وتحقيق المعلومات. مع مرور الوقت، أصبحت ملكية البيانات، وملكية البنية التحتية، والتقاط القيمة مركزة في نفس الأماكن.
بينما يصبح الذكاء الاصطناعي أكثر أهمية، أعتقد أن هذه المشكلة تصبح أكثر صعوبة في التغاضي عنها.
تعتمد النماذج الذكية على مجموعات بيانات ضخمة. تأتي تلك المجموعات من عدد لا يحصى من الأفراد والشركات والتطبيقات والأنظمة. يساهم مطوروا النماذج بالخبرة والابتكار. يقدم المستخدمون ملاحظات تحسن الأداء. ومع ذلك، على الرغم من عدد المشاركين المعنيين، غالبًا ما يشعر الهيكل الاقتصادي بأنه ضيق بشكل مدهش.
كلما درست هذا المجال أكثر، شعرت أن التحدي ليس تقنيًا فقط. إنه أيضًا اقتصادي.
السؤال لم يعد فقط كيف نبني ذكاءً صناعيًا أفضل. السؤال هو كيف نبني أنظمة تنسق بشكل عادل بين الناس والبيانات والنماذج والجهات التي تجعل الذكاء الاصطناعي ممكنًا في المقام الأول.
هنا حيث لفتت OpenLedger انتباهي.
بدلاً من التركيز حصريًا على أداء النموذج أو القوة الحاسوبية، أرى أن OpenLedger تحاول معالجة قضية هيكلية أعمق. يبدو أن المشروع يبدأ بفكرة بسيطة نسبيًا: إذا كانت البيانات، والنماذج الذكية، والجهات المستقلة تصبح أصولًا رقمية منتجة، فربما تحتاج إلى بنية تحتية قادرة على تتبع المساهمات وتوزيع القيمة بشكل أكثر شفافية.
أجد أن هذه النظرة مثيرة للاهتمام لأنها تحول المحادثة بعيدًا عن التكنولوجيا البحتة نحو تصميم الحوافز.
في معظم مناقشات الذكاء الاصطناعي، تُعتبر البيانات مادة خام. تدخل النظام، تساهم في التدريب، ثم تختفي بشكل كبير من العرض. غالبًا ما يصبح الاتصال بين المساهم الأصلي والقيمة المستقبلية الناتجة عن تلك البيانات غير ممكن قياسه.
يبدو أن OpenLedger تستكشف نهجًا بديلًا.
عندما أقرأ عن المشروع، لا أرى أنه يحاول وضع البيانات كمدخل سلبي. بدلاً من ذلك، أرى محاولة لمعالجة البيانات كأصل اقتصادي يمكن أن يستمر في توليد القيمة ضمن شبكة أوسع. الفكرة تبدو أنه إذا كانت المساهمات يمكن تحديدها ونسبها، فإن المكافآت يمكن توزيعها بشكل أكثر فعالية.
للوهلة الأولى، يبدو أن هذا بسيط.
كلما فكرت في الأمر، أصبح أكثر تعقيدًا.
قياس المساهمة داخل أنظمة الذكاء الاصطناعي ليس سهلًا. نادرًا ما تخلق البيانات قيمة بمفردها. قد يعتمد النموذج على آلاف مجموعات البيانات. قد يؤثر العديد من المساهمين على النتائج في وقت واحد. غالبًا ما تتغير فائدة المعلومات مع مرور الوقت.
بسبب ذلك، أعتقد أن التحدي الحقيقي الذي يواجه OpenLedger ليس ما إذا كان يمكن للبلوكشين تسجيل المعاملات. التحدي الحقيقي هو ما إذا كان يمكن قياس المساهمة نفسها بطريقة ذات مغزى.
هذا التمييز مهم.
تركز العديد من مشاريع البلوكشين على إنشاء البنية التحتية. يبدو أن OpenLedger تطرح سؤالًا مختلفًا: كيف يمكن أن تدعم البنية التحتية نسبة الاقتصاد عبر نظم الذكاء الاصطناعي؟
أجد أن هذا السؤال مثير للاهتمام بشكل ملحوظ.
عندما أعود خطوة وأنظر إلى الصورة الأكبر، أرى أن تطوير الذكاء الاصطناعي هو عملية مترابطة للغاية. يقوم مزودو البيانات بإنشاء الموارد. يبني المطورون النماذج. تقدم التطبيقات الفائدة. يولد المستخدمون الملاحظات. تؤدي الجهات المستقلة بشكل متزايد مهامًا نيابة عن الأشخاص والمنظمات.
لا تعمل أي من هذه المكونات بشكل مستقل.
تظهر القيمة التي ينتجها النظام من التفاعلات بينهم.
ما أعتقد أن OpenLedger تحاول القيام به هو خلق بيئة حيث تصبح تلك التفاعلات مرئية اقتصاديًا. بدلاً من معالجة البيانات والنماذج والجهات كعوالم منفصلة، يبدو أن المشروع يستكشف طرقًا لربطها من خلال إطار مشترك.
إذا نجح الأمر، فقد يقلل ذلك من واحدة من أكبر عدم الكفاءة في اقتصاد الذكاء الاصطناعي اليوم: الانفصال بين المساهمة والتعويض.
بالطبع، أعتقد أيضًا أنه من المهم أن نكون واقعيين.
تظهر التاريخ أن أنظمة الحوافز صعبة التصميم بشكل لا يصدق. من السهل إنشاء المكافآت. لكن إنشاء مكافآت مستدامة أصعب بكثير.
كلما تم تقديم حوافز اقتصادية، يتكيف المشاركون بطبيعتهم مع سلوكهم حولها. يساهم البعض بقيمة حقيقية. بينما يقوم الآخرون بتحسين مكافآتهم. مع مرور الوقت، يجب على الأنظمة أن توازن باستمرار بين الانفتاح والجودة والعدالة والكفاءة.
هذه هي الأسباب التي تجعل مستقبل OpenLedger يعتمد على الاقتصاد بقدر ما يعتمد على التكنولوجيا.
قد تعمل البنية التحتية بشكل مثالي، ولكن إذا تشوهت الحوافز، فقد يكافح النظام. بالمقابل، إذا ظلت الحوافز متوافقة، فقد يجذب الشبكة مساهمات ذات قيمة متزايدة مع مرور الوقت.
جانب آخر يبقيني أفكر هو فكرة السيولة.
غالبًا ما أشعر أن الكثير من اقتصاد الذكاء الاصطناعي يحتوي على أصول قيمة ولكن يصعب تحقيقها مباشرة. تمتلك البيانات قيمة ولكن غالبًا ما تفتقر إلى الأسواق الفعالة. تنشئ النماذج فائدة ولكن قد تكافح لالتقاط المشاركة الاقتصادية المستمرة. يمكن للجهات المستقلة أداء عمل مفيد ولكن غالبًا ما تعمل ضمن أطر اقتصادية محدودة.
يبدو أن OpenLedger تستكشف طرقًا لجعل هذه الأصول أكثر نشاطًا اقتصاديًا.
أفكر في الأمر وكأنه تحويل الموارد الخاملة إلى رأس مال منتج.
مجموعة بيانات جالسة غير مستخدمة تحتوي على قيمة محتملة. نموذج جالس غير نشط يحتوي على قيمة محتملة. جهة مستقلة تنتظر المهام تحتوي على قيمة محتملة. التحدي هو ربط تلك الموارد بأنظمة قادرة على التعرف على مكافآتها ومكافأة مساهماتها.
يبدو أن هذه واحدة من الأفكار المركزية وراء OpenLedger.
لا أستطيع التنبؤ بثقة ما إذا كان المشروع سينجح في النهاية.
ما يمكنني قوله هو أنني أجد الاتجاه مثيرًا من الناحية الفكرية.
لسنوات، كانت المناقشات حول الذكاء الاصطناعي تركز بشكل أساسي على الذكاء نفسه - كيف تتعلم النماذج، كيف تفكر، وكيف تتحسن. بشكل متزايد، أعتقد أن المحادثة تتحول نحو الملكية، والنسبة، وتوزيع القيمة.
من يستفيد عندما يخلق الذكاء الاصطناعي قيمة؟
من يجب أن يُكافأ عندما تساهم البيانات في نتيجة ناجحة؟
كيف ينبغي أن تشارك الجهات المستقلة في الاقتصاد الرقمي؟
تزداد أهمية هذه الأسئلة مع قدرة أنظمة الذكاء الاصطناعي.
عندما أنظر إلى OpenLedger، لا أرى مشروعًا يحاول ببساطة دمج الذكاء الاصطناعي والبلوكشين لأن كلاهما تقنيات شائعة. أرى محاولة لمعالجة مشكلة هيكلية موجودة بينهما. يبدو أن المشروع يدرك أن الذكاء وحده ليس كافيًا. التنسيق الاقتصادي مهم أيضًا.
بطرق عديدة، تبدو OpenLedger كأنها تجربة في إعادة تصميم كيفية تحرك القيمة عبر نظم الذكاء الاصطناعي.
الجزء الأكثر إثارة للاهتمام، على الأقل من وجهة نظري، ليس ما إذا كانت التكنولوجيا تعمل. يمكن تحسين التكنولوجيا بمرور الوقت. ما يهمني أكثر هو ما إذا كان يمكن لنظام أن ينجح في مواءمة الحوافز بين المساهمين في البيانات، وبناة النماذج، والمطورين، والجهات المستقلة دون خلق تعقيد مفرط.
هذا تحدٍ صعب.
ومع ذلك، أعتقد أنها بالضبط نوع التحديات التي ستحدد المرحلة التالية من اقتصاد الذكاء الاصطناعي.
بينما أتابع OpenLedger، أجد نفسي أعود إلى نفس الفكرة. قد لا يتحدد مستقبل الذكاء الاصطناعي فقط من خلال من يبني أذكى النماذج. قد يتشكل أيضًا من خلال من يخلق الأنظمة الأكثر فعالية لتوزيع القيمة التي تولدها تلك النماذج.
تحاول OpenLedger استكشاف هذه الإمكانية.
