

كلما طالت مشاهدتي لمشاريع البيانات اللامركزية، زادت شعوري بأن معظم المناقشات تركزت على المنافسة الخاطئة.
غالبًا ما يُنظر إلى ذلك على أنه سباق لتوفير البيانات.
من يستطيع جمع أكبر قدر من البيانات. من يستطيع جذب أكبر عدد من المساهمين. من يستطيع بناء أكبر سوق.
لكن قد يكون ذلك مجرد الطبقة السطحية.
البيانات نفسها لم تكن أبدًا المورد النادر حقًا.
ما هو أصعب بكثير هو العثور على نظام قادر على تحويل البيانات الخام إلى ذكاء يمكن التحقق منه، وتحسينه باستمرار، وتوليد قيمة بشكل متكرر.
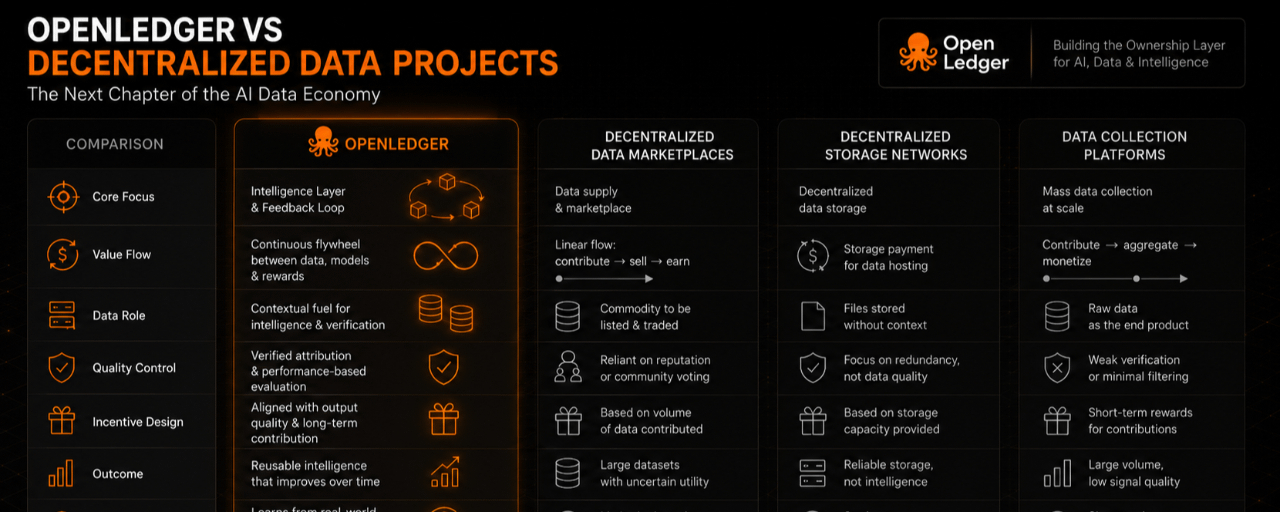
لهذا أجد OpenLedger مثيرًا للاهتمام خصوصًا مقارنةً بالعديد من مبادرات البيانات اللامركزية التي ظهرت خلال السنوات القليلة الماضية.
تعمل أغلب المشاريع على افتراض أنه إذا أمكن جمع ما يكفي من البيانات، فسيكتمل بقية نظام البيئة حولها تلقائيًا.
من الناحية النظرية، هذا منطقي.
لكن في الممارسة، نادرًا ما تكون البيانات هي العنصر الناقص.
التحديات الحقيقية تتمثل في السياق وتقييم الجودة وفهم أي مجموعات البيانات تنتج مخرجات أفضل من غيرها.
والأهم من ذلك، لا تزال العديد من الأنظمة تواجه صعوبة في ربط المساهمين بالقيمة التي تساعد بياناتهم على خلقها.
من وجهة نظري، يبدو أن OpenLedger يتعامل مع هذا التحدي بطريقة مختلفة.
بدلًا من التركيز فقط على بناء مستودع ضخم من المعلومات، يبدو أن الهدف هو إنشاء حلقة تغذية راجعة تتعزز فيها البيانات ونماذج الذكاء الاصطناعي والحوافز الاقتصادية بشكل مستمر فيما بينها.
للوهلة الأولى، قد يبدو هذا كاختلاف بسيط في التصميم.
في الواقع، فإنه يخلق حوافز سلوكية مختلفة تمامًا.
لأن الناس لا يستجيبون للتكنولوجيا وحدها.
إنهم يستجيبون للحوافز.
تشجّع العديد من مشاريع البيانات اللامركزية المستخدمين على المساهمة بالبيانات أولًا، ثم تحاول لاحقًا اكتشاف طرق لاستخراج القيمة منها.
تبدو بعض المقاربات الأحدث، بما فيها OpenLedger، وكأنها تعكس هذه العملية.
القيمة التي تُنتَج من المخرجات تصبح نقطة البداية، بينما تعمل البيانات كأحد مكوّنات ضمن دورة أوسع لإنشاء القيمة.
قد يبدو ما هو قرار منتج، لكنه في الحقيقة يعكس تحوّلًا أوسع في طريقة تفكير السوق في الذكاء الاصطناعي.
كانت الموجة الأولى مهووسة بالنماذج.
الموجة التالية أصبحت مهووسة بالبيانات.
الآن يبدو أن الاهتمام يتجه نحو سؤال مختلف:
كيف نبني أنظمة تتعلم باستمرار من التفاعلات الواقعية بدلًا من مجرد تجميع مجموعات بيانات أكبر؟
لأن البيانات ليست ثابتة.
إنها انعكاس لسلوك الإنسان.
وسلوك البشر يتغير باستمرار.
ما هو وثيق الصلة اليوم قد يصبح غير ذي صلة خلال أشهر عندما يغيّر الناس طريقة بحثهم وتواصلهم واتخاذهم للقرارات.
النموذج المدرب على واقع الأمس قد لا يكون مُحسَّنًا لواقع الغد.
ربما لهذا السبب أواصل متابعة مشاريع مثل OpenLedger.
ليس لأنهم حلوا بالكامل تحدي البيانات اللامركزية.
بل لأنهم يستكشفون سؤالًا أكثر جوهرية.
إذا ما ظهرت في نهاية المطاف اقتصاد تقوده الذكاء الاصطناعي، فأين ستقيم القيمة الحقيقية؟
بامتلاك البيانات؟
بامتلاك النماذج؟
أم في امتلاك حلقة التغذية الراجعة التي تربط بينهما باستمرار؟
لا أعتقد أن السوق قد وصل بعد إلى إجابة واضحة.
لكنها في الوقت نفسه توحي أكثر فأكثر بأن المنافسة الكبرى القادمة لن تكون حول من يملك أكبر قدر من البيانات.
سيعتمد الأمر على من يستطيع بناء أنظمة تحافظ على قيمة البيانات بينما يستمر العالم—وسلوك البشر—في التطور.