
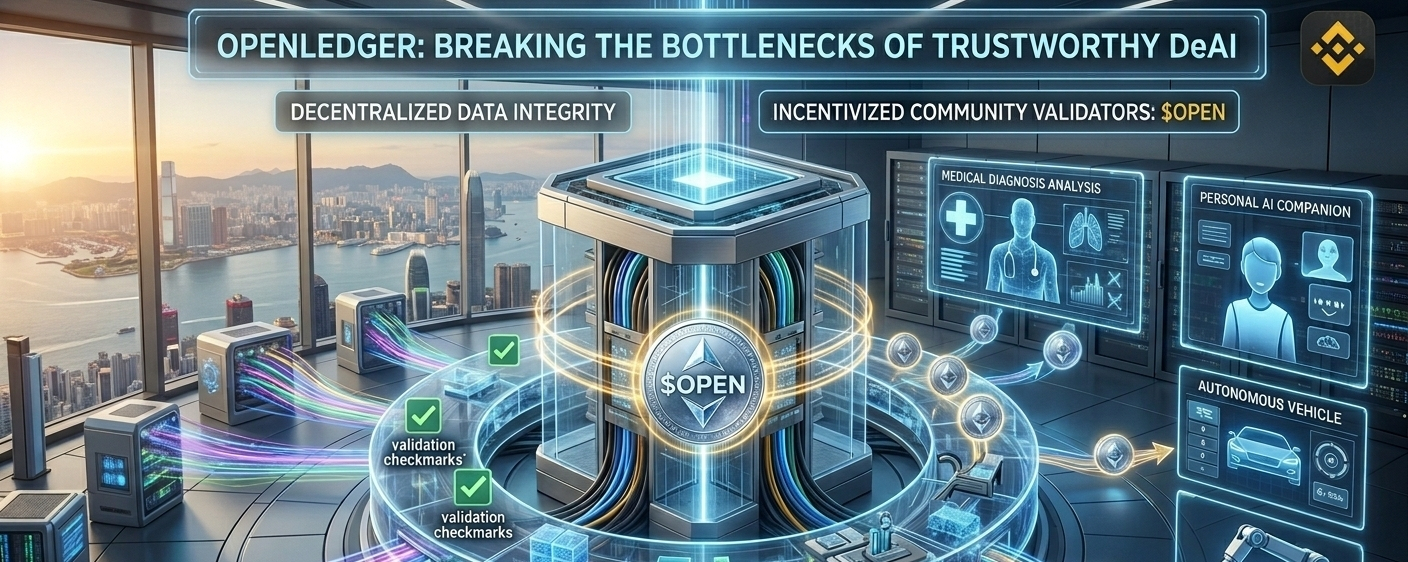

مع استمرار الذكاء الاصطناعي في صعوده السريع، تواجه الصناعة أزمة أساسية: الثقة. مخازن البيانات المركزية، حيث تقيم بيانات تدريب الذكاء الاصطناعي حاليًا، غير شفافة وعرضة للتحيز والتلاعب. هذا ينتج نماذج ذكاء اصطناعي يمكن أن تتعرض للاختراق أو تنتج 'هلوسات' ضارة. لا يمكن لنظام الذكاء الاصطناعي اللامركزي حقًا (DeAI) أن يعمل بدون أساس من البيانات الموثوقة التي تكون آمنة وقابلة للتدقيق. نحن بحاجة إلى وسيلة للتحقق من سلسلة إمدادات البيانات.
هنا بالتحديد تدخل @OpenLedger ، حيث يضع نفسه كالبنية التحتية الأساسية للذكاء الاصطناعي اللامركزي. بدلاً من كونه مجرد dApp آخر، يقوم OpenLedger ببناء خطوط بيانات متخصصة مصممة خصيصًا لتدريب نماذج DeAI. إنه يستخدم شبكة لامركزية من المدققين لجمع وتنظيف والتحقق من البيانات قبل أن تصل إلى نماذج الذكاء الاصطناعي. هذا يخلق تاريخًا قابلًا للتحقق تشفيرياً لأصل البيانات، مما يضمن أن كل قطعة من المعلومات المستخدمة في التدريب تتمتع بسلامة عالية وأصالة.
في قلب هذه البنية التحتية اللامركزية توجد $OPEN token. إنها ليست مجرد أصل استثماري تخميني؛ بل هي المحرك الاقتصادي الذي يجعل النظام بأكمله يعمل. تُحفَّز المُدقِّقات على تقديم فحوصات صارمة وعالية الجودة للبيانات لأنها تحصل على $OPEN مكافآت مقابل عملها المُتحقَّق منه. ينسجم ذلك بين سلامة البيانات التقنية والحوافز المالية، مما يخلق نظامًا بيئيًا قويًا يقوده المجتمع. يضمن نموذج الرمز استدامة طويلة الأجل وأمان سلسلة إمداد البيانات اللامركزية.
يقوم OpenLedger برسم خريطة لمستقبل تكون فيه البيانات سيادية وآمنة ومتاحة لاستخبارات قابلة للتحقق. ومن خلال معالجة الاختناق الحاسم المتمثل في سلامة البيانات اللامركزية، فإنهم يقدّمون المخطط لبناء ذكاء اصطناعي مستقل وموثوق. حان الوقت لبناء ذكاء لامركزي أكثر ذكاءً.