

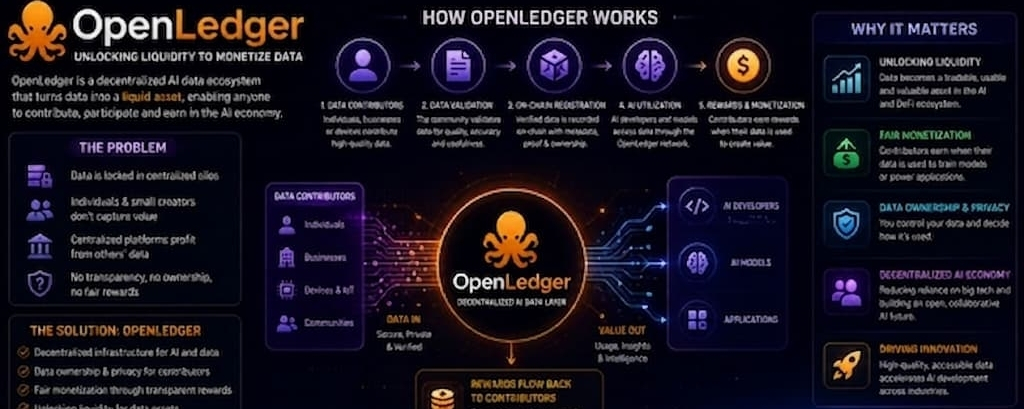
في اقتصاد اليوم الرقمي المتطور بسرعة، أصبحت البيانات هي الأصول الأكثر قيمة في العالم. كل نقرة، معاملة، تفاعل، وأثر رقمي يساهم في نظام بيانات عالمي ضخم. ومع ذلك، على الرغم من توليد قيمة هائلة، فإن معظم هذه البيانات تبقى مغلقة داخل منصات مركزية حيث يحصل المستخدمون على القليل من الفوائد الاقتصادية أو لا يحصلون على أي شيء. تظهر OpenLedger كطبقة بنية تحتية جديدة مصممة لتغيير هذا التوازن من خلال فتح القيمة الاقتصادية الحقيقية للبيانات وإعادة توزيعها بشكل أكثر عدلاً.
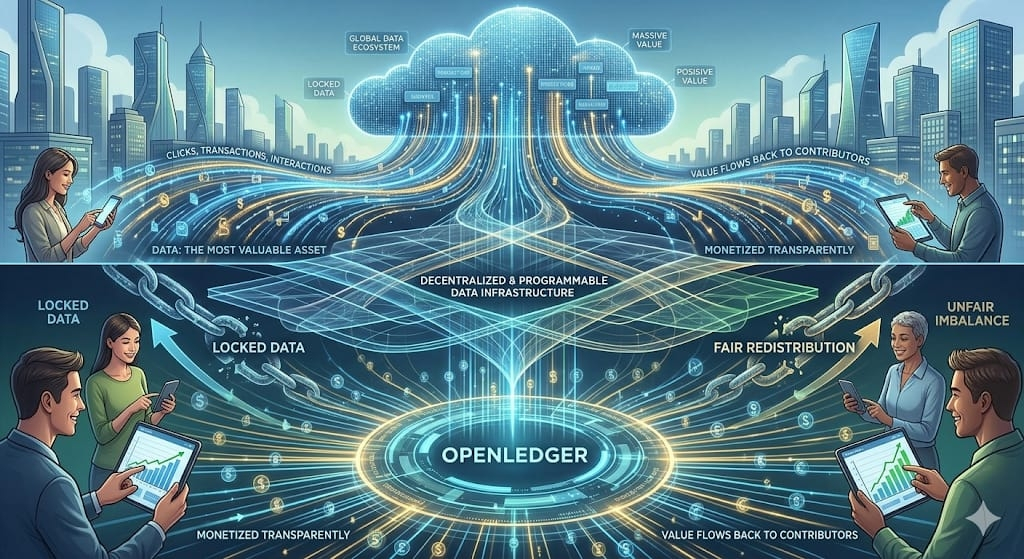
في جوهره، بُني OpenLedger على فكرة بسيطة لكنها قوية: ينبغي ألا تُجمع البيانات وتُخزن فحسب—بل يجب أن تُحوَّل إلى عوائد بشكل شفاف، وأن تتدفق القيمة إلى المساهمين الذين يولدونها. في الأنظمة التقليدية، تتحكم الشركات الكبرى في خطوط بيانات (data pipelines). تقوم شركات مثل منصات التواصل الاجتماعي ومحركات البحث وشركات الذكاء الاصطناعي بتجميع بيانات المستخدمين، وصقلها إلى معرفة، وتحويلها إلى مكاسب عبر الإعلانات أو تدريب النماذج. لكن المستخدمين، في المقابل، نادرًا ما يرون أي تعويض مباشر. يتحدى OpenLedger هذا النموذج عبر تقديم اقتصاد بيانات لامركزي وقابل للبرمجة.
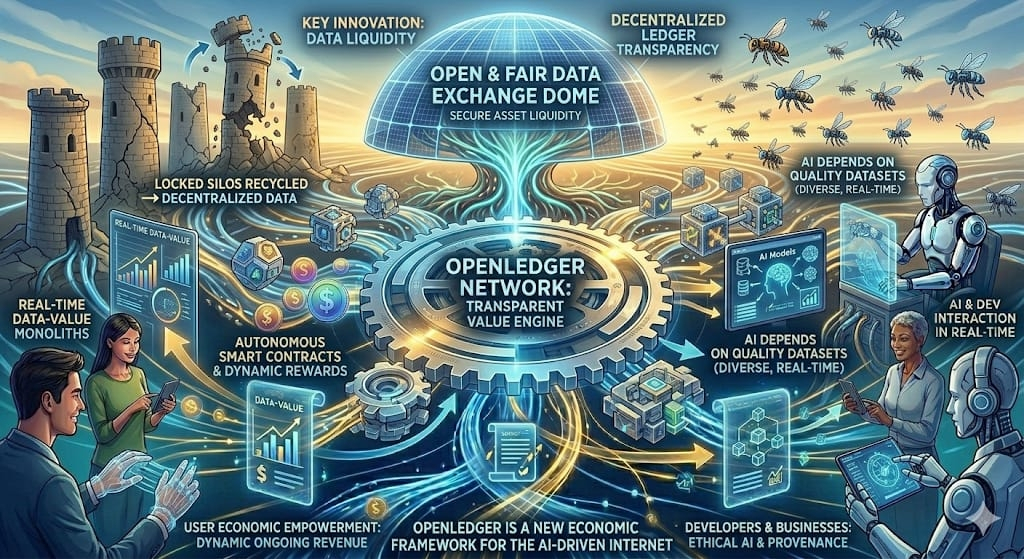
إحدى أهم الابتكارات في OpenLedger هي تركيزه على جعل البيانات سائلة. وبالمصطلحات المالية، تعني السيولة مدى سهولة تحويل أصلٍ ما إلى قيمة. يطبق OpenLedger هذا المفهوم على البيانات، محوّلًا إياها إلى فئة أصول يمكن تسعيرها وتبادلها والمكافأة عليها. بدلًا من أن تكون البيانات محبوسة داخل «جزر» معزولة، تصبح جزءًا من سوق مفتوح يمكن لمساهمين ومطوّرين وأنظمة ذكاء اصطناعي التفاعل معه في الوقت الفعلي.
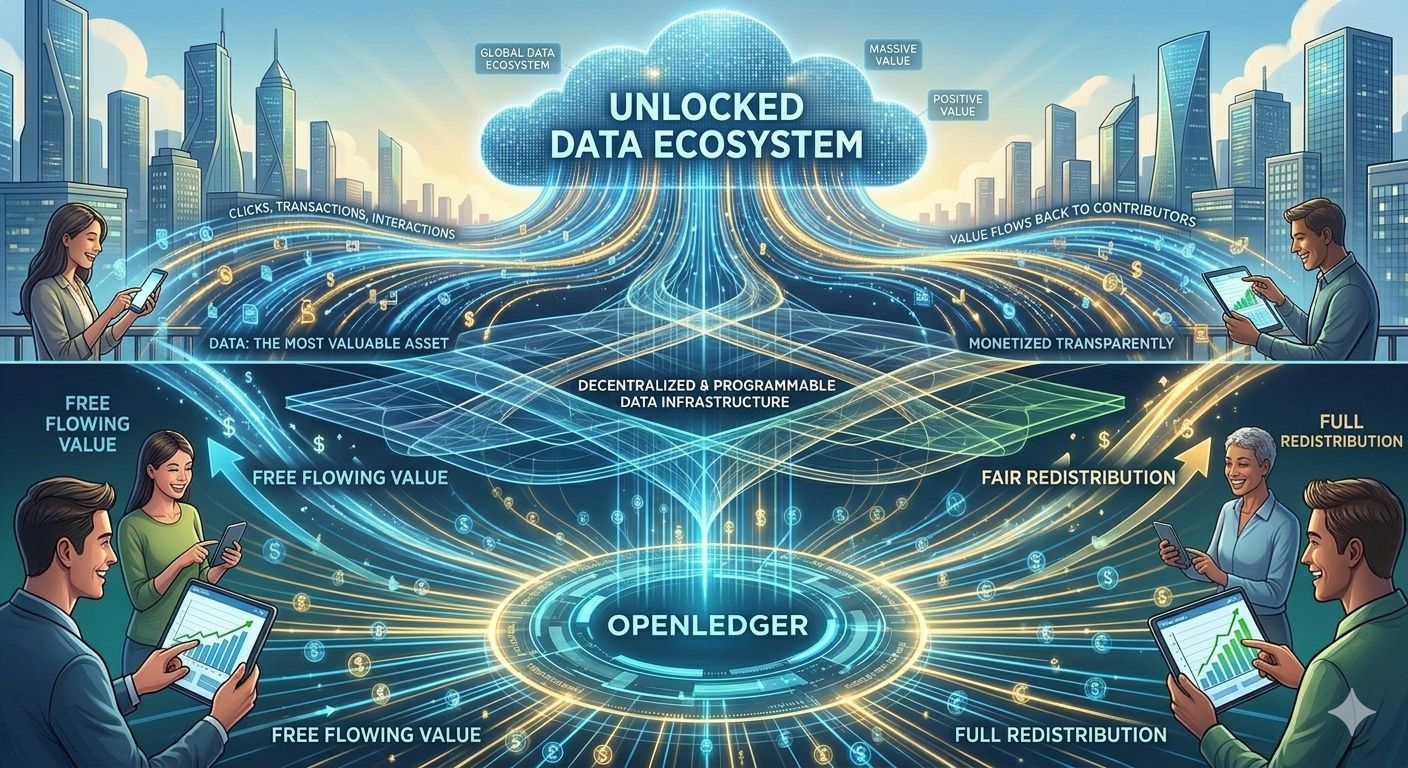
جانبٌ مهم آخر هو دمج الشفافية المبنية على تقنية البلوك تشين. باستخدام تكنولوجيا السجل اللامركزي، يضمن OpenLedger أن كل مساهمة بيانات قابلة للتتبع والتحقق. وهذا يخلق الثقة في النظام، بما يسمح للمشاركين بفهم كيفية استخدام بياناتهم وكيف يتم توزيع القيمة. يمكن للعقود الذكية أتمتة المدفوعات، لضمان مكافأة المساهمين كلما استُخدمت بياناتهم في تدريب الذكاء الاصطناعي أو التحليلات أو التطبيقات.
إن صعود الذكاء الاصطناعي يجعل هذه البنية التحتية أكثر أهمية. تعتمد نماذج الذكاء الاصطناعي بشكل كبير على مجموعات بيانات عالية الجودة، ويزداد الطلب بسرعة على بيانات متنوعة وفورية ومُتخصصة. يضع OpenLedger نفسه كحلقة وصل بين مُنتجي البيانات ومطوري الذكاء الاصطناعي. بدلًا من كشط البيانات أو شراء مجموعات بيانات من وسطاء مركزيين، يمكن لأنظمة الذكاء الاصطناعي الوصول إلى اقتصاد بيانات منظم ومشروط بالصلاحيات، تكون فيها عملية الاستخدام شفافة ومصحوبة بحوافز.
من منظور اقتصادي، قد يعيد هذا النموذج تشكيل كيفية خلق القيمة الرقمية. قد يتمكن المستخدمون في نهاية المطاف من الحصول على تدفقات دخل مستمرة من البيانات التي يولدونها يوميًا. ويحصل المطورون على وصول إلى مجموعات بيانات أغنى دون الاعتماد على وسطاء غير شفافين. ويمكن للشركات بناء أنظمة ذكاء اصطناعي أكثر أخلاقية وامتثالًا مع وجود مصدر بيانات واضح. وبهذا المعنى، لا يعد OpenLedger مجرد بنية تحتية تقنية—بل هو إطار اقتصادي جديد للإنترنت المدفوع بالذكاء الاصطناعي.
ومع ذلك، يأتي هذا التصور أيضًا مع تحديات. يتطلب بناء سوق بيانات سائلة معالجة قضايا تتعلق بالخصوصية، والمعايير، وقابلية التوسع. يجب أن يثق المستخدمون بأن المعلومات الحساسة محمية، مع استمرار إمكانية تحويلها إلى عوائد. بالإضافة إلى ذلك، فإن مواءمة الحوافز بين مساهمي البيانات ومستهلكي الذكاء الاصطناعي أمر معقد. لكي ينجح OpenLedger، يجب أن يخلق تجربة سلسة يشعر فيها المشاركون بأن المشاركة طبيعية وأن المكافآت ذات معنى.
رغم هذه التحديات، الاتجاه واضح. يتحرك العالم نحو اقتصاد تكون فيه البيانات مساوية لأهمية رأس المال والعمل. تحاول منصات مثل OpenLedger تحديد كيفية عمل هذا الاقتصاد الجديد. وإذا نجح ذلك، فقد يؤدي إلى تحويل جوهري للسلطة بعيدًا عن احتكارات البيانات المركزية، ونحو الأفراد والمجتمعات الذين يولدون القيمة كل يوم.
خلاصة القول، يمثل OpenLedger محاولة جريئة لإطلاق الإمكانات الاقتصادية الكامنة للبيانات. من خلال الجمع بين اللامركزية والشفافية والطلب المدفوع بالذكاء الاصطناعي، يتصور مستقبلًا لم تعد فيه البيانات مجرد نتاج ثانوي للنشاط الرقمي، بل أصلًا قابلًا للتسويق يملكه منشئوه.
