واحدة من الأشياء التي أدركتها متأخراً قليلاً هي أنه في اقتصاد الذكاء الاصطناعي، القوة الحقيقية قد لا تأتي من النماذج نفسها، بل من البيانات التي وراءها.
لا يزال معظم الناس يرون الذكاء الاصطناعي كمنافسة حول وحدات معالجة الرسوميات (GPUs)، والقدرة الحاسوبية، وسرعة الاستدلال، أو النماذج الأكبر بشكل متزايد. لكن مع مرور الوقت، من المحتمل أن تصبح النماذج أكثر تشبعاً.
ما هو أصعب بكثير في التكرار هو البيانات السلوكية.
كيف يبحث الناس.
كيف يتفاعلون.
ما الذي يستهلكونه.
ما الذي يجذب الانتباه.
ما الأنماط التي يتركونها كل يوم.
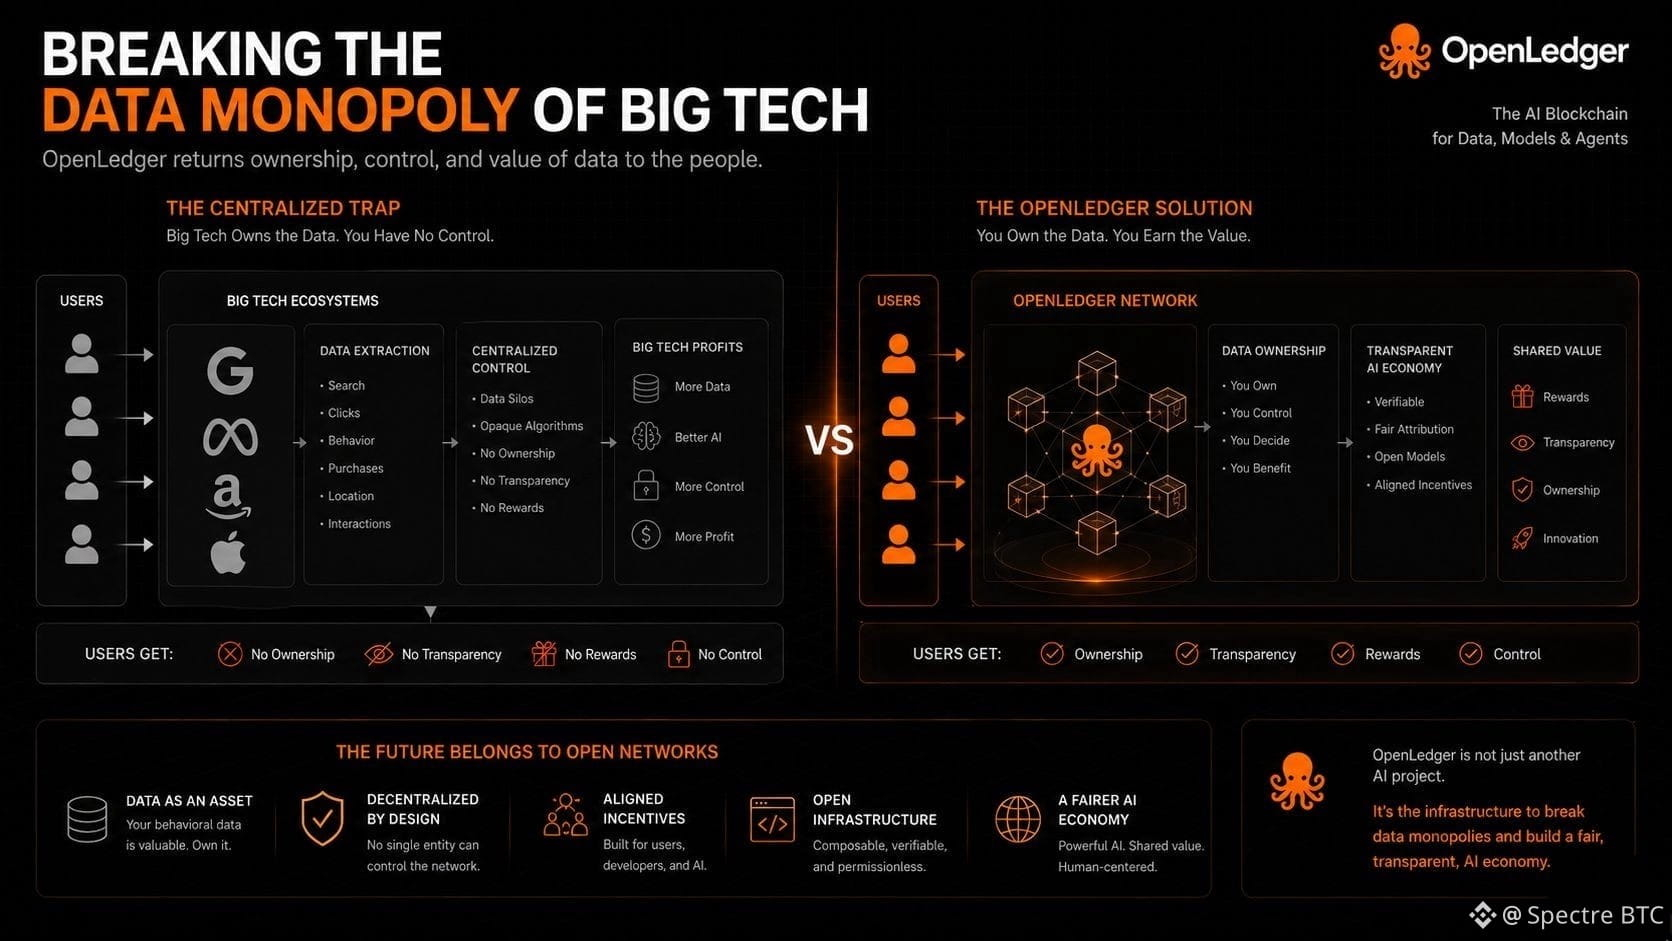
وهذا هو السبب أيضاً في أن شركات التكنولوجيا الكبرى بنت هيمنة دائمة على مر السنين.
إنهم لا يمتلكون المنتجات أو المنصات فقط.
بل يتحكمون في حلقة التغذية الراجعة.
المزيد من المستخدمين يولد المزيد من البيانات السلوكية.
المزيد من البيانات يحسن الخوارزميات.
خوارزميات أفضل تزيد من فعالية جذب الانتباه.
وانتباه محسن يبقي المستخدمين داخل النظام البيئي لفترة أطول.
دورة تعزز نفسها تصبح من الصعب جداً المنافسة ضدها.
لهذا السبب ما تحاول OpenLedger القيام به يبدو مثيراً لي.
الجزء الملحوظ قد لا يكون ببساطة "ذكاء اصطناعي لامركزي"، كما يصفه الكثيرون، بل المحاولة لإعادة توزيع ملكية الطبقة السلوكية نفسها.
نظرياً، تتوقف بيانات المستخدم عن كونها شيئاً يتم التنازل عنه بشكل غير واعٍ مقابل الراحة وتبدأ في أن تصبح أصلاً رقمياً معترفاً به.
لكن السؤال الأكبر هو ما إذا كان الناس يقيمون الملكية بما يكفي للتضحية بالراحة.
تاريخياً، اختار معظم المستخدمين البساطة على السيطرة.
وهذا يجعلني أفكر أن المعركة القادمة في الذكاء الاصطناعي قد لا تكون حول من يبني أذكى نموذج.
قد تكون حول من يتحكم في البنية التحتية السلوكية تحتها.
#OpenLedger $OPEN @OpenLedger