


في الفترة الأخيرة، أجد نفسي أشعر بشيء غريب في كل مرة أسمع فيها عبارة "الذكاء الاصطناعي سيدفع للمؤلفين". يبدو أنها صحيحة. شبه مستحيل أن تكون ضدها. لكن كلما فكرت في الأمر أكثر، أواجه سؤالاً بسيطاً: هل يجب الدفع لمجرد وجود عملك في مجموعة البيانات أم لتأثيره الحقيقي على إجابة النموذج؟
وهذا، على ما أظن، اقتصادان مختلفان تمامًا.
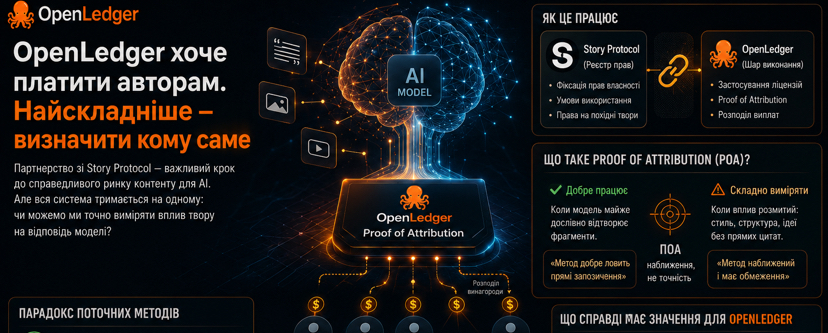
لهذا بالذات كنت أفكر، عندما بدأت تفكيك شراكة @@OpenLedger مع Story Protocol. الفكرة جميلة: المحتوى له مالكه، والذكاء الاصطناعي يحصل على الحق في الاستخدام، والمؤلف—مكافأة. يثبّت Story Protocol الحقوق، بينما يتولى OpenLedger مسؤولية نسبة المحتوى إلى صاحبه (attribution) وتوزيع المدفوعات.
لكن كل شيء هنا مبني على أساس واحد—Proof of Attribution.
المشكلة هي أن attribution بالنسبة للطرز الكبيرة من نماذج الذكاء الاصطناعي ما زالت غير دقيقة. النظام يستطيع أن يلتقط بشكل جيد المطابقات المباشرة: عندما يعيد النموذج إنتاج النص شبه حرفيًا. لكن الأمر أسوأ بكثير عندما يتعلق بـ“التأثير” غير الواضح—الأسلوب، وبنية الأفكار، والمنهج العام الذي تعلمته النماذج دون نسخ مباشر.
وتظهر هنا فكرة مثيرة للاهتمام. الأسهل هو الدفع مقابل ما هو أسهل بطبيعته إثباته—أي الاقتباس أو الاقتباس شبه الحرفي. والأصعب—هو الدفع مقابل نوع التأثير الذي يحدث باستمرار في التدريب الواقعي للذكاء الاصطناعي.
لذلك كنت أنظر إلى هذه الشراكة ليس على أنها “حل لمشكلة حقوق النشر في الذكاء الاصطناعي”، بل بالأحرى محاولة لبناء نظام للجزء من التأثير الذي يمكننا قياسه اليوم على الإطلاق.
وهنا يهمني رأيك. لو تم استخدام محتواك لتدريب ذكاء اصطناعي—ما الذي كان سيكون أكثر أهمية بالنسبة لك: attribution الأكثر دقة أم مجرد حقيقة أن النظام يحاول على الأقل أن يدفع للمؤلفين؟
