

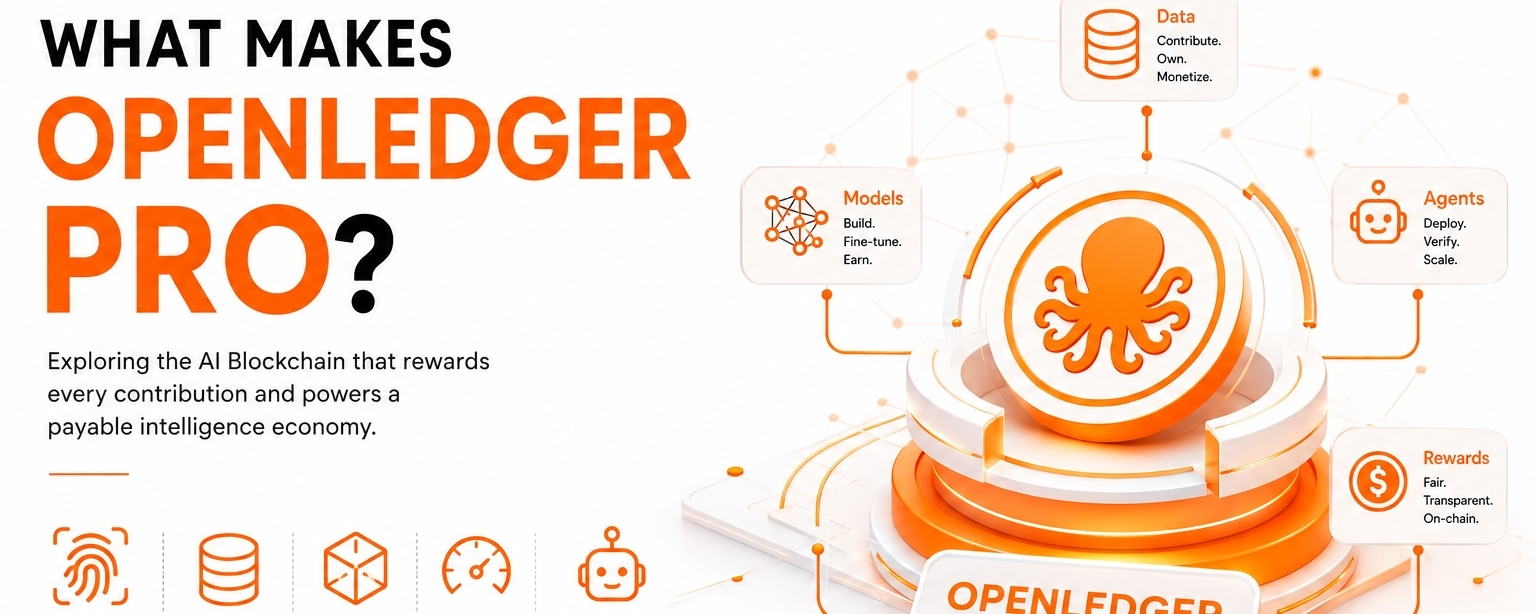
كنت أعتقد أن معظم مشاريع "البلوكشين الذكية" كانت مجرد تغليفات مختلفة لنفس الفكرة. اسم جديد، نفس الوعد. لامركزية هنا، عقود ذكية هناك، وفي مكان ما بينهما سرد حول الملكية لم يشعر أبدًا بالكمال.
لكن مؤخرًا، بينما كنت أقرأ عن OpenLedger مرة أخرى، وجدت نفسي أتباطأ. ليس لأنها كانت مثيرة بصوت عالٍ، ولكن لأن شيئًا في هيكلها كان... غير عادي بشكل متعمد. كأنها لم تكن تحاول إضافة طبقة أخرى للذكاء الاصطناعي، بل تعيد التفكير بهدوء في ماهية الذكاء الاصطناعي من الناحية الاقتصادية.
ولم تتركني تلك الفكرة بسهولة.في البداية لم أفهم حقًا لماذا كان الناس يسمون ذلك “pro”. كانت الكلمة خفيفة جدًا على شيء يدّعي أنه يجلس بين بنية ذكاء اصطناعي وبنى بلوك تشين. لكن بعد ذلك بدأت ألاحظ ما الذي كان يحاول فعله فعليًا. ليس الأداء. ليس الضجيج. بل الإسناد.
وهذا يغيّر كل شيء.
في معظم أنظمة الذكاء الاصطناعي اليوم، نتفاعل مع شيء يبدو وكأنه مُنجز. يعطي النموذج مخرجات، فنقبلها كمنتج لعملية تدريب غير مرئية ما. لا نرى مساهمي البيانات. لا نرى خطوات الضبط الدقيق. لا نرى الطبقات الاقتصادية تحتها.يبدو الأمر نظيفًا على السطح، لكن نظافته زائدة تقريبًا.
كانت هذه أول افتراضاتي: الذكاء الاصطناعي هو مجرد ذكاء يُقدَّم كخدمة. بسيط بما يكفي.
لكن يبدو أن OpenLedger ينطلق من افتراض مختلف تمامًا. فهو لا يعامل الذكاء الاصطناعي كمنتج ثابت، بل كنظام مُبنى من مساهمات كثيرة غير مرئية ينبغي ألا تظل غير مرئية إلى الأبد.وهنا بدأت أفكاري بالتحول.لأنه بمجرد أن تقبل أن مخرجات الذكاء الاصطناعي لا تُنشأ بمعزل، تصبح المسألة التالية غير مريحة.
من يملكه فعليًا؟
ليس قانونيًا، بل بنيويًا. ليس من حيث النظرية فحسب، بل من خلال مساهمة يمكن تتبعها.
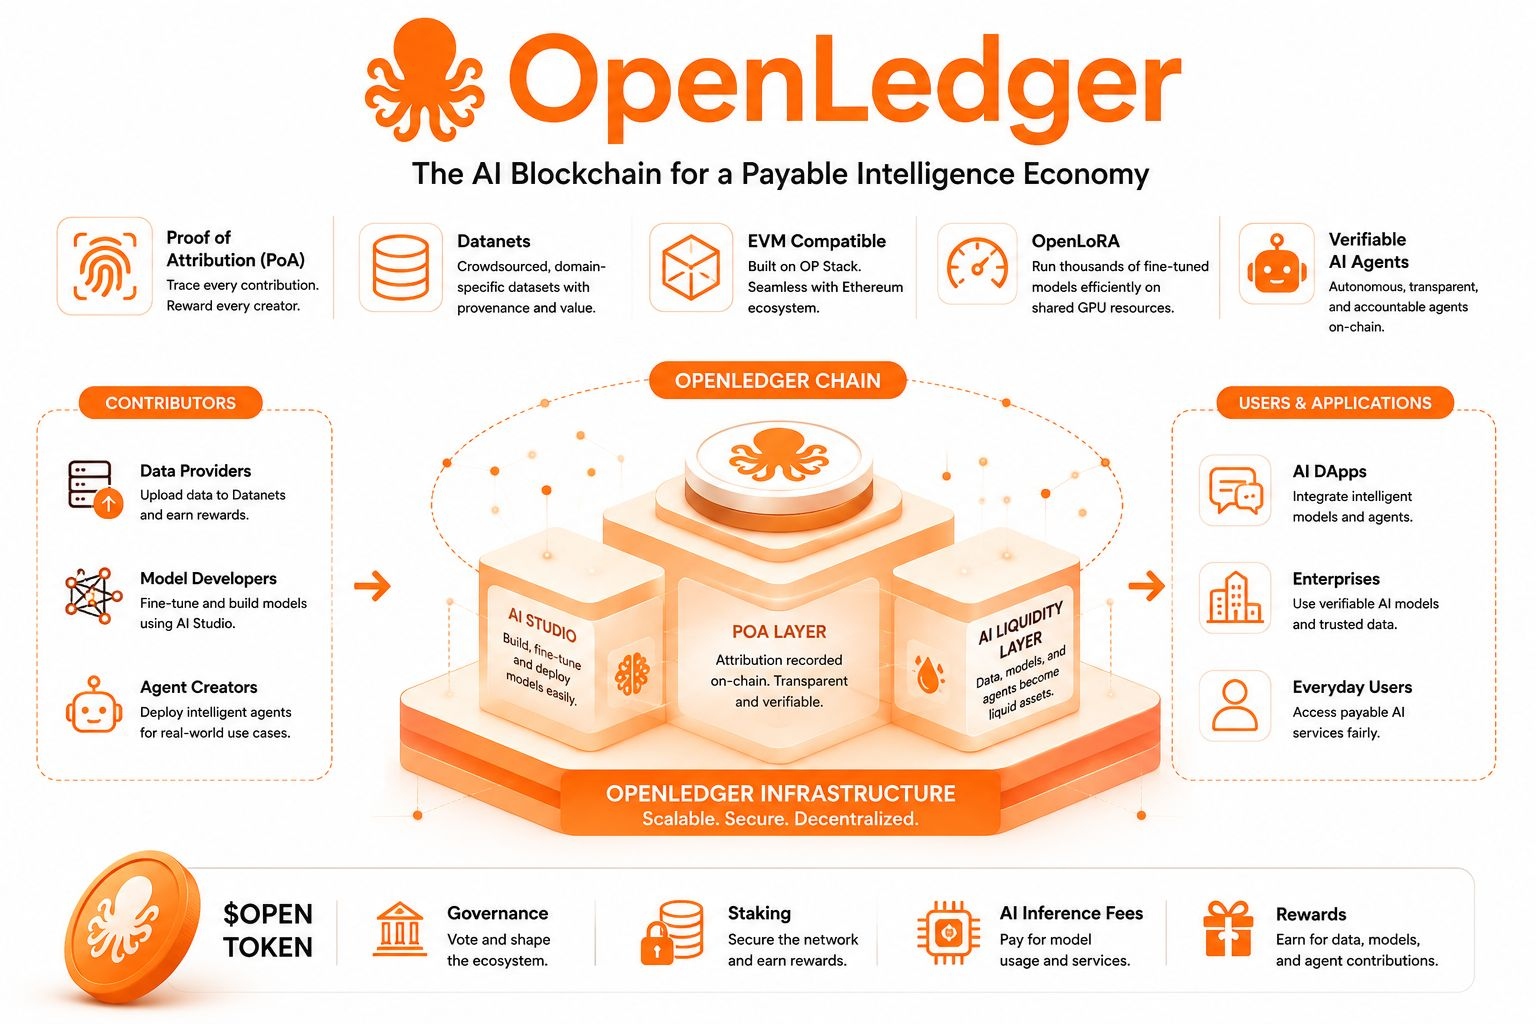
وهنا يقدّم OpenLedger فكرته الأساسية: إثبات الإسناد (Proof of Attribution).في البداية، ظننت أنه مجرد آلية تحقق أخرى. لكن كلما تعمقت أكثر، شعرت أنه شيء آخر تمامًا. إثبات الإسناد ليس مجرد تتبع الاستخدام — بل محاولة تتبع التأثير.يحاول الإجابة عن سؤال دقيق لكنه مهم: ما هي مجموعات البيانات، وما هي المدخلات، وما هي المساهمات التي شكلت بالفعل استجابة هذا النموذج؟وإذا كان ذلك يمكن القيام به بشكل موثوق، فسيخرج الذكاء الاصطناعي من كونه صندوقًا أسود لاستخراج القيمة، ويبدأ في أن يصبح نظامًا يمكن فيه قياس المساهمة في الوقت الحقيقي.
 وهذا ما جعلني أتوقف للحظة.
لأنه إذا أصبحت الإحالة دقيقة بما يكفي، فلن تضطر أنظمة المكافآت في الذكاء الاصطناعي لأن تكون غير مباشرة بعد الآن. يمكن أن تصبح فورية، شبه مستمرة. كل مرة يتم استخدام نموذج، قد يوزع النظام — من الناحية النظرية — القيمة مرة أخرى إلى المصادر التي جعلت هذا الناتج ممكنًا.قد أكون مخطئًا، لكن هذا يبدو كتحول هادئ في كيفية تعريف العمل الرقمي.
ثم تعمقت أكثر في كيفية تنظيم OpenLedger لبياناته، وواجهت شيئًا بدا أكثر واقعية: Datanets.
تبدو الفكرة بسيطة أولًا — مجموعات بيانات متخصصة حسب المجالات، يساهم فيها الجمهور. التمويل، الرعاية الصحية، البحث، وأكثر. لكن الدلالة أكثر إثارة للاهتمام من التعريف.بدلًا من الاعتماد على مجموعات بيانات ضخمة مركزية مملوكة لعدد قليل من المؤسسات، تتيح Datanets وجود مجموعات بيانات أصغر وموجهة لغرض محدد مع إرفاق أصل (provenance) لها. يمكن لأي شخص المساهمة، لكن الأهم من ذلك: يمكن لأي شخص إثبات ما قدّمته.يبدو وكأن البيانات تتوقف عن كونها موردًا صامتًا وتصبح شيئًا أقرب إلى سوق حي.والأسواق، بطبيعتها، تتطلب قواعد ملكية وتبادل.وهنا يبدأ النظام أن يبدو أقل كونه مشروع ذكاء اصطناعي وأكثر كونه بنية اقتصادية مبنية حول الذكاء ذاته.
ثم لاحظت طبقة أخرى: التوافق مع EVM.
للوهلة الأولى، يبدو هذا أمرًا تقنيًا، قريبًا من كونه معيارًا في تصميم البلوك تشين الحديث. لكن في السياق، الأمر أهم مما يبدو. كون #OpenLedger being built with EVM standards و OP Stack يعني أنه لا يعزل نفسه عن منظومة Ethereum القائمة. إنه يتصل بها. يمكن لمحافظ العملات والعقود الذكية وبنية المطورين الحالية أن تتكامل دون احتكاك.لكن المعنى الأعمق ليس التوافق — بل سهولة المشاركة.
لأنه إذا كانت الإحالة ومساهمة البيانات واستخدام النموذج كلها مرتبطة بنظام متوافق مع EVM، فإن نشاط الذكاء الاصطناعي يصبح شيئًا يمكن تتبعه والتفاعل معه باستخدام أدوات يفهمها المطورون بالفعل.يقلل ذلك الحاجز بين منطق البلوك تشين وأنظمة الذكاء الاصطناعي. والأمر أهم مما يبدو في البداية.
ثم يأتي شيء يبدو أكثر تشغيلية: OpenLoRA.وهنا يبدأ النظام أن يشعر أقل بالطرح النظري وأكثر بالعملية.
#OpenLoRA يتيح نشر نماذج ذكاء اصطناعي مُحسّنة بكفاءة من خلال السماح لعدة نماذج متخصصة بمشاركة موارد الـGPU. بدلًا من أن تتطلب كل نماذج حسابًا ثقيلًا ومعزولًا للبنية التحتية، يقوم النظام بتحسين طريقة تواجد هذه النماذج معًا.
ما لفت انتباهي هنا لم يكن الكفاءة فقط. بل كان قابلية التوسع الخاصة بالتخصص.إذا أمكن لآلاف النماذج المتخصصة المتخصصة أن توجد دون تكاليف إدارية مكلفة، فسيبتعد الذكاء الاصطناعي عن هيمنة عدد قليل من العمالقة العموميين. يصبح مجزأً إلى كثير من الأنظمة الأصغر، المصممة لغرض محدد.
وتؤدي عملية التجزئة إلى تغيير توزيع القوة.لأن القيمة لم تعد تتركز فقط في النماذج الأساسية الكبيرة، بل كذلك في أنظمة صغيرة مُحسّنة تم بناؤها بواسطة مساهمين أصغر.ثم صادفت شيئًا أكثر إثارة للاهتمام: وكلاء ذكاء اصطناعي قابلون للتحقق (Verifiable AI Agents).هنا تبدأ الأمور لتبدو مستقبلية قليلاً، لكن بشكل واقعي ومؤسس.يسمح OpenLedger للوكلاء المستقلين بالعمل في بيئة يتم فيها تسجيل منطقهم وتدفقات بياناتهم على السلسلة. وهذا يعني أن سلوكهم لا يُنفَّذ فقط — بل يمكن ملاحظته.وإذا كان شيئًا يمكن ملاحظته، فيمكن تقييمه.وهذا يفتح إمكانية غريبة: وكلاء يتصرفون بكفاءة أقل أو بشكل غير صحيح لا يفشلون داخليًا فقط — بل يصبحون محددين كجزء من نظام مترابط على الشبكة.الأمر ليس مجرد بناء وكلاء. بل يتعلق بخلق مساءلة للسلوك المستقل.هذا جعلني أدرك شيئًا دقيقًا. معظم أنظمة الذكاء الاصطناعي تُحسّن لجودة المخرجات. يبدو أن OpenLedger يهتم أيضًا بالتتبّع السلوكي.وهذا ليس الشيء نفسه.ثم توجد Model Factory، التي تبدو تقريبًا كمدخل للمستخدمين غير التقنيين. بيئة no-code يمكن للمستخدمين فيها رفع البيانات واختيار النماذج الأساسية ثم ضبطها (fine-tune) لحالات استخدام محددة.
في البداية ظننت أن هذا مجرد ميزة لسهولة الاستخدام. لكن في السياق، يبدو الأمر أشبه ببوابة اقتصادية.لأنه إذا كان بإمكان أي شخص إنشاء نموذج، فإن إنشاء النموذج نفسه يصبح عملًا موزعًا. ليس مقتصرًا على الباحثين أو الشركات الكبيرة.وإذا كانت تلك النماذج مرتبطة بالإسناد وأنظمة المكافآت، فإن بناء النماذج يصبح شكلًا من المساهمة القابلة للتحويل إلى دخل (monetizable contribution).وهنا يدخل الرمز $OPEN إلى النظام — ليس كعنصر مضارب، بل كطبقة تنسيق.يُستخدم للحَوْكمة (governance) والـ staking ورسوم الاستخدام وتوزيع المكافآت. لكن الأهم من ذلك أنه يصبح الوسيط الذي تتماشى من خلاله أنواع مختلفة من المساهمات — البيانات والقدرة الحاسوبية واستخدام النموذج — في تدفق اقتصادي واحد.وبدأت ألاحظ نمطًا هنا.ليس OpenLedger مجرد بناء أدوات. بل يبني طريقة لقياس المشاركة في أنظمة الذكاء الاصطناعي.قد يبدو ذلك بسيطًا، لكنه ليس كذلك.لأن القياس هو ما يحوّل المشاركة إلى اقتصاد.ومع ذلك، توجد توتر لا أستطيع تجاهله.كلما حاولت جعل إسناد الذكاء الاصطناعي أدق، زاد تعقيد النظام. والتعقيد له تكلفة خاصة به. قد يقلل من سهولة الوصول. قد يبطئ من التبني. وقد يخلق فجوات بين ما هو ممكن تقنيًا وما هو قابل للاستخدام عمليًا.
هناك أيضًا سؤال أعمق حول الدقة. هل يمكن أن يكون الإسناد في الذكاء الاصطناعي عادلًا تمامًا؟ عندما ينتج النموذج مخرجًا، كيف يمكنك قياس التأثير عبر ملايين تفاعلات التدريب؟حتى لو كان النظام سليمًا من الناحية التشفيرية، فقد تظل عملية التفسير غير تامة.تلك المفارقة تبدو مهمة. لأنها تشير إلى أن اللامركزية في الذكاء الاصطناعي ليست مجرد مشكلة تقنية — بل هي أيضًا مشكلة فلسفية.ومع ذلك، على الرغم من هذه الشكوك، يبدو أن الاتجاه الأوسع يصعب تجاهله.إذا استمرت أنظمة الذكاء الاصطناعي في التطور إلى بنى تحتية تتفاعل فيها البيانات والنماذج والوكلاء اقتصاديًا، فإن فكرة “الذكاء القابل للدفع” لم تعد تبدو مجردة. بل تبدو امتدادًا منطقيًا لما يحدث بالفعل.
تتحول البيانات إلى رأس مال. وتتحول النماذج إلى فاعلين اقتصاديين. وتصبح طريقة الاستخدام معاملة بين مساهمين قد لا يلتقون بعضهم أبدًا.يبدو أن OpenLedger يقف مباشرة في منطقة التحول هذه.لكنني ما زلت غير متأكد من كيفية ترسخ ذلك على المدى الطويل.ربما ستصبح الإحالة (الإسناد) دقيقة بما يكفي لإعادة تعريف الملكية في أنظمة الذكاء الاصطناعي. أو ربما سيظل الأمر دائمًا مجرد تقريـب مُضاف فوق تعقيد لا يمكننا تبسيطه بالكامل.أو ربما هذا لا يزال الشكل المبكر لشيء لم نفهمه بعد بشكل كامل.
