#openledger $OPEN
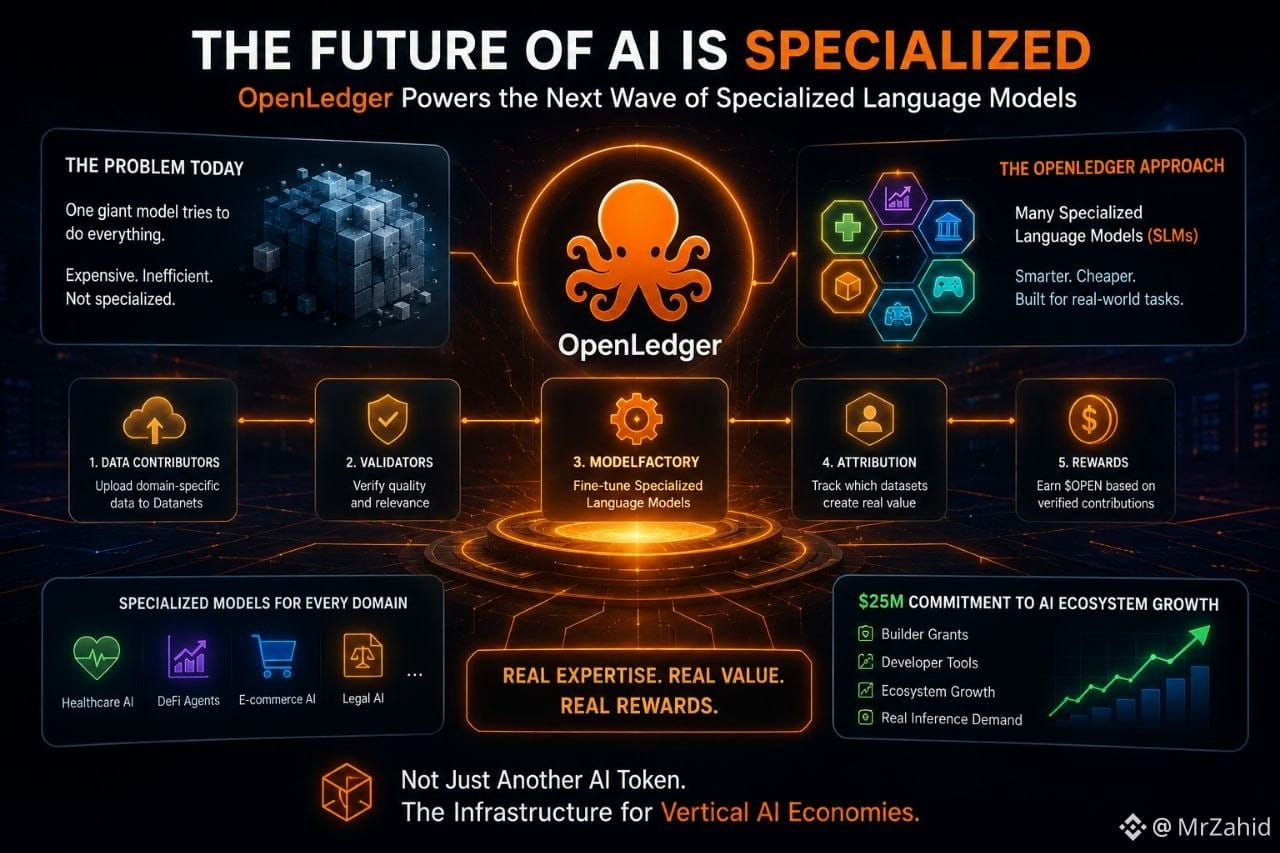
أعتقد أن أكبر سلاح طويل الأمد لـ OpenLedger قد يكون في الواقع توجهها نحو نماذج اللغة المتخصصة (SLMs) بدلاً من السعي وراء نموذج "الإله" العملاق. يبدو أن هذه الطريقة أكثر واقعية لمستقبل الذكاء الاصطناعي.
لا تحتاج الذكاء الاصطناعي في الرعاية الصحية إلى كتابة كلمات أغاني الراب. ولا يحتاج وكيل DeFi إلى مهارات فلسفية. يبدو أن OpenLedger تفهم أن النماذج المتخصصة التي تم تدريبها على بيانات مجال مختارة يمكن أن تتفوق على الأنظمة العامة المفرطة في المهام المحددة مع استخدام موارد أقل. هنا تبدأ Datanets و ModelFactory في التوافق معًا.
ما لفت انتباهي هو كيفية محاولة النظام البيئي ربط الحوافز مباشرة بالخبرة. يرفع المساهمون بيانات محددة للمجال، ويقوم المدققون بالتحقق من الجودة، وتتم تحسين النماذج، وتتبع النسب البيانات التي أنشأت قيمة فعلية. من الناحية النظرية، يخلق ذلك حلقة اقتصادية أكثر ذكاءً من صناعة الذكاء الاصطناعي الحالية حيث تقوم الشركات بجمع كل شيء ولا يحصل المساهمون على شيء بالمقابل 😅.
من منظور السوق، لا أتداول OPEN فقط بناءً على الزخم. أراقب ما إذا كانت نشاطات المطورين تستمر في النمو حول OpenCircle وما إذا كانت النماذج المتخصصة تبدأ في توليد طلب حقيقي على الاستدلال. لقد التزمت OpenLedger مؤخرًا بمبلغ 25 مليون دولار نحو نمو النظام البيئي الذي يركز على الذكاء الاصطناعي، مما يخبرني أنهم يفضلون البناة بدلاً من دورات التسويق الفارغة.
إذا تحققت فرضية SLM، فقد تبدو OpenLedger أقل كرمز ذكاء اصطناعي مضاربي وأكثر كالبنية التحتية الأساسية لاقتصادات الذكاء الاصطناعي العمودية. هذه هي النقطة المثيرة للاهتمام بالنسبة لي.
@OpenLedger $OPEN
أعتقد أن أكبر سلاح طويل الأمد لـ OpenLedger قد يكون في الواقع توجهها نحو نماذج اللغة المتخصصة (SLMs) بدلاً من السعي وراء نموذج "الإله" العملاق. يبدو أن هذه الطريقة أكثر واقعية لمستقبل الذكاء الاصطناعي.
لا تحتاج الذكاء الاصطناعي في الرعاية الصحية إلى كتابة كلمات أغاني الراب. ولا يحتاج وكيل DeFi إلى مهارات فلسفية. يبدو أن OpenLedger تفهم أن النماذج المتخصصة التي تم تدريبها على بيانات مجال مختارة يمكن أن تتفوق على الأنظمة العامة المفرطة في المهام المحددة مع استخدام موارد أقل. هنا تبدأ Datanets و ModelFactory في التوافق معًا.
ما لفت انتباهي هو كيفية محاولة النظام البيئي ربط الحوافز مباشرة بالخبرة. يرفع المساهمون بيانات محددة للمجال، ويقوم المدققون بالتحقق من الجودة، وتتم تحسين النماذج، وتتبع النسب البيانات التي أنشأت قيمة فعلية. من الناحية النظرية، يخلق ذلك حلقة اقتصادية أكثر ذكاءً من صناعة الذكاء الاصطناعي الحالية حيث تقوم الشركات بجمع كل شيء ولا يحصل المساهمون على شيء بالمقابل 😅.
من منظور السوق، لا أتداول OPEN فقط بناءً على الزخم. أراقب ما إذا كانت نشاطات المطورين تستمر في النمو حول OpenCircle وما إذا كانت النماذج المتخصصة تبدأ في توليد طلب حقيقي على الاستدلال. لقد التزمت OpenLedger مؤخرًا بمبلغ 25 مليون دولار نحو نمو النظام البيئي الذي يركز على الذكاء الاصطناعي، مما يخبرني أنهم يفضلون البناة بدلاً من دورات التسويق الفارغة.
إذا تحققت فرضية SLM، فقد تبدو OpenLedger أقل كرمز ذكاء اصطناعي مضاربي وأكثر كالبنية التحتية الأساسية لاقتصادات الذكاء الاصطناعي العمودية. هذه هي النقطة المثيرة للاهتمام بالنسبة لي.
@OpenLedger $OPEN