

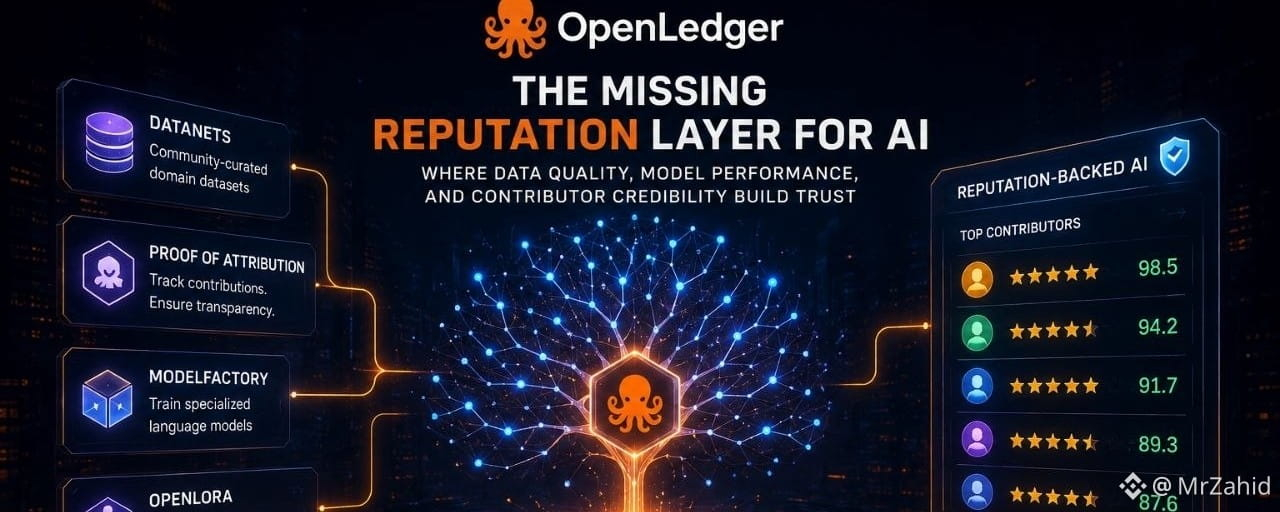
شيء واحد ألاحظه باستمرار في الذكاء الاصطناعي للعملات الرقمية هو أن الجميع يتحدث عن النماذج، ولكن لا يتحدث تقريباً أحد عن السمعة.
هذا غريب لأنه في التداول، السمعة هي أساس كل شيء.
ما أثق في إشارة بس لأنها تبدو ذكية. أثق فيها عندما أعرف:
من أين جاءت البيانات،
من ساهم بها،
ما إذا كان هؤلاء المساهمون دقيقين من قبل،
وما إذا كانت الحوافز متوافقة.
لهذا السبب يبدو أن بنية OpenLedger أكثر أهمية مما يدركه الناس.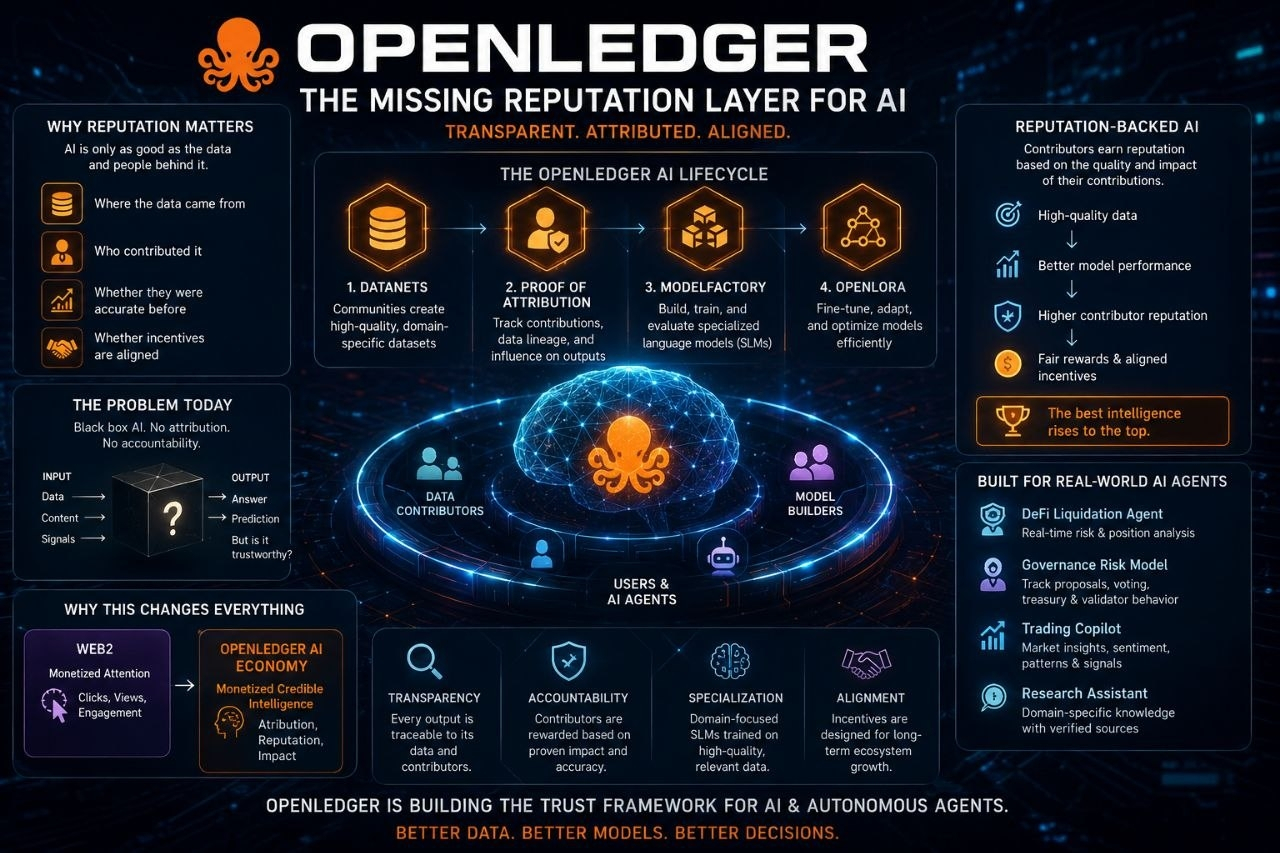
OpenLedger لا تحاول فقط استضافة نماذج الذكاء الاصطناعي على السلسلة. يبدو أن اللعبة الأكبر هي إنشاء نظام اقتصادي حيث تتصل جودة البيانات، وأداء النموذج، ومصداقية المساهمين من خلال التخصيص الشفاف. بنيتهم التحتية تجمع بين Datanets، وإثبات التخصيص، وModelFactory، وOpenLoRA في مجموعة كاملة لدورة حياة الذكاء الاصطناعي.
ما الجزء المثير؟ هذا يضع الأساس لذكاء اصطناعي مدعوم بالسمعة.
وبصراحة، أعتقد أن هذه السردية أقل تقديرًا بشكل كبير في الوقت الحالي.
معظم أنظمة الذكاء الاصطناعي اليوم تعمل كصناديق سوداء. تطرح سؤالًا، تحصل على إجابة، ثم تأمل فقط ألا تكون البيانات الأساسية قمامة. لكن آلية إثبات الإسناد لدى OpenLedger مُصممة لتتبع أي مجموعات بيانات وأي مساهمين أثّروا في مخرجات النموذج.
هذا يغيّر الحوافز تمامًا.
تخيّل شبكة بيانات لأبحاث العملات المشفرة تركز فقط على مخاطر الحوكمة. يقوم المساهمون برفع ملخصات الحوكمة، وتغيّرات الخزانة، وسلوك المدققين، ومناقشات المقترحات، وشذوذات التصويت. ومع مرور الوقت، يمكن للنظام تحديد أي مساهمين يقدمون باستمرار معلومات عالية الإشارة تحسّن مخرجات الذكاء الاصطناعي اللاحقة.
الآن فجأة لم يعد المساهمون مجرد “مستخدمين”.
فتصبح مزوّدي ذكاء يحملون سمعة.
إنه تحول كبير.
لأن اقتصاد الذكاء الاصطناعي في المستقبل ربما لن يكافئ حجم المحتوى الخام. بل سيكافئ المنفعة المُتحقق منها.
كمتداول، فهذا مهم جدًا بالنسبة لي. بعض أفضل الأفكار التي وجدتها في السوق جاءت من باحثين متخصصين جمهورهم صغير لكن لديهم دقة مذهلة في التعرّف على الأنماط. أنظمة الذكاء الاصطناعي الحالية تُسطيح كل المعلومات في نفس “المرق”. هيكلة OpenLedger قد تتيح الترجيح بناءً على جودة الإسناد وقيمة المساهمة التاريخية.
هذا أقرب إلى الطريقة التي تعمل بها عملية اتخاذ القرار الحقيقية.
وأنا أيضًا أعتقد أن تركيز OpenLedger على نماذج اللغات المتخصصة (SLMs) أذكى مما يمنحه السوق حقه. الأبحاث حول OpenLedger تؤكد مرارًا على الذكاء المرتبط بمجالات محددة بدل محاولة بناء نموذج عملاق واحد شامل.
وبصراحة… هذا يتماشى تمامًا مع الطريقة التي تعمل بها ألفا فعليًا.
المعرفة العامة نادرًا ما تصنع تفوقًا. السياق المتخصص يفعل ذلك.
لا يحتاج وكيل تصفية في ديفاي إلى فهم الشعر.
نموذج مخاطر الحوكمة لا يحتاج إلى توافه سينمائية.
مساعد تداول لا يحتاج إلى ضجيج واسع على الإنترنت.
يحتاج إلى سياق حاد ومركّز مُدرَّب على بيانات مجال عالية الجودة.
شبكات بيانات OpenLedger مُصممة أساسًا حول هذا المبدأ. تقوم المجتمعات بإنشاء مجموعات بيانات موجّهة، ويقوم المساهمون بتحسينها، وتتخصص النماذج عليها، وتقوم آليات الإسناد بتوزيع المكافآت مرة أخرى عبر النظام.
ما أراه صعوديًا ليس فقط التقنية. بل هو التصميم الاقتصادي.
إذا نجح OpenLedger، فقد يتوقف سوق الذكاء الاصطناعي عن مكافأة الحجم وحده، ويبدأ في مكافأة الخبرة القابلة للتحقق.
إنها اقتصاد إنترنت مختلف تمامًا.
المنصات التي سيطرت على Web2 حوّلت الاهتمام إلى أرباح.
قد يدرّ الجيل التالي من بنية تحتية للذكاء الاصطناعي أرباحًا من ذكاء موثوق.
وإذا حدث ذلك، فقد يصبح OpenLedger أكثر بكثير من مجرد سلسلة ذكاء اصطناعي. قد يتحول إلى إطار الثقة الذي يستخدمه الوكلاء المستقلون لتقييم أي معلومات - وأي مساهمين - يستحقون فعلاً أن يكون لهم تأثير 🤝