

الجميع يتحدث عن خارطة طريق OpenLedger. سوق الذكاء الاصطناعي. فتح الرمز. الشراكات.
لكن لا أحد يشرح القطعة الواحدة من التكنولوجيا التي تجعل كل هذا ممكنًا.
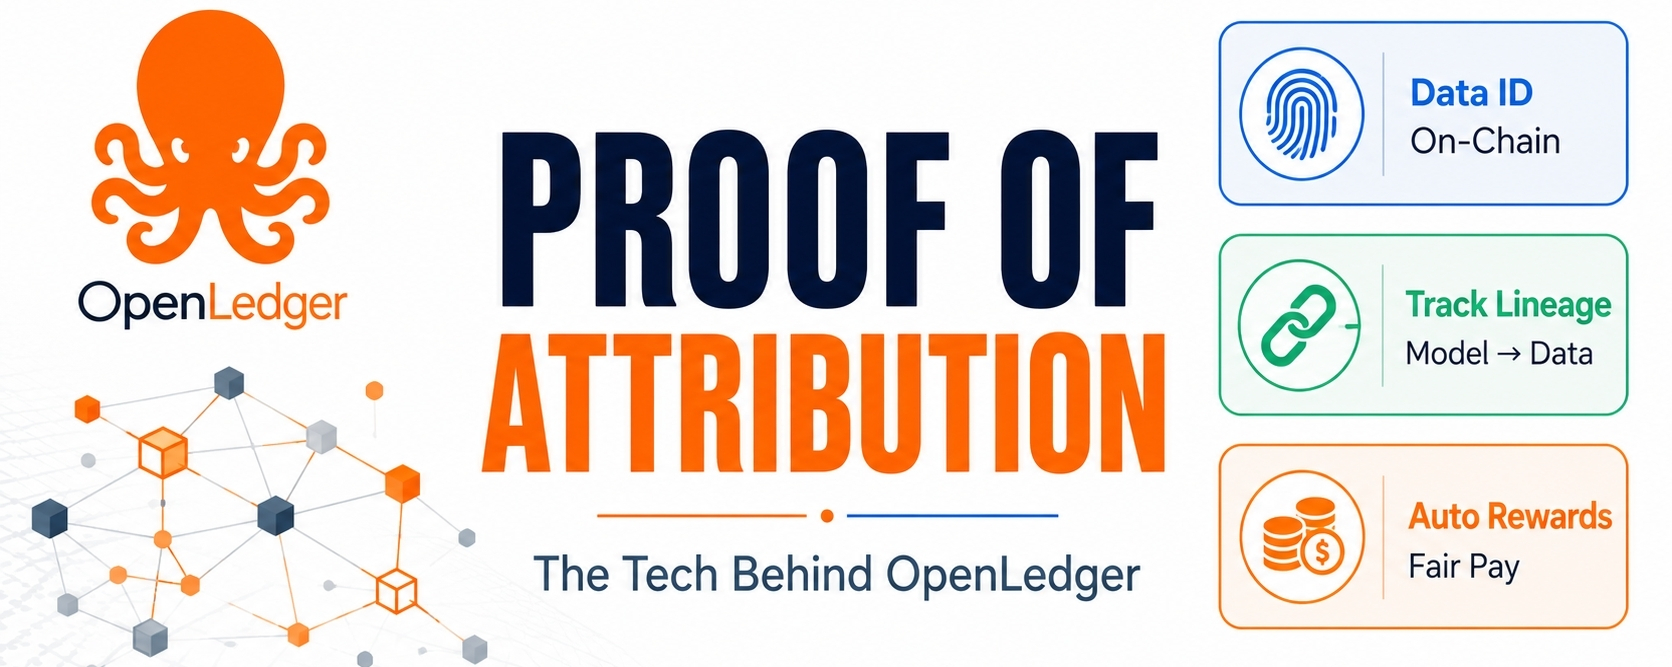
إثبات النسبة.
هذه هي الأساس الفني للمشروع بأكمله. وإذا لم تفهم ذلك، فأنت لا تفهم لماذا يوجد OpenLedger.
ما المشكلة التي يحلها؟
الآن، شركات الذكاء الاصطناعي تسحب البيانات من كل مكان. يدربون النماذج. يولدون المخرجات. لكن لا يوجد أي تتبع.
من الذي ساهم في بيانات التدريب؟ أي مجموعة بيانات أثرت على أي مخرج؟ كيف تدفع للمساهمين بشكل عادل؟
لا يمكنك ذلك. الاقتصاد الكامل للذكاء الاصطناعي يعتمد على عمل مسروق دون أي أثر ورقي.
تغيّر إثبات الإحالة/النَّسب (PoA) ذلك. فهو يتتبع نسب كل جزء من البيانات عبر دورة حياة الذكاء الاصطناعي بالكامل.
كيف يعمل فعليًا
عندما ترفع مجموعة بيانات إلى OpenLedger، تحصل على مُعرّف فريد على السلسلة. هذه هي بصمتك/هويتك الرقمية للبيانات.
عندما يقوم شخص بتدريب نموذج ذكاء اصطناعي باستخدام مجموعة البيانات تلك، يرث النموذج مرجعًا لبصمة بياناتك. على السلسلة. إلى الأبد.
عندما يقوم النموذج بتوليد مخرج، يتم الحفاظ على سلسلة الإحالة/النَّسب. المخرج → النموذج → مجموعة البيانات → أنت.
تقوم العقود الذكية تلقائيًا بتوجيه المدفوعات بناءً على وزن الإحالة/النَّسب. إذا ساهمت بياناتك بنسبة 10% في مخرجات نموذج ما، ستحصل على 10% من رسوم الاستدلال.
يحدث كل ذلك تلقائيًا. دون وسطاء. دون نزاعات. مجرد حسابات رياضية.
لماذا هذا صعب
الإحالة/النَّسب في الذكاء الاصطناعي كابوس. يتم ضبط النماذج بدقة. يتم دمج مجموعات البيانات. وتُعدَّل الأوزان.
تفقد الأنظمة التقليدية تتبع المنشأ فورًا. بمجرد دخول البيانات في خط تدريب، تختفي الإحالة/النَّسب.
حل OpenLedger ذلك عبر محرك إحالة/نَسب (Attribution Engine) يستمر عبر تطور النماذج. حتى عند تحديث النماذج أو ضبطها بدقة، تبقى روابط مخرجات البيانات سليمة.
هذا اختراق تقني. ليس دعاية. هندسة حقيقية.
النموذج الاقتصادي
وهنا تصبح الأمور مثيرة لحملة OPEN.
كل استعلام إحالة/نَّسب يكلف OPEN. كل نشر لنموذج. كل استدلال يؤدي إلى تفعيل تتبع الإحالة/النَّسب.
كلما زادت أنشطة الذكاء الاصطناعي على OpenLedger، زاد حرق OPEN أو توزيعها كرسوم.
هذه ليست مضاربة. إنها طلب على الاستخدام مرتبط مباشرةً باستهلاك الشبكة.
زاوية تنظيمية
يطلب قانون الذكاء الاصطناعي في الاتحاد الأوروبي الشفافية. يجب على الشركات الإفصاح عن مصادر بيانات التدريب. الانتهاكات = غرامات ضخمة.
يسأل المشرعون في الولايات المتحدة الأسئلة نفسها. من أين جاءت بيانات التدريب؟ هل يمكنك إثبات الموافقة؟ هل يمكنك تعويض المبدعين؟
معظم شركات الذكاء الاصطناعي لا تستطيع الإجابة عن هذه الأسئلة. لم تُبنَ أنظمتها من أجل الإحالة/النَّسب.
كان OpenLedger كذلك. منذ اليوم الأول.
عندما تبدأ الجهات التنظيمية بفرض محاسبة الذكاء الاصطناعي، ستحتاج المؤسسات إلى أنظمة إحالة/نَّسب قابلة للإثبات. يعد OpenLedger أحد الشبكات/البلوكشينات القليلة المصممة خصيصًا لهذا الغرض.
مشكلة المنافسة
ليس OpenLedger وحده. يستهدف Ocean Protocol وSingularityNET وFetch.ai أيضًا الذكاء الاصطناعي + البلوكشين.
لكنهم يركزون على الحوسبة والتخزين وأسواق وكلاء الذكاء الاصطناعي. لا على الإحالة/النَّسب.
الإحالة/النَّسب هي الميزة الحصينة (moat) لدى OpenLedger. إنها الفارق التقني الذي يبرر المشروع بالكامل.
إذا لم يكن للإحالة/النَّسب أي أهمية، فلن يكون لدى OpenLedger أي ميزة تنافسية.
إذا أصبحت الإحالة/النَّسب إلزامية، يصبح OpenLedger بنية تحتية ضرورية.
ماذا سيحدث بعد ذلك
سوق الذكاء الاصطناعي (القادم في 2026) سيكون أول اختبار حقيقي لإثبات الإحالة/النَّسب على نطاق واسع.
هل سينشر المطورون فعلاً نماذج باستخدام نظام الإحالة/النَّسب في OpenLedger؟ هل ستتبناه المؤسسات للامتثال؟
إذا كانت الإجابة نعم، يتحول OPEN من رمزٍ تخميني إلى بنية تحتية.
إذا كانت الإجابة لا، فلن تهم التقنية. كل شيء هو التبني.
أطروحة الاستثمار
أنت لا تراهن على الدعاية. أنت تراهن على ما إذا ستصبح الإحالة/النَّسب القابلة للتحقق شرطًا إلزاميًا.
إذا كانت الإجابة نعم، يصبح إثبات الإحالة/النَّسب في OpenLedger بنية تحتية حاسمة.
إذا كانت الإجابة لا، فستحدث “نزف” للرمز بغض النظر عن مدى جودة التقنية.
هذه هي الرهينة. إما أن تنجح أو لا.
#OpenLedger #OPEN #ProofOfAttribution #AI
هذه ليست نصيحة مالية. قم بأبحاثك الخاصة (DYOR).