

لا يزال معظم الناس يعتقدون أن بنية الذكاء الاصطناعي تتعلق بشكل أساسي بالنماذج. نماذج أكبر، نماذج أسرع، استدلال أرخص. لكن بعد قضاء المزيد من الوقت في البحث عن OpenLedger، أعتقد أن الطبقة الأكثر أهمية قد تكون في الواقع الذكاء المنظم.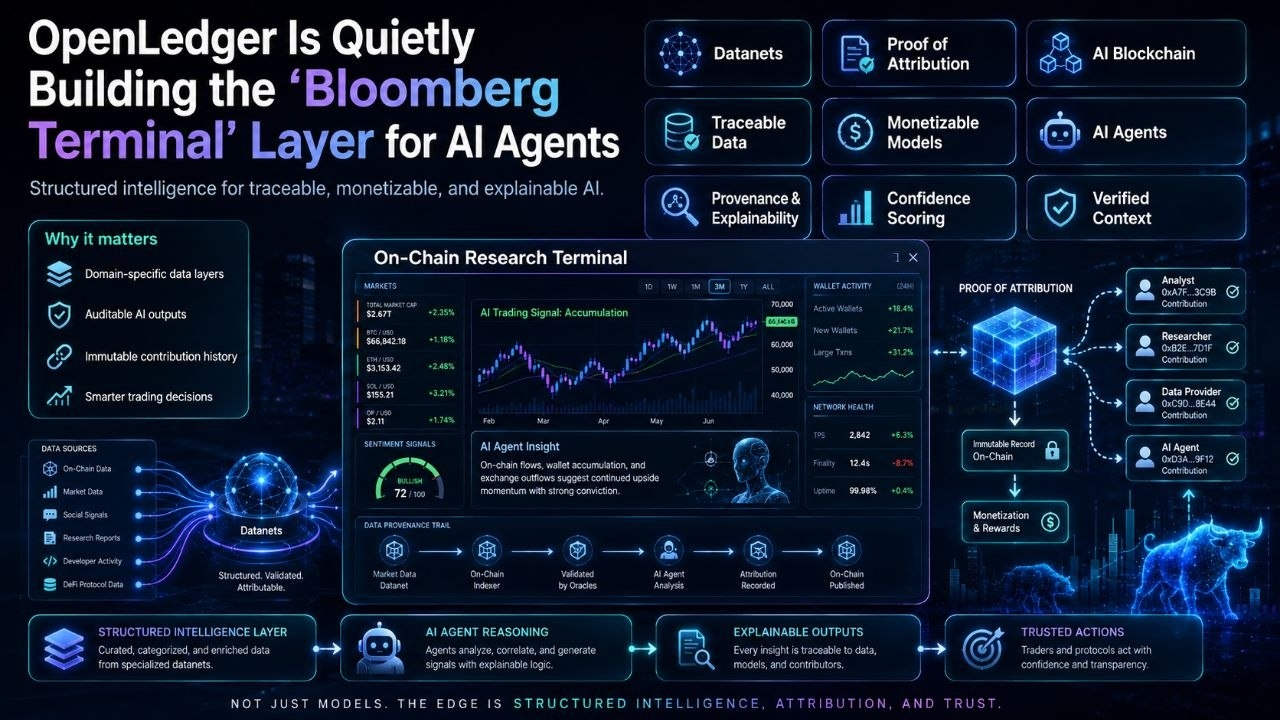
هذه هي الجزء المهمل في رؤية OpenLedger.
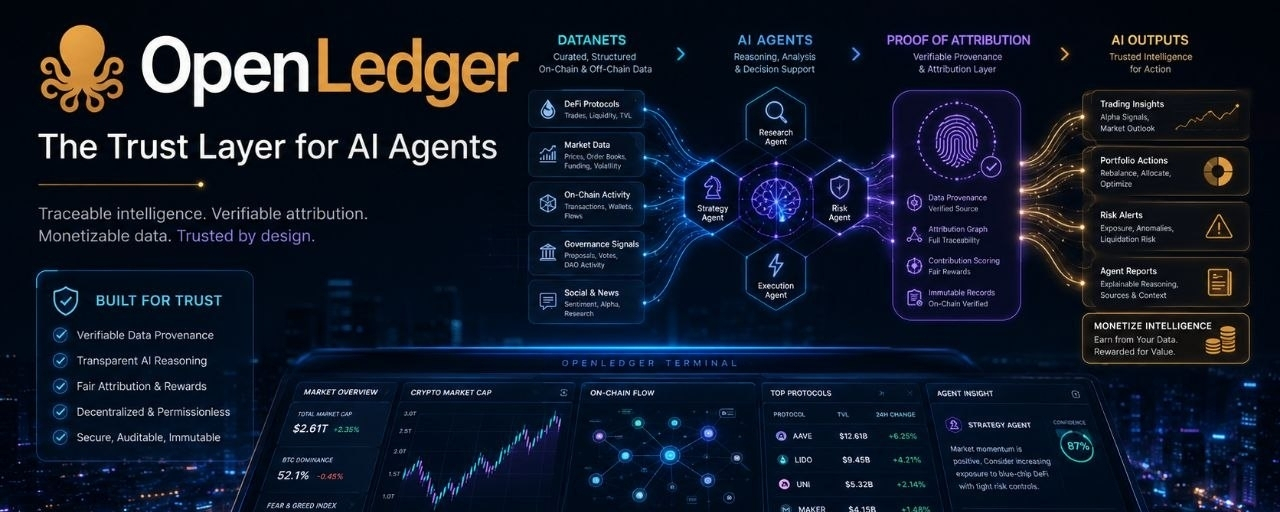
تضع OpenLedger نفسها كبلوكشين ذكاء اصطناعي حيث تصبح البيانات والنماذج والعوامل قابلة للتتبع والت monetization من خلال أنظمة مثل Datanets وProof of Attribution. بدلاً من التعامل مع مجموعات البيانات كوقود يمكن التخلص منه، تتعامل OpenLedger معها كأصول اقتصادية يمكن أن تولد قيمة باستمرار عندما تستخدمها النماذج أو العوامل.
وإجمالاً؟ هذا يغيّر تماماً طريقة تفكيري في أنظمة تداول الذكاء الاصطناعي.
في تداول العملات المشفرة التقليدي، غالباً ما يأتي التفوق (edge) من عدم تماثل المعلومات. بعض المتداولين يتفاعلون بسرعة أكبر مع تغييرات الحوكمة. وآخرون يراقبون عمليات الإفراج (unlock)، وتغيّرات السيولة، ومحافظ الحيتان، ونشاط المُدققين (validators)، وتكرارات/تعديلات GitHub، أو التحولات الاجتماعية قبل أن يتسعّر السوق ذلك بالكامل.
غالباً ما تقوم وكلاء الذكاء الاصطناعي اليوم بسرْب بيانات إنترنت عامة مع نسبة نسبٍ ضعيفة. وهذا يخلق مشكلتين:
1. جودة البيانات غير ثابتة.
2. لا أحد يعرف فعلياً أي البيانات أثّرت على المخرجات.
يبدو هيكل Datanet لدى OpenLedger مصمماً تحديداً لحل هذه المشكلة. يمكن للمجتمعات المتخصصة إنشاء طبقات بيانات خاصة بمجال معيّن مثل DeFi، أو الحوكمة، أو أدوات الذكاء الاصطناعي، أو ثغرات/استغلالات الأمن، أو التحليلات على السلسلة. يوضح OpenLedger أن المساهمين يقومون برفع البيانات والتحقق منها داخل Datanets، بينما يتم تتبّع سجلّ كل المساهمات على السلسلة (on-chain).
وهذا مهم لأن وكلاء الذكاء الاصطناعي الجيدين ليسوا في الواقع سوى محركات سياق.
لا ينبغي لوكيل تداول قوي أن يكتفي بالإجابة عن:
> “ما الذي يحدث؟”
يجب أن يجيب:
> “لماذا يحدث ذلك؟ وما هي مجموعات البيانات التي تدعمه؟ ومدى موثوقية تلك المجموعات؟”
وهنا تصبح Proof of Attribution لدى OpenLedger أكثر إثارة للاهتمام مما يدركه الناس. نظام النِسب لديهم يربط مخرجات النموذج بمساهمات بيانات محددة، ويحافظ على سجلات غير قابلة للتغيير لمظاهر التأثير والمنشأ (influence and provenance).
بالنسبة للمطوّرين، يفتح ذلك اقتصاداً مختلفاً تماماً للذكاء الاصطناعي.
تخيّل محللاً في DeFi يقوم باستمرار برفع ملخصات حوكمة عالية الإشارة إلى Datanet. إذا كانت هذه الملخصات تؤثر بشكل متكرر في مخرجات الوكلاء الناجحة، فيمكن للمساهم، نظرياً، أن يستمر في كسب العوائد من الاستخدامات المستقبلية بدلاً من أن يتقاضى مرة واحدة ثم يُنسى. وهذا أقرب إلى امتلاك بنية تحتية رقمية منتِجة بدلاً من بيع المحتوى.
ومن منظور المتداول، يخلق هذا أمراً تفتقر إليه أنظمة الذكاء الاصطناعي بشدة في الوقت الحالي: تقييم الثقة مع المساءلة.
شخصياً، سأثق أكثر في وكيل يعمل بواسطة OpenLedger إذا أظهر:
أي Datanets أثرت على الإجابة،
مدى حداثة البيانات الداعمة،
هل الإشارة (signal) أدّت تاريخياً بشكل جيد،
وما هي المساهمات التي تنتج باستمرار رؤى عالية الجودة.
هذا هو عملياً بداية محطة أبحاث مهيّأة أصلاً للذكاء الاصطناعي (AI-native).
ما يجعل هذا السرد أقوى هو أن السوق الأوسع يتحرك في الاتجاه نفسه. فالأبحاث الحديثة اللامركزية في مجال الذكاء الاصطناعي تستكشف بشكل متزايد التحقق من الاستدلال المبني على البلوك تشين، وأنظمة تنفيذ ذكاء اصطناعي قابلة للتدقيق (auditable)، بدل الاكتفاء بالتوليد “كصندوق أسود”. ملاءمة بنية OpenLedger لهذا التحول طبيعية، لأنها تركز على النِشأة (provenance)، ونِسب المعلومات (attribution)، وقابلية الشرح على مستوى البنية التحتية.
أعتقد أن الناس ما زالوا يقللون من تقدير مدى قيمة الذكاء القابل للتتبّع (traceable intelligence) التي ستصبح عليها.
الإنترنت حوّل الانتباه إلى عائد. والـ Crypto حوّل التنسيق إلى عائد. وقد يحوّل الذكاء الاصطناعي السياق المُثبت (verified context) إلى عائد.
وإذا حدث ذلك، فقد لا يكون أكبر منتج لدى OpenLedger مجرد نماذج ذكاء اصطناعي. بل قد يصبح طبقة الثقة التي يعتمد عليها وكلاء الذكاء الاصطناعي عندما تحدث الأموال والأتمتة والقرارات كلها على السلسلة 🤝