تكنولوجيا الذكاء الاصطناعي تتطور أسرع من معظم الناس اللي يقدروا يتابعوا بشكل صحيح. كل أسبوع، أدوات جديدة تطلع، وكلاء جدد يطلقوا، ونماذج جديدة تصبح جزء من العمل اليومي. بس ورا هالتقدم، في مشكلة أهدأ ما تحظى دائماً بالاهتمام الكافي. الذكاء الاصطناعي يعتمد على البيانات، والنماذج، والمساهمة البشرية، ومع ذلك كثير من الناس والمصادر اللي ورا هالقيمة تظل تقريباً غير مرئية. OpenLedger تدخل هالمجال بفكرة واضحة: الذكاء الاصطناعي ما لازم يكون قوي بس؛ لازم كمان يكون قابل للتتبع، قابل للاستخدام، ومرتبط بقيمة حقيقية. OpenLedger تصف نفسها رسمياً كـ Blockchain ذكاء اصطناعي مصممة لفتح السيولة وتحقيق الأرباح من البيانات، النماذج، والوكلاء.
تلك الفكرة مهمة لأن الذكاء الاصطناعي لم يعد يتعلق فقط ببناء أنظمة أكبر. السؤال الحقيقي الآن هو الملكية: من وفّر البيانات؟ من حسّن النموذج؟ من أنشأ الوكيل الذي يؤدي عملاً مفيدًا؟ في كثير من أنظمة الذكاء الاصطناعي التقليدية، يصعب رؤية هذه الإجابات. يحدث كل شيء خلف أبواب مغلقة، وغالبًا ما يَخفي المنتج النهائي سلسلة المساهمات. يحاول OpenLedger إظهار تلك السلسلة للعلن. لا يعامل البيانات كشيء سلبي. بل يعامل البيانات كأصلٍ يمكنه حمل قيمة عندما يُستخدم بشكل صحيح.
لهذا السبب يشعر المشروع بأنه ملائم في الوقت الحالي. العالم يتجه نحو وكلاء الذكاء الاصطناعي والنماذج المتخصصة والعمل الرقمي الآلي. وستحتاج هذه الأنظمة إلى بنية تحتية موثوقة. لن يكتفِ الناس بسؤال ما إذا كانت نتيجة الذكاء الاصطناعي مفيدة؛ بل سيطرحون أيضًا أسئلة حول مصدرها وكيف تم بناؤها وما إذا تم الاعتراف بالمساهمين. هنا يصبح البلوك تشين أكثر من مجرد مصطلح رائج. وفي هذه الحالة، يمكن أن يعمل كسجلّ للمساهمة والاستخدام والملكية.
نهج OpenLedger مثير للاهتمام لأنه يركز على الاحتياجات الخاصة بالذكاء الاصطناعي بدل التصرف كبلوك تشين عام يحاول ملاءمة كل حالة استخدام محتملة. تتناول المواد الرسمية أدوات مثل Datanets وModel Factory وAI Studio وProof of Attribution، وكلها مرتبطة بالهدف الأوسع المتمثل في جعل الذكاء الاصطناعي أكثر شفافية وقابلية للتسعير. وبكلمات بسيطة، الفكرة هي مساعدة الناس على المساهمة بالبيانات وبناء النماذج وإنشاء تطبيقات ذكاء اصطناعي بطريقة يمكن فيها تتبع مدخلاتهم.
بالنسبة لمستخدم عادي، قد يبدو هذا تقنيًا في البداية. لكن الجانب الإنساني سهل الفهم. تخيّل قضاء وقت في بناء مجموعة بيانات، أو تحسين نموذج، أو تدريب نظام ذكاء اصطناعي لمجال محدد، ثم رؤية هذا العمل يختفي داخل منتج أكبر دون أي تقدير. هذا الشعور شائع في العالم الرقمي. يحاول OpenLedger معالجة هذه الفجوة عبر ربط المساهمة بنسبة/إسناد العمل. إنه يمنح المحادثة شكلًا عمليًا أكثر.
جزء “السيولة” أيضًا مهم. في الأسواق التقليدية، تعني السيولة أن الأصل يمكنه التحرك أو أن يُستخدم أو يُتبادل أو يُقيَّم بسهولة أكبر. يطبّق OpenLedger هذا التفكير على أصول الذكاء الاصطناعي. لا ينبغي أن تبقى البيانات والنماذج والوكلاء محبوسة داخل أنظمة مغلقة. إذا كانت تُنشئ قيمة، فيجب أن تكون هناك طريقة لتلك القيمة كي تتداول. لا يعني هذا أن كل قطعة بيانات ستصبح مربحة بين ليلة وضحاها. بل يعني أن البنية التحتية تُصمَّم بحيث يكون للمساهمة مسار أوضح نحو الاعتراف والمكافأة المحتملة.
ما يجعل هذا الاتجاه يبدو راهنًا هو صعود النماذج والوكلاء الأصغر حجمًا والأكثر تخصصًا. النماذج العامة الكبيرة مفيدة، لكن كثيرًا من الصناعات تحتاج إلى ذكاء مُركّز. قد يحتاج أداة للرعاية الصحية أو مساعدًا ماليًا أو نموذجًا للبحث القانوني أو وكيل دعم العملاء جميعها إلى بيانات مختلفة ومعايير أداء مختلفة. يتناسب توجه OpenLedger مع هذا التحول لأنه ينظر إلى الذكاء الاصطناعي كمنظومة بيئية، وليس كمنتج واحد فقط.
ومع ذلك، سيتوقف التقدم الحقيقي على التنفيذ. الأفكار الجيدة في البلوك تشين والذكاء الاصطناعي ليست كافية وحدها. يحتاج المستخدمون إلى أدوات بسيطة، ويحتاج البنّاؤون إلى أنظمة موثوقة، ويحتاج المساهمون إلى الثقة. إذا تمكن OpenLedgImagine من جعل هذه العملية عملية، فقد تصبح جزءًا من حركة أكبر نحو ذكاء اصطناعي أكثر انفتاحًا ومسؤولية.
في جوهره، يخاطب OpenLedger حقيقة بسيطة: يجب ألا ينمو الذكاء الاصطناعي عبر إخفاء الأشخاص والبيانات التي تجعل منه مفيدًا. قد لا ينتمي مستقبل الذكاء الاصطناعي فقط إلى أولئك الذين يبنون أكبر النماذج. بل قد ينتمي أيضًا إلى الأشخاص الذين يستطيعون جعل المساهمة مرئية وقابلة للقيّمة وعادلة.


مقالة
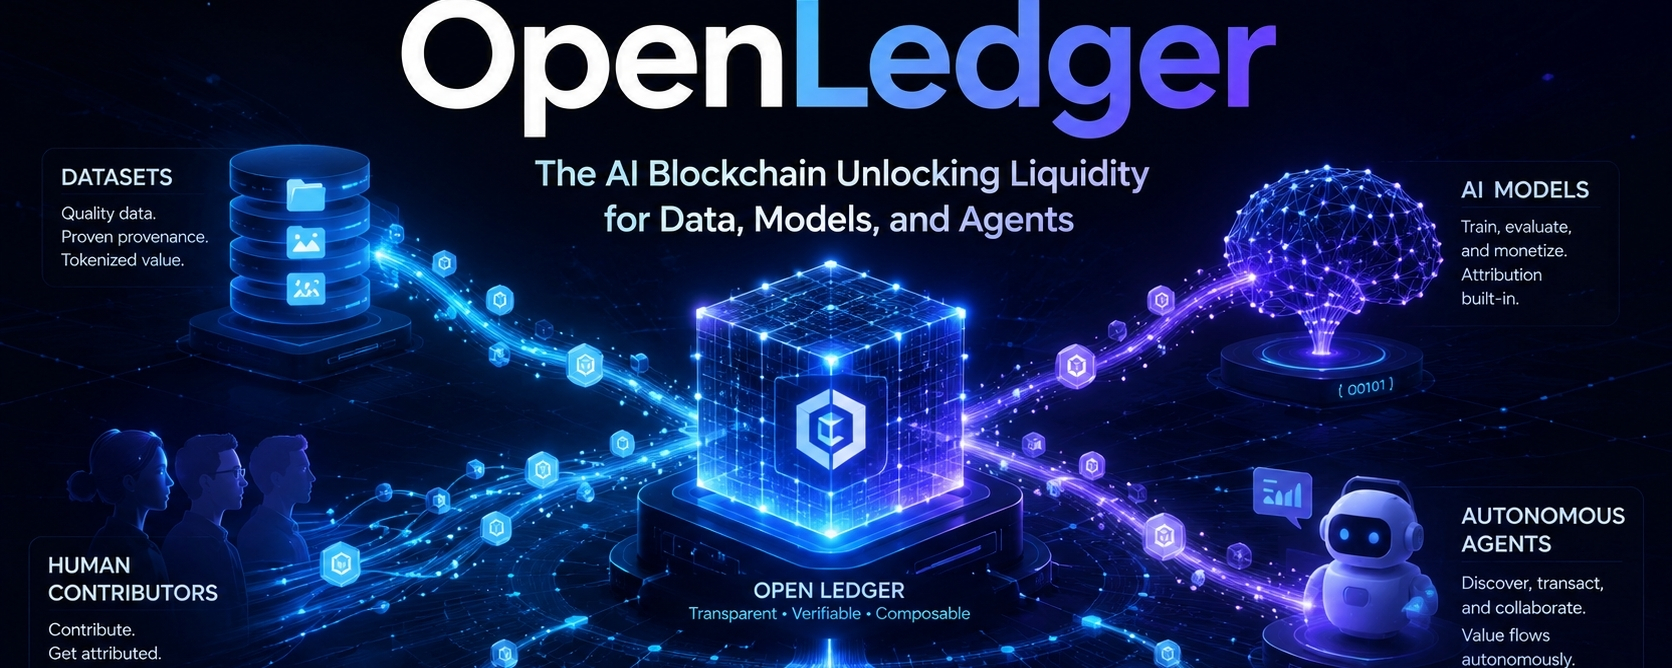
OpenLedger: Blockchain الذكاء الاصطناعي اللي يفتح السيولة للبيانات، النماذج، والوكلاء
إخلاء مسؤولية: يتضمن آراء جهات خارجية. لا تُعدّ نصيحة. يُمكن استخدام Binance AI دون أي ضمان. اطلع على الشروط والأحكام.