

حبيبي، خليني أقول لك شغلة من البداية - لما تنظر لهالأنظمة، أول شي تخطر على بالك "كل شي تحت السيطرة، قواعد صارمة، قيود..." بس إذا نظرت أعمق، رح تفهم إنه الوضع مو فوضى، بل محاولة لبناء هيكل متعمد - بالضبط.
إذا بقول لك الحقيقة من قلبي.... الطريقة اللي بقرأ فيها @OpenLedger التوثيق، بجملة واحدة - مو بس ذكاء صناعي أو منصة بيانات، بل تجربة كاملة حول كيف البيانات ممكن تكون "أصل مكتسب". هلا خلينا نفصل هالموضوع لأنه إذا جمعت كل شي، ما رح ينفهم برأسك - مستحيل ينفهم.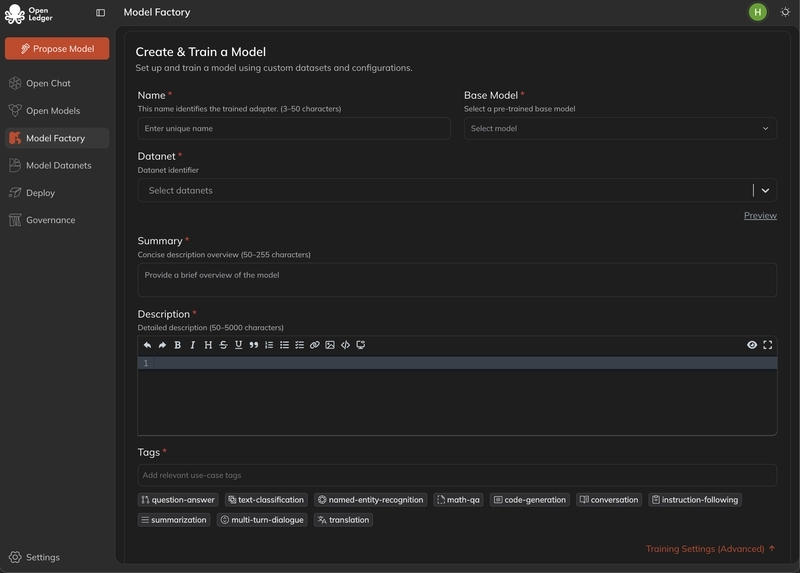
أولًا تأتي طبقة المساهمة من Datanets.
أكثر شيء مدهش هنا هو القيود. نصوص، صور، صوت—لا يمكنك خلط كل شيء. يبدو الأمر غريبًا قليلًا، لأننا عندما نتحدث عن Web3، غالبًا نفكر في كل شيء بلا إذن. لكن هنا العكس—تنسيق صارم، وتحقق صارم. حد 10 ميغابايت يوميًا، و20 ملفًا—يبدو هذا صغيرًا أيضًا، لكن في الواقع هذا ليس للتحكم في البريد المزعج، بل محاولة للحفاظ على نسبة الإشارة إلى الضجيج صحيحة. لأنه إذا كان غير محدود، سيساهم الجميع، لكن سيكون من الصعب العثور على قيمة.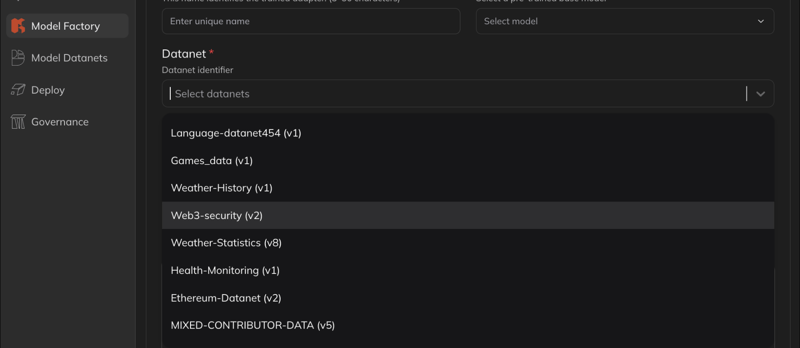
شيء آخر يبدو مضحكًا قليلًا—نظام لوحة المتصدرين.
ربما تفكر: "كلما رفعت أكثر سأصبح أعلى"—لكن لا، ليس أبدًا. هنا، ليست الكمية هي ما يهم، بل معدل القبول. أعني، إذا أعطيت 10 بيانات خاطئة، قد يظل غرورك سعيدًا، لكن النظام لن يهتم بك. قاسٍ قليلًا، لكنه عادل. والجزء المثير للاهتمام هو أن الملفات المرفوضة لا تقلل التصنيف. هذا تصميم صحي بشكل غريب. لأن التجريب يُشجَّع هنا، لا المساهمة المدفوعة بالخوف.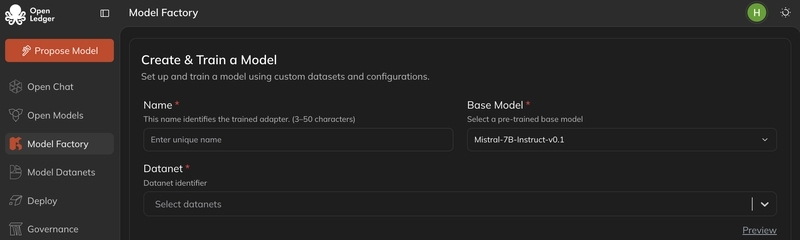
إذًا تأتي ميكانيكا ModelFactory.
وهذه في الحقيقة أكثر أجزاء OpenLedger جدية. إنها تغيّر تمامًا أجواء المكان. إنهم يحاولون تحويل الضبط الدقيق للـ LLM إلى سير عمل يقوده واجهة بدلًا من إبقائه مجرد أداة بحث. هذا يعني أنك لا تحتاج أن تكون محاربًا في ساحة الطرفية. معدل التعلّم، حجم الدفعة، الحقبة—كل شيء يمكن تعديله بصريًا. للوهلة الأولى يبدو الأمر—حسنًا، مناسبًا للمبتدئين، لكن في الواقع توجد فكرة أعمق وراء ذلك—إضفاء ديمقراطية على تطوير الذكاء الاصطناعي دون فقدان السيطرة.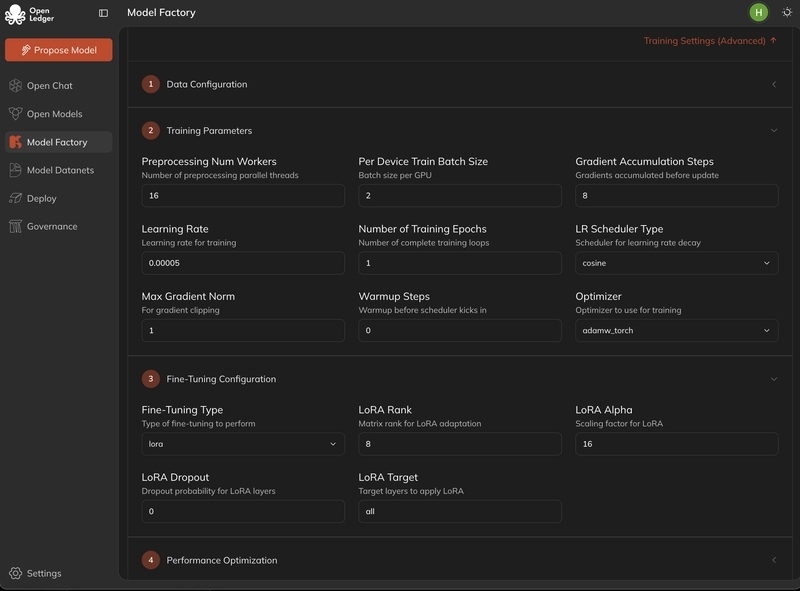
إن دعم LoRA وQLoRA هنا خطوة عملية. لأن الضبط الدقيق الكامل مكلف في واقعنا اليوم. لذلك يسيرون في مسار تكييف خفيف. لوحة في الوقت الحقيقي وتفاعل بعد التدريب—وهذا الأمر مثير للاهتمام جدًا، لأنهم يريدون جعل تدريب النماذج حلقة مستمرة دون نقطة نهاية. هذا يعني تدريب ⇦ اختبار ⇦ تفاعل ⇦ تحسين. 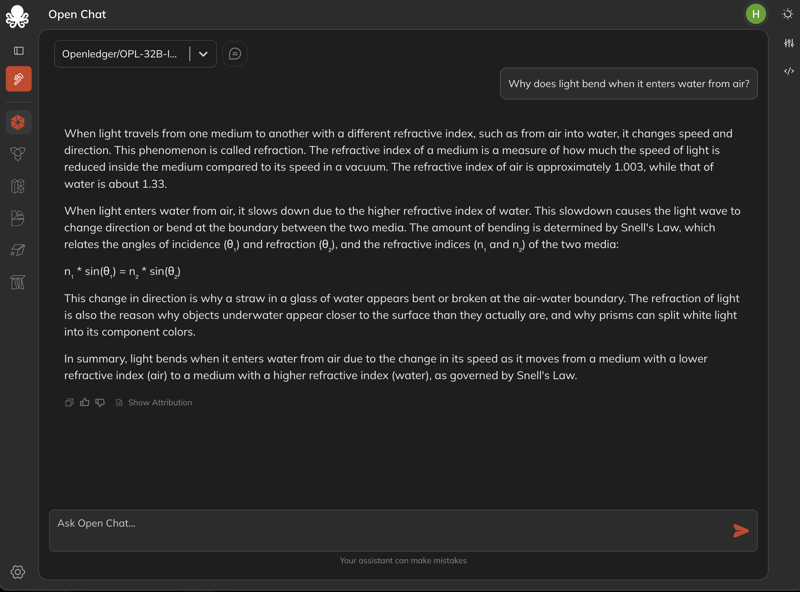
الآن دعنا نتحدث عن الـ LLMs المدعومة.
Deepseek وMistral وQwen وسلسلة LLaMA—كل الأنظمة البيئية المفتوحة الكبيرة موجودة هنا. وحتى GPT-2 وBLOOM وChatGLM مدعومة. في البداية قد يبدو أنهم أدرجوا كل شيء، لكن الحقيقة أنها استراتيجية لتغطية النظام البيئي. لأن إبقاء نماذج الصفوة فقط سيجعلك محدودًا. أما الدعم الواسع فيعني مساحة كبيرة للتجربة.
والآن دعني أخبرك بجزء مضحك
تتخيل لي صورة عندما أرى كل هذا النظام—مطبخ منضبط جدًا، حيث لا يمكن لأحد أن يرمِي المكونات عشوائيًا. لكن عندما ينتهي الطبخ، يمكن للجميع التذوق والتقييم. هذا يعني أنك لا تستطيع البقاء هنا فقط بالهتافات الطيبة، حتى لو كنت تريد ذلك.
الجزء الأخير من تعليمات الوكيل هو في الحقيقة الأكثر تقليلًا في تقديره.
لأن هنا يُقال إنه للاستعلامات العميقة، يمكن الحصول على إجابات ديناميكية باستخدام عنوان URL الخاص بـ GitBook. ليست في الأساس وثائق ثابتة، بل هي نظام معرفة يمكن الاستعلام عنه.
الآن إذا فكرت في ذلك بشكل عام، يتضح شيء واحد..... @OpenLedger na الحقيقة تقع بين ضغطين: من ناحية، اللامركزية + المساهمة المفتوحة، ومن ناحية أخرى، التحقق الصارم + هيكل مضبوط. ليس من السهل جمع هذين الأمرين معًا. لكن إذا كان التوازن صحيحًا، فيمكن أن يخلق اقتصادًا حقيقيًا للبيانات بدلًا من الضجيج. وبصراحة، هذه هي النقطة التي تصبح فيها المسألة مثيرة للاهتمام—هل ستكون البيانات فعلًا أصل المستقبل، أم أننا نحاول فقط حل مشكلة قديمة للتحقق باسم جديد؟
لست متأكدًا إن كان هناك رد نهائي الآن. لكن كطبقة للتجربة، لا يستحق تجاهلها... لكن حقًا🚀