#openledger $OPEN $BTC #لماذا غيرت OpenLedger نظرتي إلى بنية الذكاء الاصطناعي
كنت أختبر منصات الذكاء الاصطناعي التي يتحدث عنها الناس على Crypto Twitter قبل بضعة ليالٍ. كانت معظمها مربكة بالنسبة لي. كانت هناك منصة تحتاج مني إعدادها بطريقة معينة. ومنصة أخرى كانت تتطلب مني معرفة البرمجة. بعض المنصات بدت جيدة في البداية، لكنها أصبحت معقدة بعد بضع دقائق.
جعلتني هذه التجربة أدرك شيئًا: الذكاء الاصطناعي لا يزال يبدو صعب الفهم لأنه معقد. ربما لهذا السبب لفتت OpenLedger انتباهي. لم يكن ذلك لأنهم كانوا يتحدثون بصوت أعلى. ولكن لأنهم كانوا يركزون على بناء أساس الذكاء الاصطناعي بدلاً من مجرد الحديث عن مدى روعته.
كلما تعمقت في مشروع OpenLedger، لاحظت شيئًا. معظم الناس يستخدمون فقط منتجات الذكاء الاصطناعي. يرون مساعدًا ذكيًا، أو أداة ذكاء اصطناعي، أو وكيل ذكاء اصطناعي. تقريبًا لا يتحدث أحد عن الأنظمة التي تعمل خلف تلك المنتجات. ذلك الجزء المخفي هو المكان الذي بدأت فيه OpenLedger تشعر بالاختلاف بالنسبة لي.
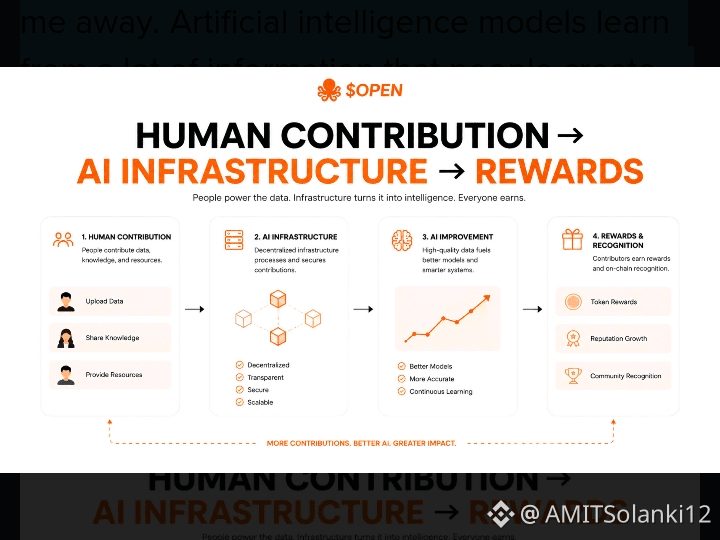
عندما قرأت لأول مرة عن نظام إثبات الانتماء الخاص بهم، كانت الفكرة منطقية بالنسبة لي. تتعلم نماذج الذكاء الاصطناعي من الكثير من المعلومات التي ينشئها الناس. بمجرد أن تصبح تلك النماذج ذات قيمة، غالبًا ما يتم نسيان الأشخاص الذين أنشأوا تلك المعلومات. لا يبدو أن هذا عادل عندما تفكر في الأمر. تحاول OpenLedger بناء نظام حيث يمكن تتبع الأشخاص الذين يساهمون ومكافأتهم بدلاً من نسيانهم.