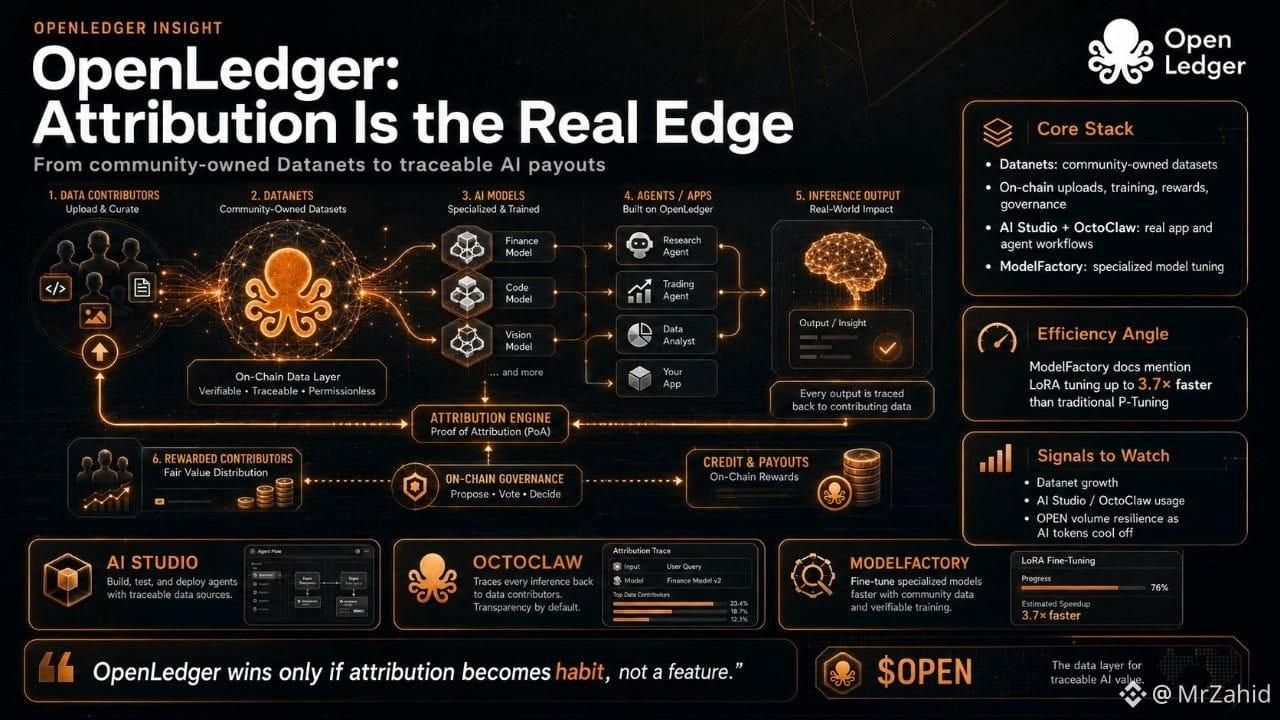
خلصت للتو من مراجعة وثائق OpenLedger والموقع، والجزء اللي لفت انتباهي مو العرض المعتاد "AI x blockchain". بل هو طبقة النسبة. OpenLedger تبني حول Datanets، مجموعات بيانات تمتلكها المجتمع حيث التحميلات، تدريب النماذج، نقاط المكافآت، والحوكمة موجودة على السلسلة. هذا مهم لأن قيمة الذكاء الاصطناعي عادة ما تتسرب إلى الأعلى: المستخدمون ينشئون البيانات، النماذج تمتصها، المنصات تستفيد منها، والمساهمون يحصلون على المشاعر.
ما تفعله OpenLedger هو قلب منطق الدفع. إذا كان Proof of Attribution يمكنه تتبع أي بيانات أثرت على استنتاج، فإن البيانات تصبح أصل منتج قابل للتداول، وليس فقط وقود خام. لهذا السبب، سأراقب OpenLedger أقل مثل مخطط ميم وأكثر مثل فرصة بنية تحتية: يجب أن يأتي الطلب من البناة الذين يحتاجون إلى بيانات موثوقة، نماذج متخصصة، وسير عمل الوكلاء، وليس فقط ضجة التجزئة.
منطقي في التداول بسيط: لا ألاحق الشموع الخضراء بعمى. سأتابع ثلاثة إشارات أولاً: نمو Datanet، الاستخدام الحقيقي للتطبيق من AI Studio/OctoClaw، وما إذا كان حجم OPEN يبقى صحي بينما تبرد الرموز الأخرى للذكاء الاصطناعي. الوثائق حتى تدعي أن ضبط LoRA من ModelFactory يمكن أن يكون أسرع بـ 3.7 مرة من P-Tuning التقليدي، وهو زاوية كفاءة حقيقية.
رأي مثير: OpenLedger تفوز فقط إذا أصبحت النسبة عادة، وليس ميزة. 🚀
المصادر المستخدمة: وثائق OpenLedger تصف Datanets، الإجراءات على السلسلة، النسبة، والحوكمة؛ كما أن الموقع يبرز OctoClaw وAI Studio، بينما تذكر معايير ModelFactory أنها تصل إلى 3.7x أسرع في ضبط LoRA.
@OpenLedger $OPEN #OpenLedger