لماذا أعتقد أن OpenLedger تعيد للذكاء الاصطناعي إحساسه بالمسؤولية
لقد كنت أتابع مجال الذكاء الاصطناعي لفترة كافية لأشعر بمدى تكرار القصة. كل مشروع يتحدث عن وكلاء أسرع، نماذج أكثر ذكاءً، أتمتة أفضل، ومخرجات أنظف. لكنني أستمر في طرح سؤال مختلف على نفسي: ماذا يحدث خلف المخرجات؟ من أنشأ البيانات، من شكل النموذج، من ساهم في عملية التدريب، ومن يحصل على المكافأة عندما يبدأ ذلك الذكاء في خلق قيمة؟
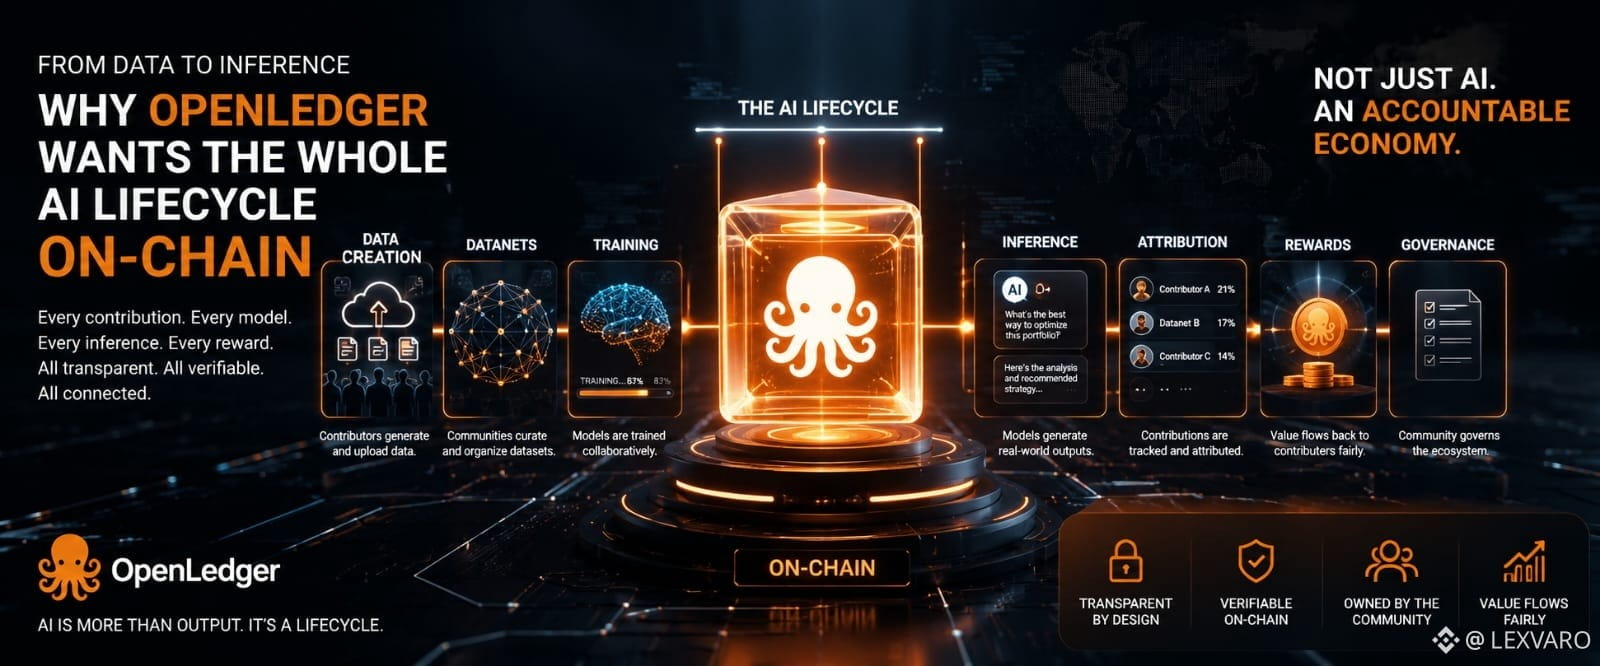
لهذا السبب يبدو OpenLedger مثيرًا للاهتمام بالنسبة لي. إنه لا يحاول فقط جعل الذكاء الاصطناعي يبدو قويًا من الخارج. إنه يحاول جعل الدورة الكاملة مرئية: البيانات، الشبكات البيانية، التدريب، الاستدلال، النسبة، المكافآت، والحكم. أحب ذلك لأن مخرجات الذكاء الاصطناعي لا ينبغي أن تبدو كإجابات عشوائية تتطاير في الهواء. يجب أن يكون لديها نسب، وسياق، وأثر اقتصادي.
لا زلت متشككًا لأن الأنظمة المفتوحة دائمًا ما تجذب الرسائل غير المرغوب فيها، والمساهمات ذات الجودة المنخفضة، والألعاب، ومشاكل الحكم. لكن الذكاء الاصطناعي المركزي يخفي تلك المشاكل أيضًا. على الأقل OpenLedger يجلب الأجزاء الفوضوية إلى السطح.
بالنسبة لي، السؤال الحقيقي بسيط: إذا كان الذكاء الاصطناعي سيوفر قيمة، ألا يجب أن تكون الأشخاص والبيانات وراء تلك القيمة مرئية أيضًا؟
#OpenLedger @OpenLedger $OPEN
لقد كنت أتابع مجال الذكاء الاصطناعي لفترة كافية لأشعر بمدى تكرار القصة. كل مشروع يتحدث عن وكلاء أسرع، نماذج أكثر ذكاءً، أتمتة أفضل، ومخرجات أنظف. لكنني أستمر في طرح سؤال مختلف على نفسي: ماذا يحدث خلف المخرجات؟ من أنشأ البيانات، من شكل النموذج، من ساهم في عملية التدريب، ومن يحصل على المكافأة عندما يبدأ ذلك الذكاء في خلق قيمة؟
لهذا السبب يبدو OpenLedger مثيرًا للاهتمام بالنسبة لي. إنه لا يحاول فقط جعل الذكاء الاصطناعي يبدو قويًا من الخارج. إنه يحاول جعل الدورة الكاملة مرئية: البيانات، الشبكات البيانية، التدريب، الاستدلال، النسبة، المكافآت، والحكم. أحب ذلك لأن مخرجات الذكاء الاصطناعي لا ينبغي أن تبدو كإجابات عشوائية تتطاير في الهواء. يجب أن يكون لديها نسب، وسياق، وأثر اقتصادي.
لا زلت متشككًا لأن الأنظمة المفتوحة دائمًا ما تجذب الرسائل غير المرغوب فيها، والمساهمات ذات الجودة المنخفضة، والألعاب، ومشاكل الحكم. لكن الذكاء الاصطناعي المركزي يخفي تلك المشاكل أيضًا. على الأقل OpenLedger يجلب الأجزاء الفوضوية إلى السطح.
بالنسبة لي، السؤال الحقيقي بسيط: إذا كان الذكاء الاصطناعي سيوفر قيمة، ألا يجب أن تكون الأشخاص والبيانات وراء تلك القيمة مرئية أيضًا؟
#OpenLedger @OpenLedger $OPEN